


Мисконфигурации контейнеров: где заканчивается изоляция и начинается риск
Введение
Контейнеризация стала стандартным способом поставки и запуска приложений. Она ускоряет разработку, упрощает масштабирование и помогает воспроизводимо развертывать сервисы в разных средах.
Контейнеры и виртуальные машины — два распространенных способа изоляции приложений, но устроены они по‑разному. Виртуальные машины изолированы друг от друга на уровне гипервизора и имеют собственные экземпляры операционной системы и ядра. Контейнеры же используют общее ядро Linux‑хоста. Изолированным остается не ядро, а окружение процесса — его файловая система, сеть, идентификаторы процессов, пользователи и доступные ресурсы.
Поэтому изоляция контейнера зависит в том числе от параметров его запуска, а значит, безопасность контейнеров — это не только поиск уязвимостей в образах. Не менее важно контролировать конфигурацию среды исполнения: от какого пользователя запускается процесс, какие capabilities (привилегии) ему доступны, какие каталоги смонтированы внутри контейнера и может ли этот контейнер взаимодействовать с ресурсами хоста.
Небезопасные настройки встречаются нередко: по данным BI.ZONE SOC, в среднем в инфраструктуре крупных российских компаний находится 12 тысяч контейнеров, и каждый восьмой содержит мисконфигурации — это около 12,5% от общего числа.
В этой статье разберем, какие настройки наиболее критичны для безопасности контейнерных сред на основе Docker, почему эти настройки опасны при неправильной конфигурации и как BI.ZONE EDR помогает обнаруживать такие отклонения на Linux‑узлах.
Контейнеры и их изоляция
Контейнер — изолированный процесс или группа процессов, запущенных в хостовой операционной системе. Внутри контейнера приложение получает собственное окружение: файловую систему, сетевые интерфейсы, список процессов и набор переменных окружения. Но ядро Linux при этом остается общим с хостом и другими контейнерами.
Важно различать несколько компонентов контейнерной среды:
- Образ — неизменяемый шаблон, содержащий приложение, библиотеки, зависимости и базовую файловую систему.
- Контейнер — запущенный экземпляр образа с собственным состоянием, настройками сети, томами и ограничениями.
- Контейнерный рантайм (container runtime) — программный слой, который создает и запускает контейнеры.
- Хост — Linux‑система, в которой работают рантайм и контейнеры. Именно хост предоставляет контейнерам ядро, процессор, память, сеть и хранилище.
Изоляция контейнера не является единым механизмом. Она складывается из нескольких уровней защиты, каждый из которых ограничивает свою часть окружения процесса.
Пространства имен (namespaces) ограничивают, какие ресурсы видит процесс: процессы (PID), сеть (network), файловую систему и точки монтирования (mount), пользователей (user), IPC и имя хоста (UTS). Использование пространств имен хоста — например, hostPID или hostNetwork — ослабляет изоляцию и должно быть обоснованным исключением.
Контроль ресурсов (cgroups) распределяет и ограничивает ресурсы: CPU, память, ввод‑вывод и число процессов. Он защищает узел и соседние контейнеры от исчерпания ресурсов, например, из‑за ошибки приложения или запуска майнера.
Linux capabilities делят полномочия root на отдельные привилегии. Безопасный подход — удалить все capabilities и добавлять только те, без которых приложение не работает. Наиболее рискованны CAP_SYS_ADMIN, CAP_SYS_MODULE, CAP_SYS_PTRACE, CAP_NET_RAW и CAP_NET_ADMIN. Режим privileged выдает контейнеру чрезмерные права и для прикладных сервисов почти всегда недопустим.
Seccomp ограничивает доступные процессу системные вызовы и снижает риск эксплуатации ядра. Для большинства контейнеров подходит профиль RuntimeDefault.
AppArmor и SELinux дополнительно ограничивают доступ процессов к файлам, устройствам и другим ресурсам. Даже при компрометации приложения они не позволяют ему выйти за пределы заранее определенной политики.
Вместе эти механизмы определяют, что процесс внутри контейнера может видеть и какие действия может выполнять. Такая архитектура делает контейнеры легкими и удобными, но требует внимательной настройки. Если контейнер запущен с избыточными привилегиями, имеет доступ к файловой системе хоста или сокету контейнерного рантайма, граница изоляции становится существенно слабее. Компрометация приложения в таком контейнере может дать злоумышленнику путь к секретам, соседним рабочим нагрузкам, Kubernetes‑кластеру или самому узлу.
Граница контейнера определяется не фактом его запуска, а совокупностью настроек. Образ определяет содержимое приложения. Рантайм создает контейнер и передает ему параметры безопасности. Ядро хоста применяет namespaces, cgroups, capabilities и политики доступа. Соответственно, ошибка может появиться на любом уровне: в Dockerfile, параметрах запуска, Kubernetes‑манифесте, настройках рантайма или конфигурации Linux‑узла.
Чем больше прав и ресурсов хоста получает контейнер, тем менее значимой становится его изоляция.
Контейнерные рантаймы
Контейнерный рантайм — программный слой, который получает описание контейнера, создает контейнер из образа и запускает процессы с нужными настройками изоляции. Именно рантайм применяет параметры, которые во многом определяют безопасность рабочей нагрузки: namespaces, cgroups, capabilities, профили seccomp, точки монтирования и сетевые настройки.
На практике в инфраструктуре чаще всего встречаются Docker, containerd, CRI‑O и Podman. Они решают похожие задачи, но предназначены для разных сценариев эксплуатации.
Docker — наиболее распространенный набор инструментов для сборки образов и запуска контейнеров: Docker Engine (сам движок), CLI (командная строка) и API (интерфейс для программного взаимодействия). Docker часто используют в разработке, CI/CD и на серверах с самостоятельными контейнерными приложениями. В Kubernetes Docker Engine обычно не применяется напрямую: для запуска контейнеров он использует containerd. Критический риск связан с доступом к docker.sock: получив его, злоумышленник может управлять контейнерами и фактически приобретает административные права на узел.
containerd — специализированный рантайм для создания, запуска и управления жизненным циклом контейнеров. Это один из основных вариантов для production‑кластеров Kubernetes, где kubelet взаимодействует с рантаймом через CRI. Доступ к сокету containerd или CRI‑интерфейсу также требует контроля, поскольку через этот доступ можно управлять контейнерами на узле.
CRI‑O — легковесный рантайм, созданный специально для Kubernetes. Часто используется в экосистеме Red Hat OpenShift. Он реализует только необходимые Kubernetes‑функции, но риски остаются теми же: избыточные привилегии контейнера, доступ к API рантайма и ресурсам хоста.
Podman совместим с привычным Docker CLI, но не использует постоянно работающий центральный демон. Рантайм поддерживает rootless‑режим, при котором контейнеры запускаются без прав root на хосте. Это снижает последствия компрометации, но не отменяет необходимость контролировать монтирования, секреты, права и используемые образы.
Почему контекст рантайма важен при расследовании инцидентов
Для расследования инцидента недостаточно увидеть процесс на Linux‑хосте. Нужно понимать, был ли он запущен внутри контейнера, к какому контейнеру относится, какой образ использует и какие настройки были применены при запуске.
Особенности рантайма определяют, где хранятся метаданные контейнеров, через какие сокеты осуществляется управление и каким образом процесс связан с cgroup и файловой системой контейнера. Без этих данных события с хоста остаются разрозненными: невозможно понять, с чем мы имеем дело — с атакой на сам узел, компрометацией приложения в контейнере или штатной активностью сервиса.
Именно поэтому инструменты расследования, включая EDR‑решение, должны учитывать используемые в инфраструктуре рантаймы: сопоставлять процессы с контейнерным контекстом и отслеживать действия, опасные для конкретной реализации.
Например, BI.ZONE EDR поддерживает мониторинг и инвентаризацию Docker, containerd, Podman и CRI‑O на Linux‑узлах. Это позволяет контролировать контейнерную среду на уровне узла: выявлять параметры запущенных контейнеров, связывать процессы с их контейнерным контекстом и обнаруживать подозрительные обращения к критическим ресурсам рантайма.
В результате специалист по кибербезопасности получает не разрозненные события с хоста, а контекст для оценки риска: какой контейнер выполнял действие, каким рантаймом этот контейнер был создан, какие права получил и может ли его компрометация повлиять на сам узел или другие рабочие нагрузки.
Модель угроз: как развивается атака от контейнера к инфраструктуре
Компрометация контейнера редко становится конечной целью кибератаки. Для злоумышленника это обычно начальная точка: возможность выполнить код в приложении, изучить окружение и найти путь к более ценным ресурсам.
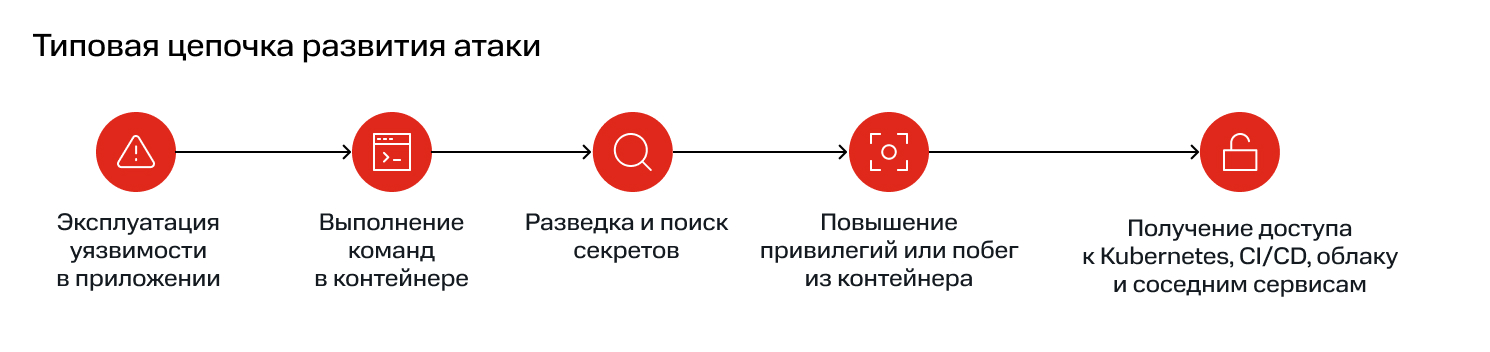
Первоначальный доступ может появиться благодаря уязвимости в веб‑приложении, зависимости с известной CVE, ошибке в конфигурации API, скомпрометированному образу или получению учетных данных разработчика. Если атакующий получил командную оболочку внутри контейнера, он начинает исследовать среду: от имени какого пользователя работает процесс, какие каталоги смонтированы, какие переменные окружения доступны и до каких сервисов можно добраться по сети.
Дальше рассмотрим типичные сценарии развития атаки на примере Docker — самого распространенного рантайма на Linux‑узлах. Многие из описанных рисков актуальны и для containerd, CRI‑O и Podman, но конкретные параметры и конфигурационные файлы у них различаются.
Доступ к секретам
Контейнеры часто содержат чувствительные данные, необходимые приложению для работы: пароли к базам данных, API‑токены, ключи доступа к облачным сервисам, учетные данные систем мониторинга и CI/CD.
Такие данные могут храниться в нескольких местах:
- переменные окружения,
- файлы конфигурации,
- смонтированные Kubernetes Secret,
- токен ServiceAccount,
- подключенные тома,
- метаданные облачной среды.
Особое значение имеет токен ServiceAccount, автоматически монтируемый в Pod. Если для него назначены избыточные права Kubernetes RBAC, атакующий может использовать токен для чтения секретов, создания новых Pod, изменения ресурсов или закрепления в кластере.
Доступ к облачной среде
Docker‑контейнер может получить облачные учетные данные через переменные окружения, конфигурационные файлы, смонтированные тома или сервис метаданных облачного провайдера. Если такие данные обладают широкими правами, компрометация одного приложения позволит атакующему выйти за пределы контейнера: получить доступ к объектному хранилищу, базам данных, очередям или виртуальным машинам.
Секреты не следует включать в образ или передавать через Dockerfile. Их лучше предоставлять контейнеру только во время запуска, ограничивать срок их действия и назначать минимально необходимые IAM‑права. Отдельно следует ограничить доступ контейнеров к сервису метаданных: приложениям, которым облачные учетные данные не требуются, он не нужен.
Доступ к хосту и соседним контейнерам
Контейнер может стать точкой входа для атаки на Docker‑хост. Основные предпосылки — доступ к docker.sock, монтирование каталогов хоста, режим --privileged, избыточные capabilities, а также запуск с --pid=host или --network=host.
Получив контроль над хостом, атакующий способен читать данные и секреты других контейнеров, создавать новые контейнеры, изменять конфигурацию уже существующих, перехватывать трафик, закрепляться через systemd или cron и использовать узел для дальнейшего перемещения по сети.
Даже без выхода на хост злоумышленник, получивший контроль над контейнером, может атаковать соседние сервисы: сканировать внутреннюю Docker‑сеть, обращаться к сервисам без аутентификации или использовать общие тома и учетные данные.
Поэтому доступ контейнера к ресурсам хоста должен быть ограничен и обоснован. BI.ZONE EDR помогает сопоставить подозрительную активность с конкретным контейнером, отследить обращения к ресурсам хоста и выявить попытки использовать Docker для развития атаки.
Доступ к сети
В рамках одного из расширенных реагирований команда BI.ZONE DFIR обнаружила, что контейнер становится точкой входа для атаки на всю инфраструктуру, если не ограничены его сетевые возможности. После компрометации приложения атакующий разворачивает внутри контейнера инструмент для сканирования сети (например, fscan). Без правил сетевой изоляции и ограничений на исходящий трафик злоумышленник может беспрепятственно обнаружить сервисы в смежных сегментах, включая базы данных, работающие на хостовой системе.
Если обнаруженный сервис имеет слабые учетные данные или позволяет выполнять системные команды через встроенные механизмы, злоумышленник может использовать его для перехода с уровня приложения на уровень операционной системы, осуществляя побег из контейнера. Чтобы обеспечить стабильный канал связи, атакующий применяет инструменты для создания сетевых туннелей, а для закрепления в системе — модифицирует файлы профиля пользователя или создает задачи в планировщике, внедряя инструменты скрытого управления (например, GSocket).
В результате скомпрометированный хост превращается в полноценный плацдарм: злоумышленник проводит разведку уже из доверенного сегмента сети, находит критически важные активы и продвигается дальше по инфраструктуре.
Поэтому важно ограничивать сетевые доступы контейнера и запрещать выполнение подозрительных команд. BI.ZONE EDR помогает сопоставить подозрительную сетевую активность (запуск сканеров, попытки создания туннелей) с конкретным контейнером, отследить попытки выхода на хост и выявить признаки закрепления злоумышленника в системе.
Что важно видеть системе мониторинга
Защита контейнерной среды начинается с понимания контекста: какой процесс запущен и внутри какого контейнера, с какими правами, к каким файлам и сетевым ресурсам он обращается. Один и тот же запуск curl, sh или nsenter имеет разный смысл на сервере администрирования и внутри веб‑контейнера, доступного из интернета.
BI.ZONE EDR позволяет связывать события Linux‑узла с контейнерным контекстом и выявлять признаки развития атаки: запуск нетипичных процессов, обращение к секретам и сокетам рантайма, изменение файлов, попытки изменить пространство имен или выполнить действия на хосте. Это помогает обнаружить цепочку целиком — от компрометации приложения до попытки получить контроль над инфраструктурой.
Мисконфигурации контейнеров и их обнаружение
Контейнерная безопасность не сводится к отсутствию CVE в образе. Даже актуальный образ может быть опасен, если контейнер запущен с избыточными привилегиями, получил доступ к ресурсам узла или работает без ограничений на уровне ядра и Kubernetes.
Для каждой конфигурации важно ответить на четыре вопроса:
- Какой риск возникает?
- Как выглядит небезопасная настройка?
- Что следует проверять в инфраструктуре?
- Какие признаки может использовать EDR‑решение для поиска отклонения или активной эксплуатации?
Важно разделять два типа контроля. Первый — инвентаризационный: он отвечает на вопрос, какие контейнеры и параметры запуска уже есть на узле. Второй — поведенческий: он выявляет, что происходит внутри контейнера и на хосте после запуска. Именно сочетание этих подходов помогает не только найти небезопасную конфигурацию, но и вовремя заметить ее использование в атаке.
Ниже разберем типичные мисконфигурации контейнеров и способы их обнаружить на примере решения BI.ZONE EDR.
Небезопасные параметры запуска контейнера
Привилегированные контейнеры
Параметр privileged: true — одна из наиболее опасных настроек контейнера. В таком режиме контейнер получает расширенный набор Linux capabilities, доступ к устройствам хоста и значительно меньше ограничений со стороны seccomp и LSM‑профилей.
Привилегированный контейнер иногда необходим для инфраструктурных компонентов: например, низкоуровневых сетевых плагинов, драйверов хранения или агентов мониторинга. Однако для прикладных сервисов — веб‑приложений, API, очередей, баз данных — такая настройка почти никогда не обоснована.
Пример небезопасной конфигурации:
securityContext:
  privileged: true
Политика безопасности должна запрещать привилегированные контейнеры по умолчанию. Каждое исключение необходимо документировать: определить ответственного сотрудника, срок действия, конкретную причину и компенсирующие меры защиты.
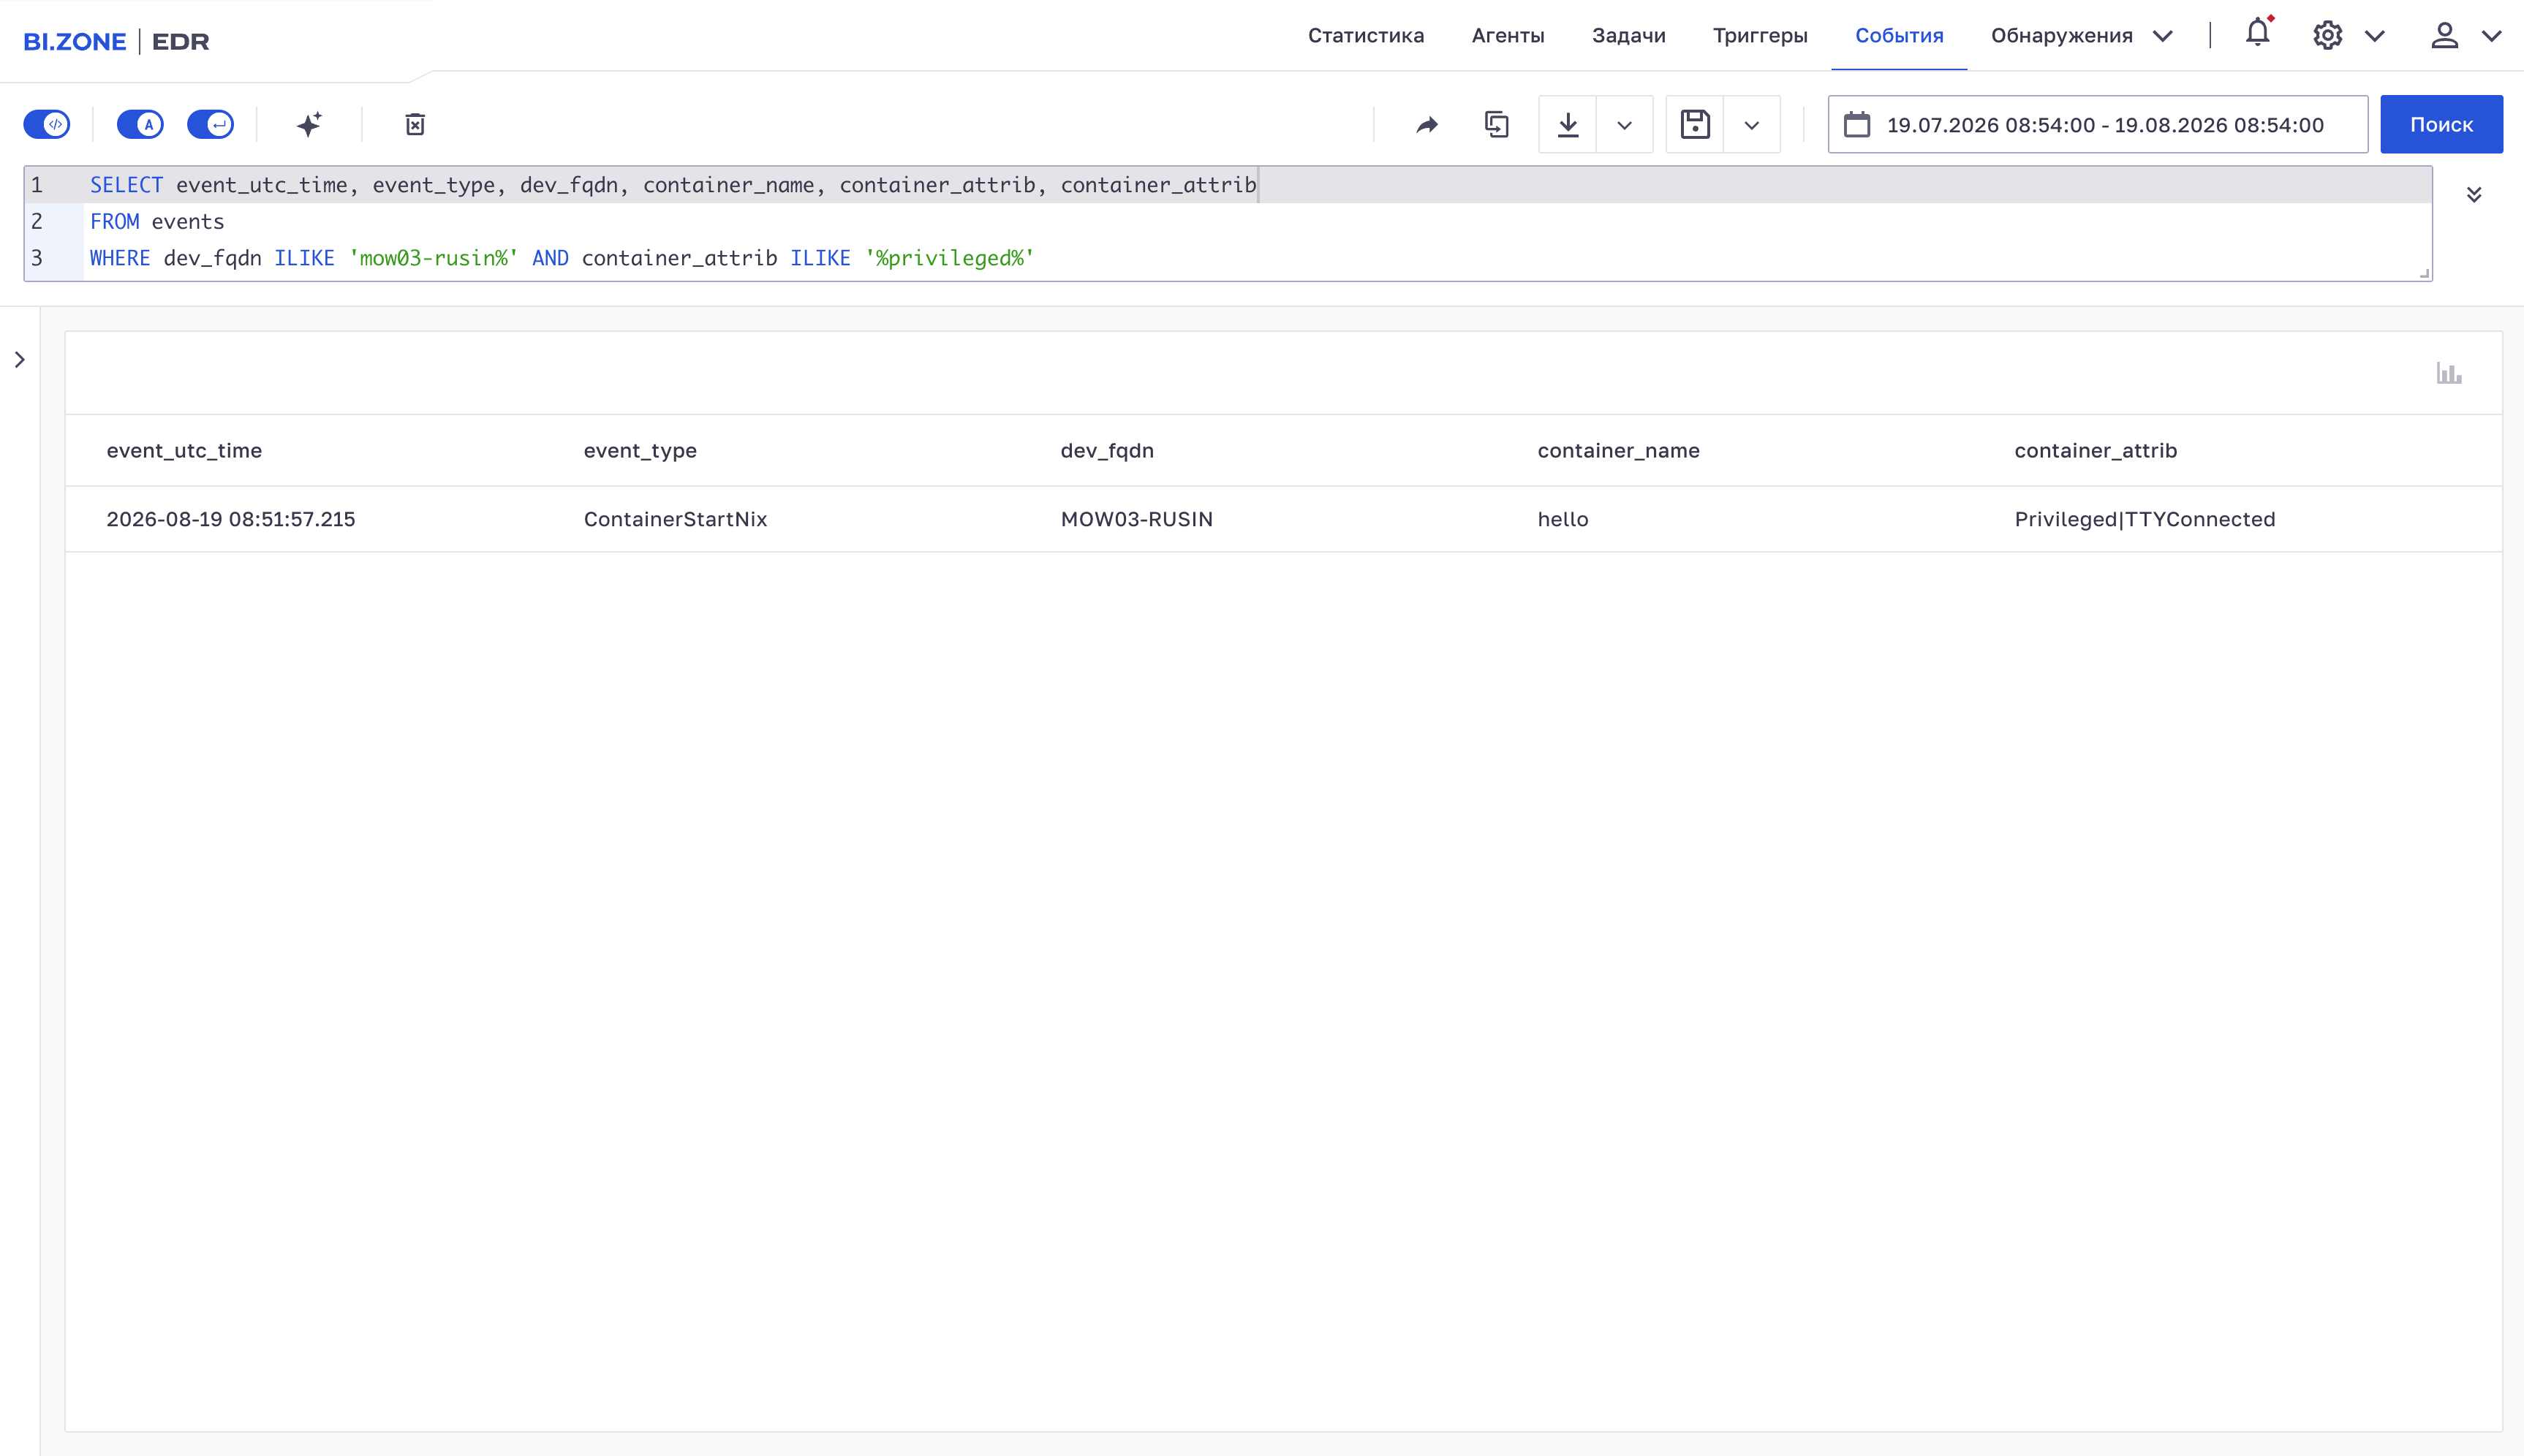
BI.ZONE EDR помогает выявлять уже работающие контейнеры с повышенными привилегиями и связывать эти контейнеры с активностью на узле. Повышенное внимание следует уделять выполнению команд, связанных с монтированием файловых систем, настройкой сети, доступом к устройствам и загрузкой модулей ядра. Если такие действия выполняются из прикладного контейнера, это весомый индикатор компрометации или грубого нарушения безопасной модели эксплуатации.
Избыточные Linux capabilities
Capabilities позволяют выдавать отдельные привилегии вместо полного набора прав root. Это полезный механизм, но он становится источником риска, когда права добавляются «на всякий случай».
Особенно опасны следующие возможности:
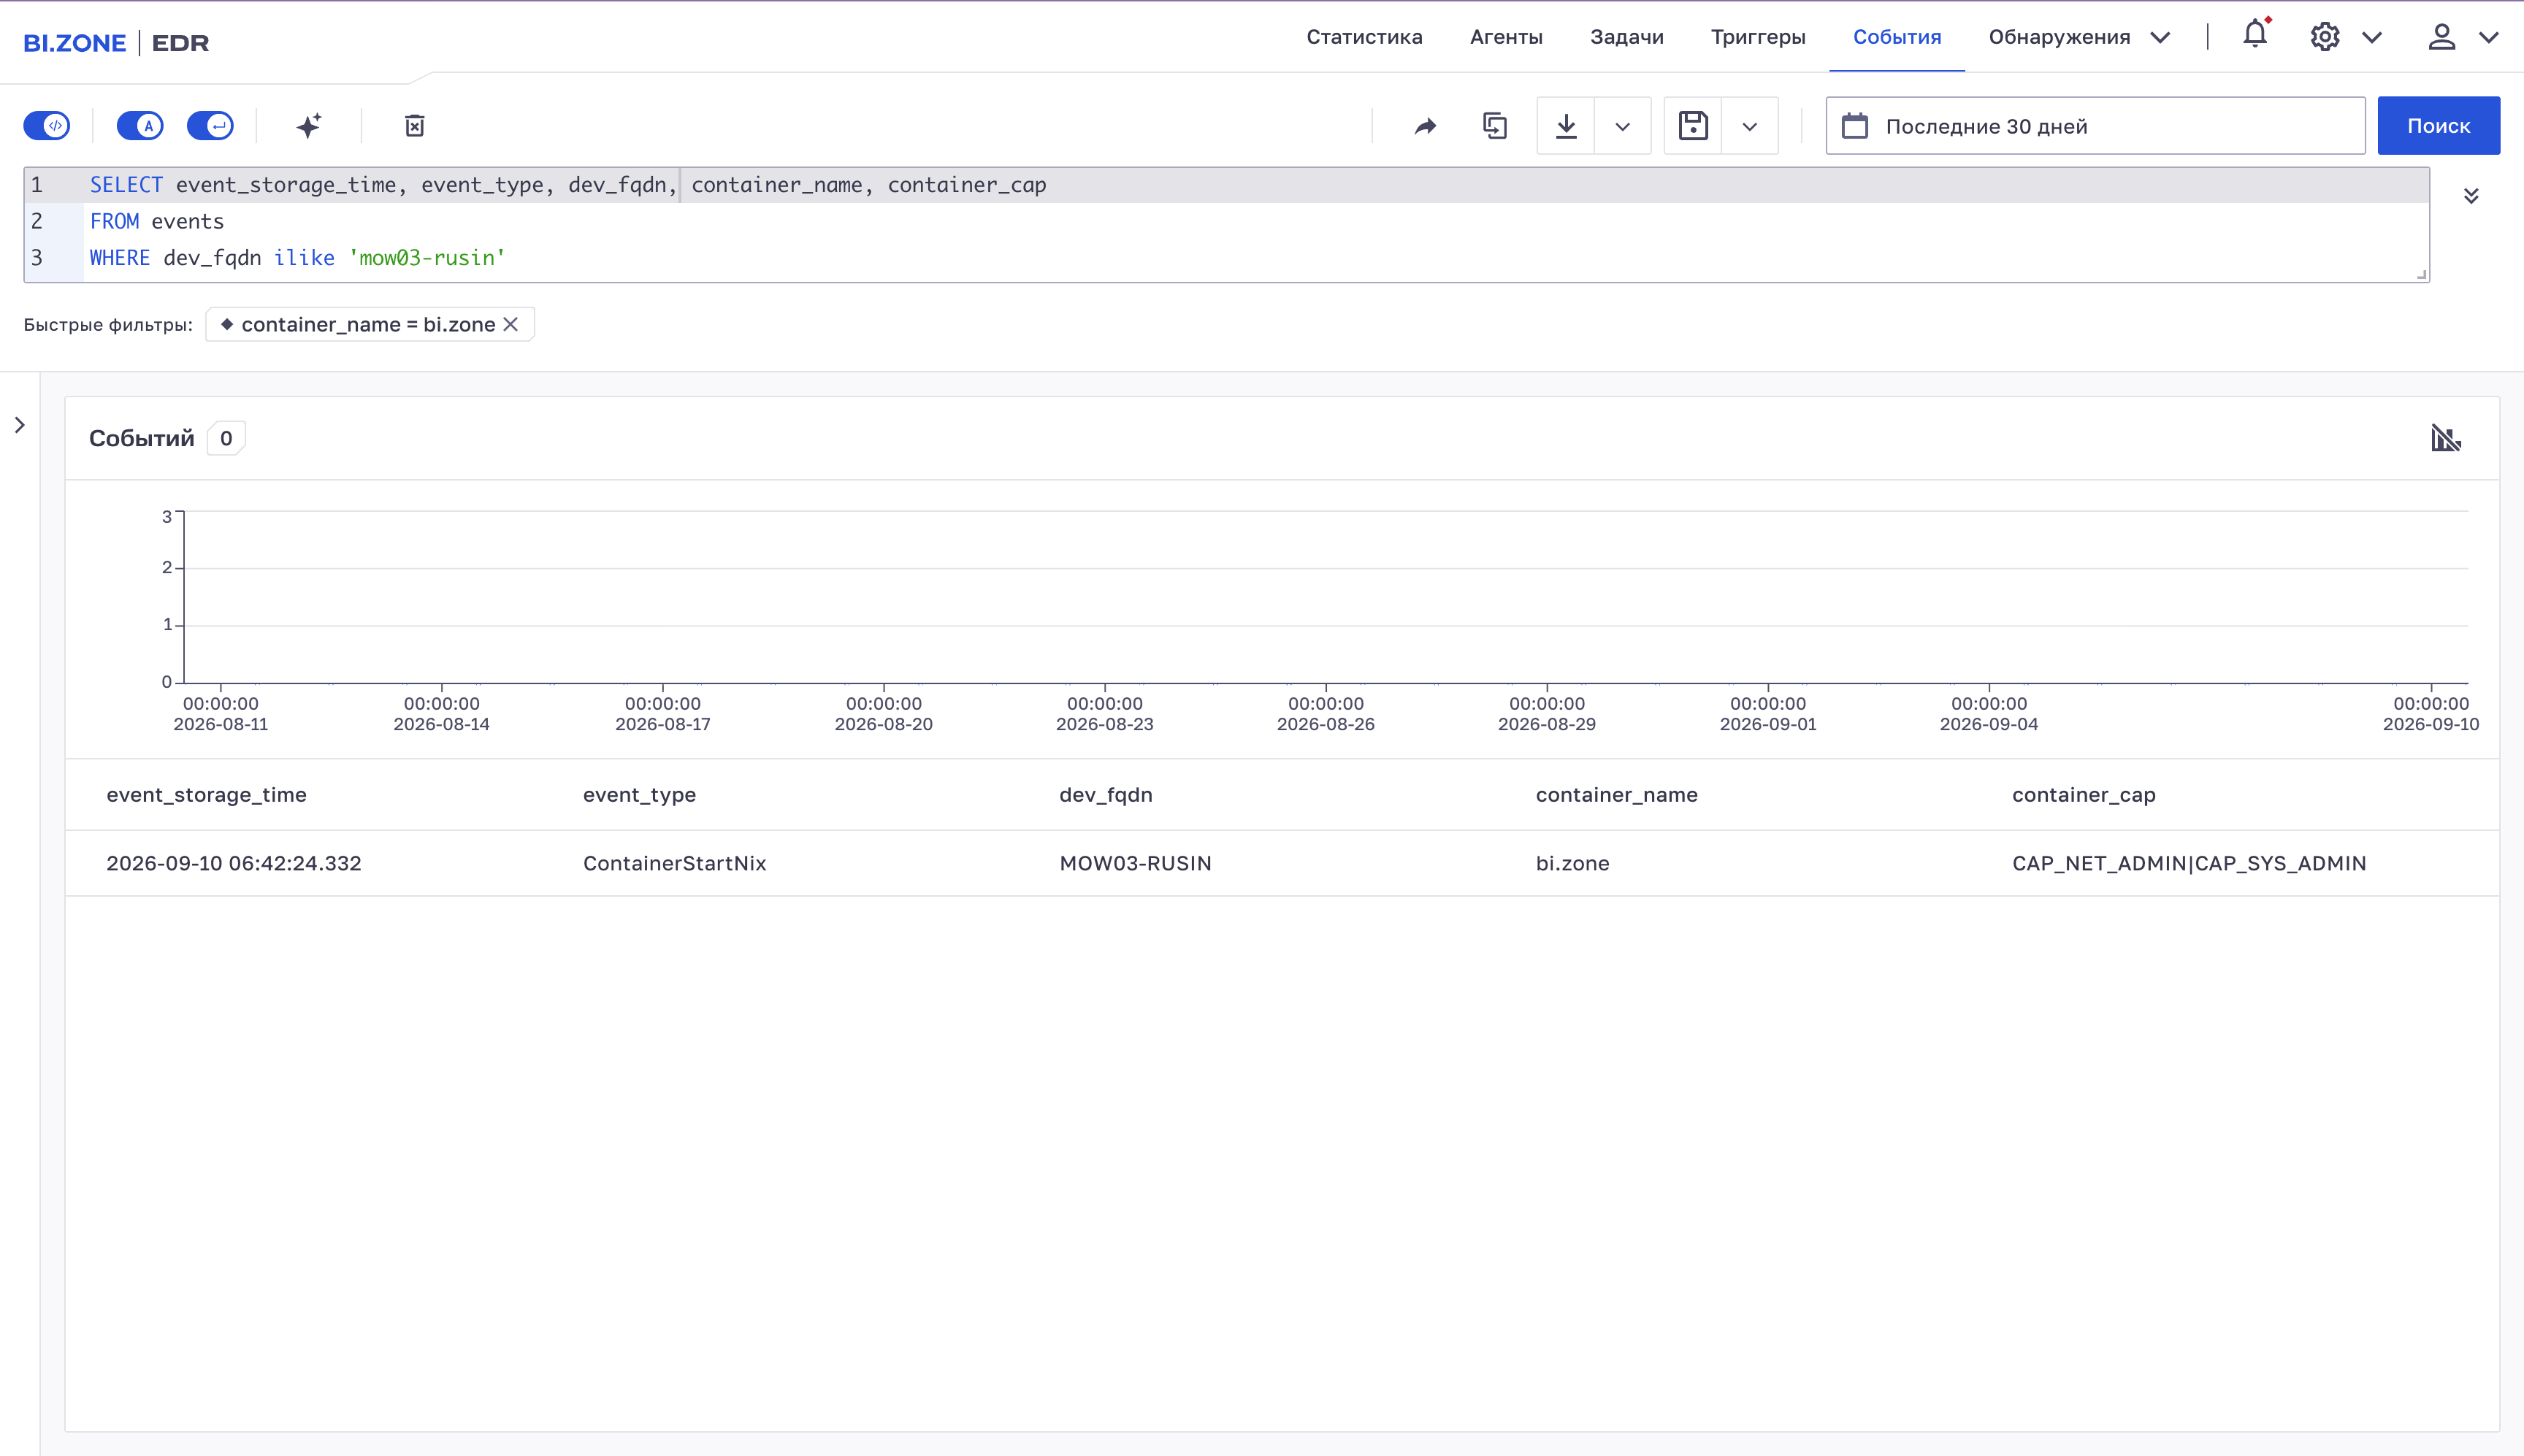
CAP_SYS_ADMIN— очень широкая привилегия, связанная с монтированием, namespace и административными операциями.CAP_SYS_MODULE— загрузка и выгрузка модулей ядра.CAP_SYS_PTRACE— отладка и трассировка других процессов.CAP_NET_ADMIN— изменение сетевого стека.CAP_DAC_OVERRIDE— обход проверок доступа к файлам.CAP_MKNOD— создание специальных файлов устройств.
Хорошая практика — сначала удалить все capabilities, а затем вернуть лишь строго необходимые:
securityContext:
  capabilities:
    drop:
- ALLЕсли приложению требуется конкретная возможность, ее нужно добавлять точечно и фиксировать причину. Например, сервису может понадобиться NET_BIND_SERVICE для открытия порта ниже 1024, но это не причина выдавать NET_ADMIN или SYS_ADMIN.
С точки зрения контроля BI.ZONE EDR важны как инвентаризация параметров контейнера, так и поведенческие признаки. Например, наличие CAP_NET_ADMIN не всегда означает атаку, но изменение сетевых интерфейсов, правил маршрутизации или iptables из нетипичного контейнера требует проверки. Аналогично вызовы ptrace, mount, создание устройств или попытки загрузить модуль ядра приобретают высокий приоритет, если инициированы процессом внутри контейнера.
Запуск приложения с правами root
Многие Docker‑образы по умолчанию запускают основной процесс от имени root. Это не означает автоматический административный доступ к хосту: контейнер ограничен namespaces и Linux capabilities. Но для атакующего наличие прав root внутри контейнера — более удобная отправная точка.
Получив через уязвимость приложения возможность выполнять команды, злоумышленник может менять файлы приложения, устанавливать дополнительные утилиты, читать доступные секреты и искать ошибки в настройках Docker или хоста. Риск особенно высок, если контейнеру выданы избыточные capabilities, смонтированы каталоги хоста или доступен docker.sock.
Основной способ снизить риск — указать непривилегированного пользователя в Dockerfile:
FROM nginx:alpine

RUN addgroup -S app && adduser -S app -G app
USER app
При необходимости пользователя можно задать и при запуске контейнера:
docker run --user 10001:10001 example-app
Важно, чтобы приложение могло читать необходимые файлы и записывать данные только в специально подготовленные каталоги с корректными правами. Не стоит полагаться только на параметр запуска: директива USER в Dockerfile делает безопасное поведение свойством самого образа.
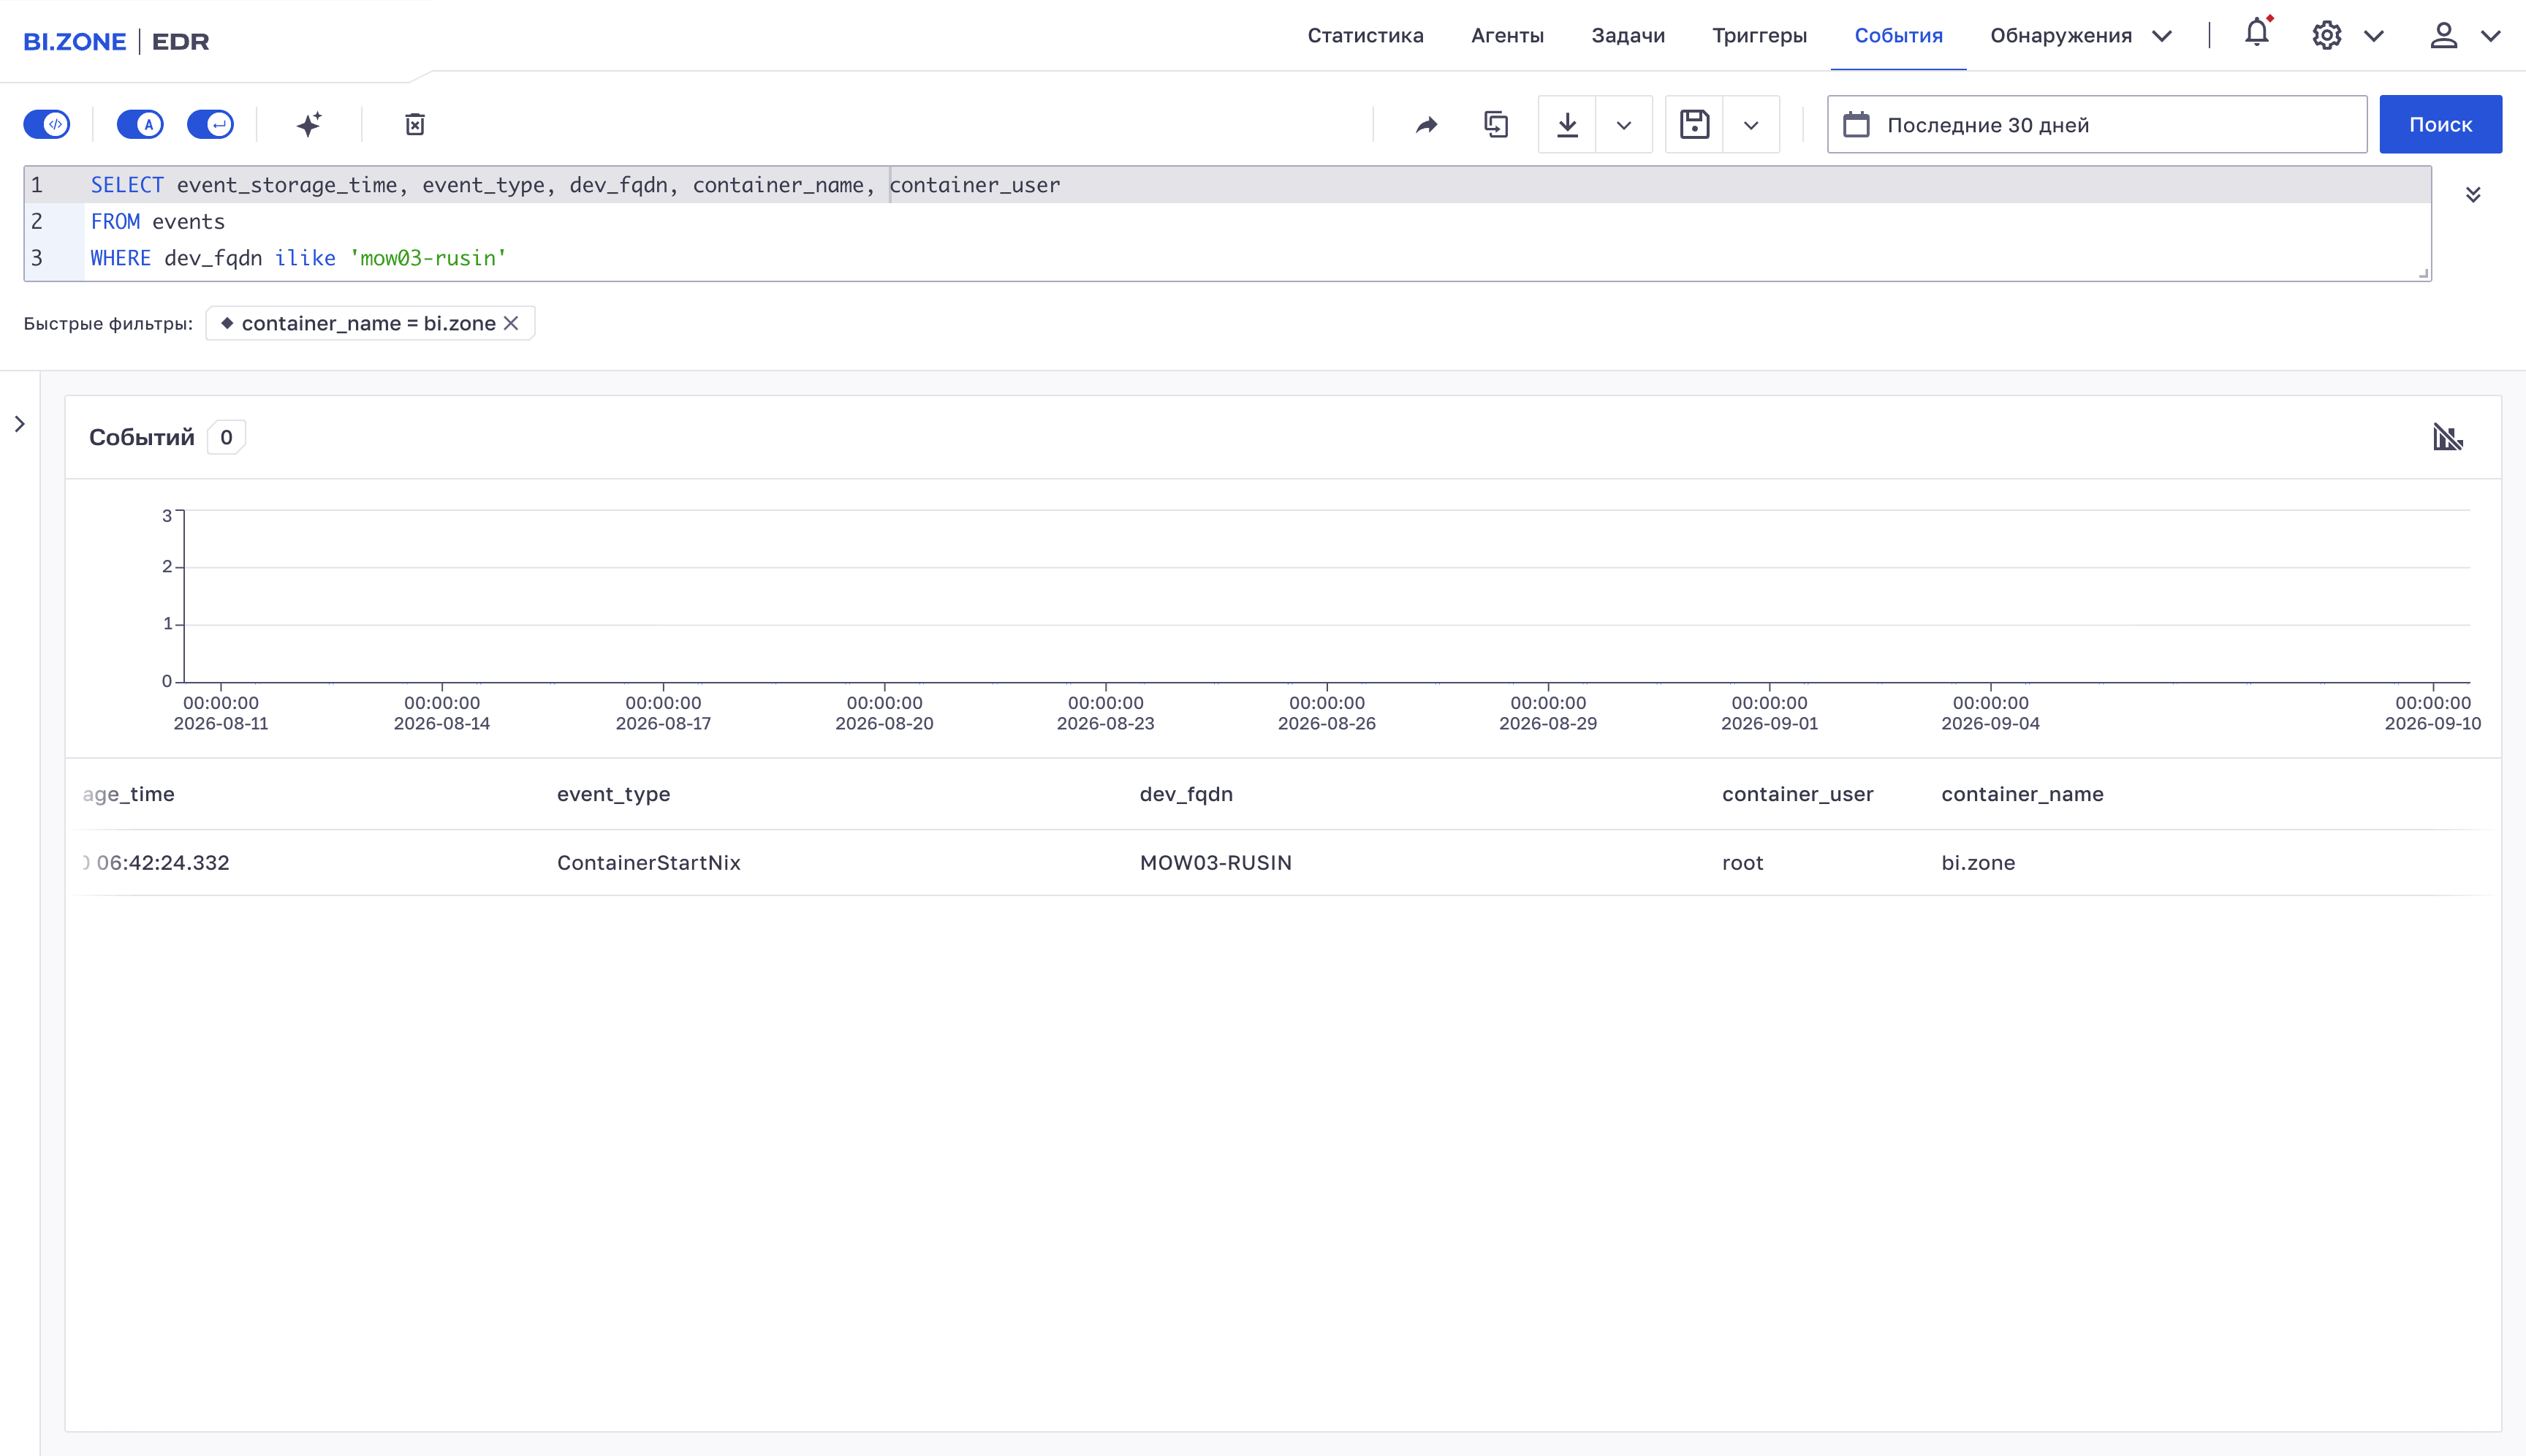
BI.ZONE EDR позволяет сопоставлять процессы с контейнерным контекстом и выявлять контейнеры, где процессы работают с UID 0. При расследовании особого внимания требуют root‑процессы, запускающие оболочки, средства загрузки файлов, сканеры сети или команды управления Docker и параметрами Linux.
Права доступа к сокету Docker
Docker использует Unix‑сокет /var/run/docker.sock для взаимодействия клиента с демоном Docker. Параметры сокета также определяются системной конфигурацией docker.socket.
Для безопасной конфигурации необходимо контролировать владельца и права доступа к обоим объектам:
- Unit‑файл
docker.socketдолжен принадлежатьroot:rootи иметь права644или строже. - Сокет
/var/run/docker.sockдолжен принадлежатьroot:dockerи иметь права660или строже.
Такая конфигурация дает доступ к демону Docker только пользователю root и членам группы docker. Добавлять пользователей или сервисные учетные записи в эту группу следует только при необходимости: возможность обращаться к сокету Docker позволяет управлять контейнерами и ресурсами Docker‑хоста.
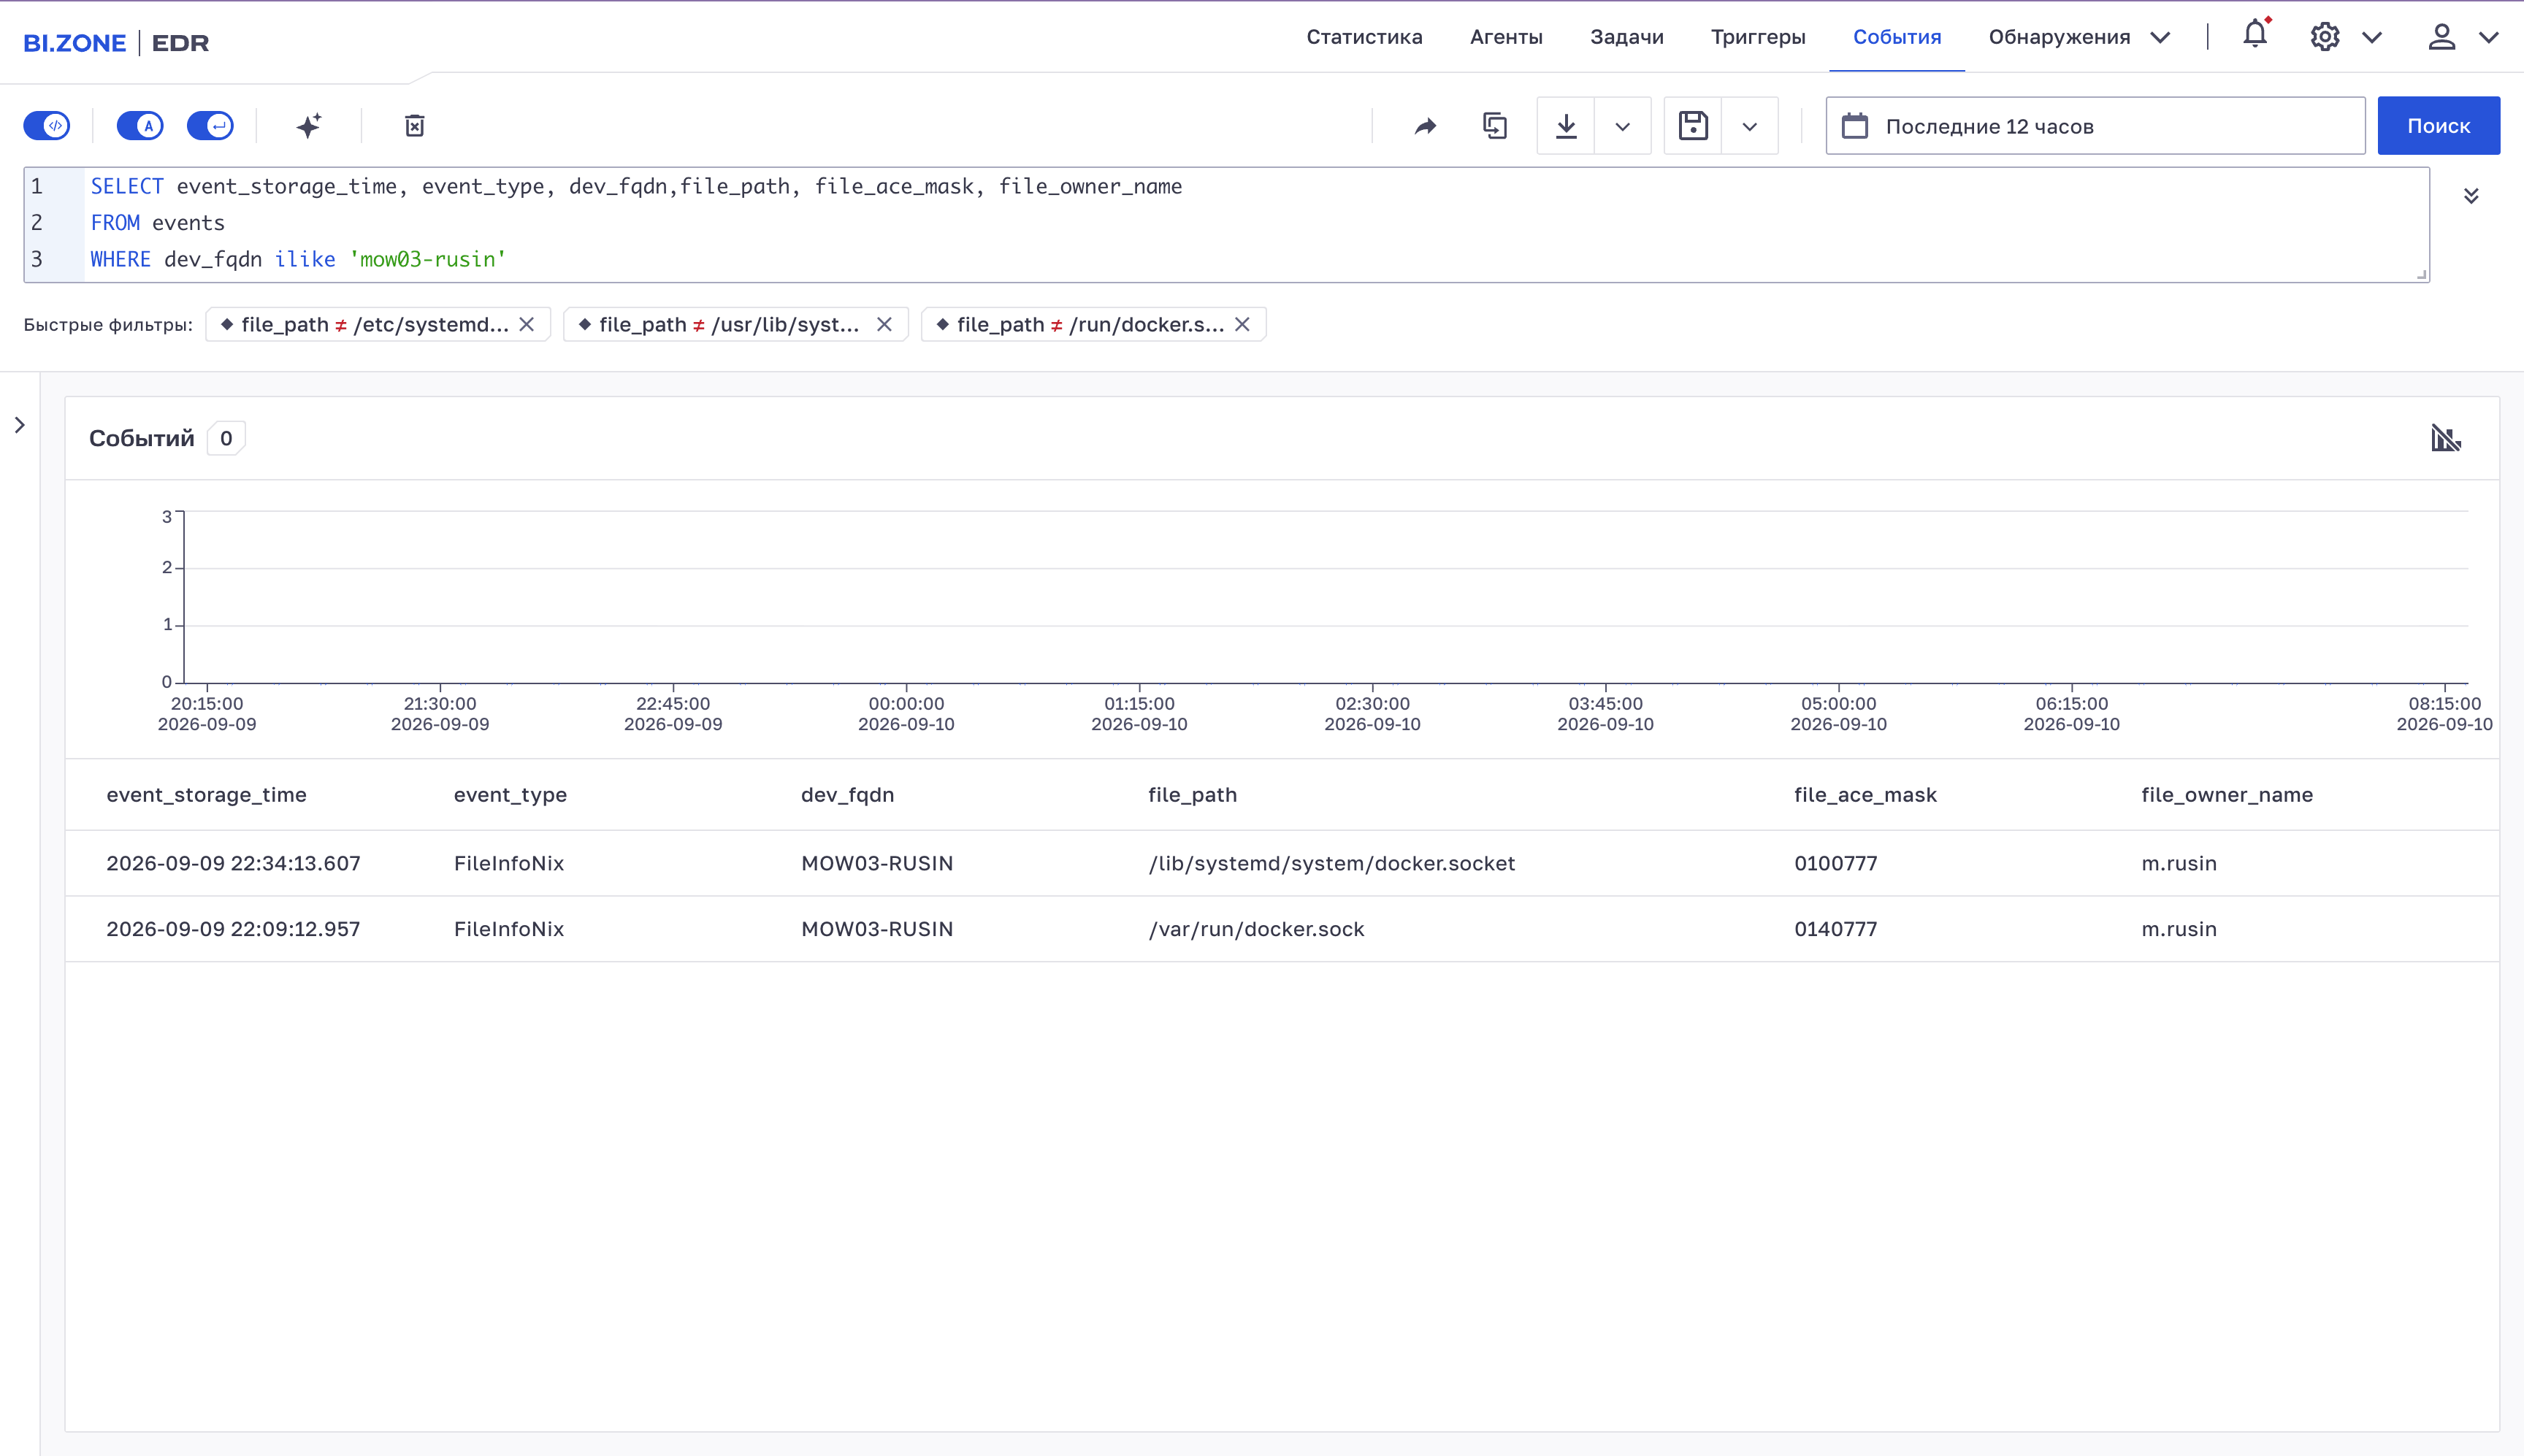
BI.ZONE EDR помогает контролировать права, владельцев и изменение файлов docker.socket и /var/run/docker.sock. Смена владельца, расширение прав доступа или включение в группу docker нетипичной учетной записи должны стать поводом для проверки.
Монтирование критических каталогов хоста
Docker позволяет подключать в контейнер каталоги и файлы хоста через bind mount. Это необходимо для некоторых инфраструктурных задач, но для прикладного контейнера такие монтирования резко ослабляют изоляцию.
Особенно опасно передавать в контейнер корневой каталог хоста, /root, домашние каталоги пользователей, /etc или /proc. Получив возможность выполнять команды в таком контейнере, атакующий сможет читать конфигурацию хоста, ключи и учетные данные пользователей, параметры процессов или — при разрешении на запись — изменять системные файлы.
Примеры небезопасных параметров запуска:
-v /:/
-v /root:/root
-v /etc:/etc
-v /proc:/proc
-v /home/user:/home/user
Для прикладных контейнеров следует отказаться от таких монтирований. Если том все же необходим, нужно передавать только конкретный каталог или файл, предоставлять его в режиме только для чтения, когда запись не нужна, и не использовать для хранения секретов или конфигурации хоста.
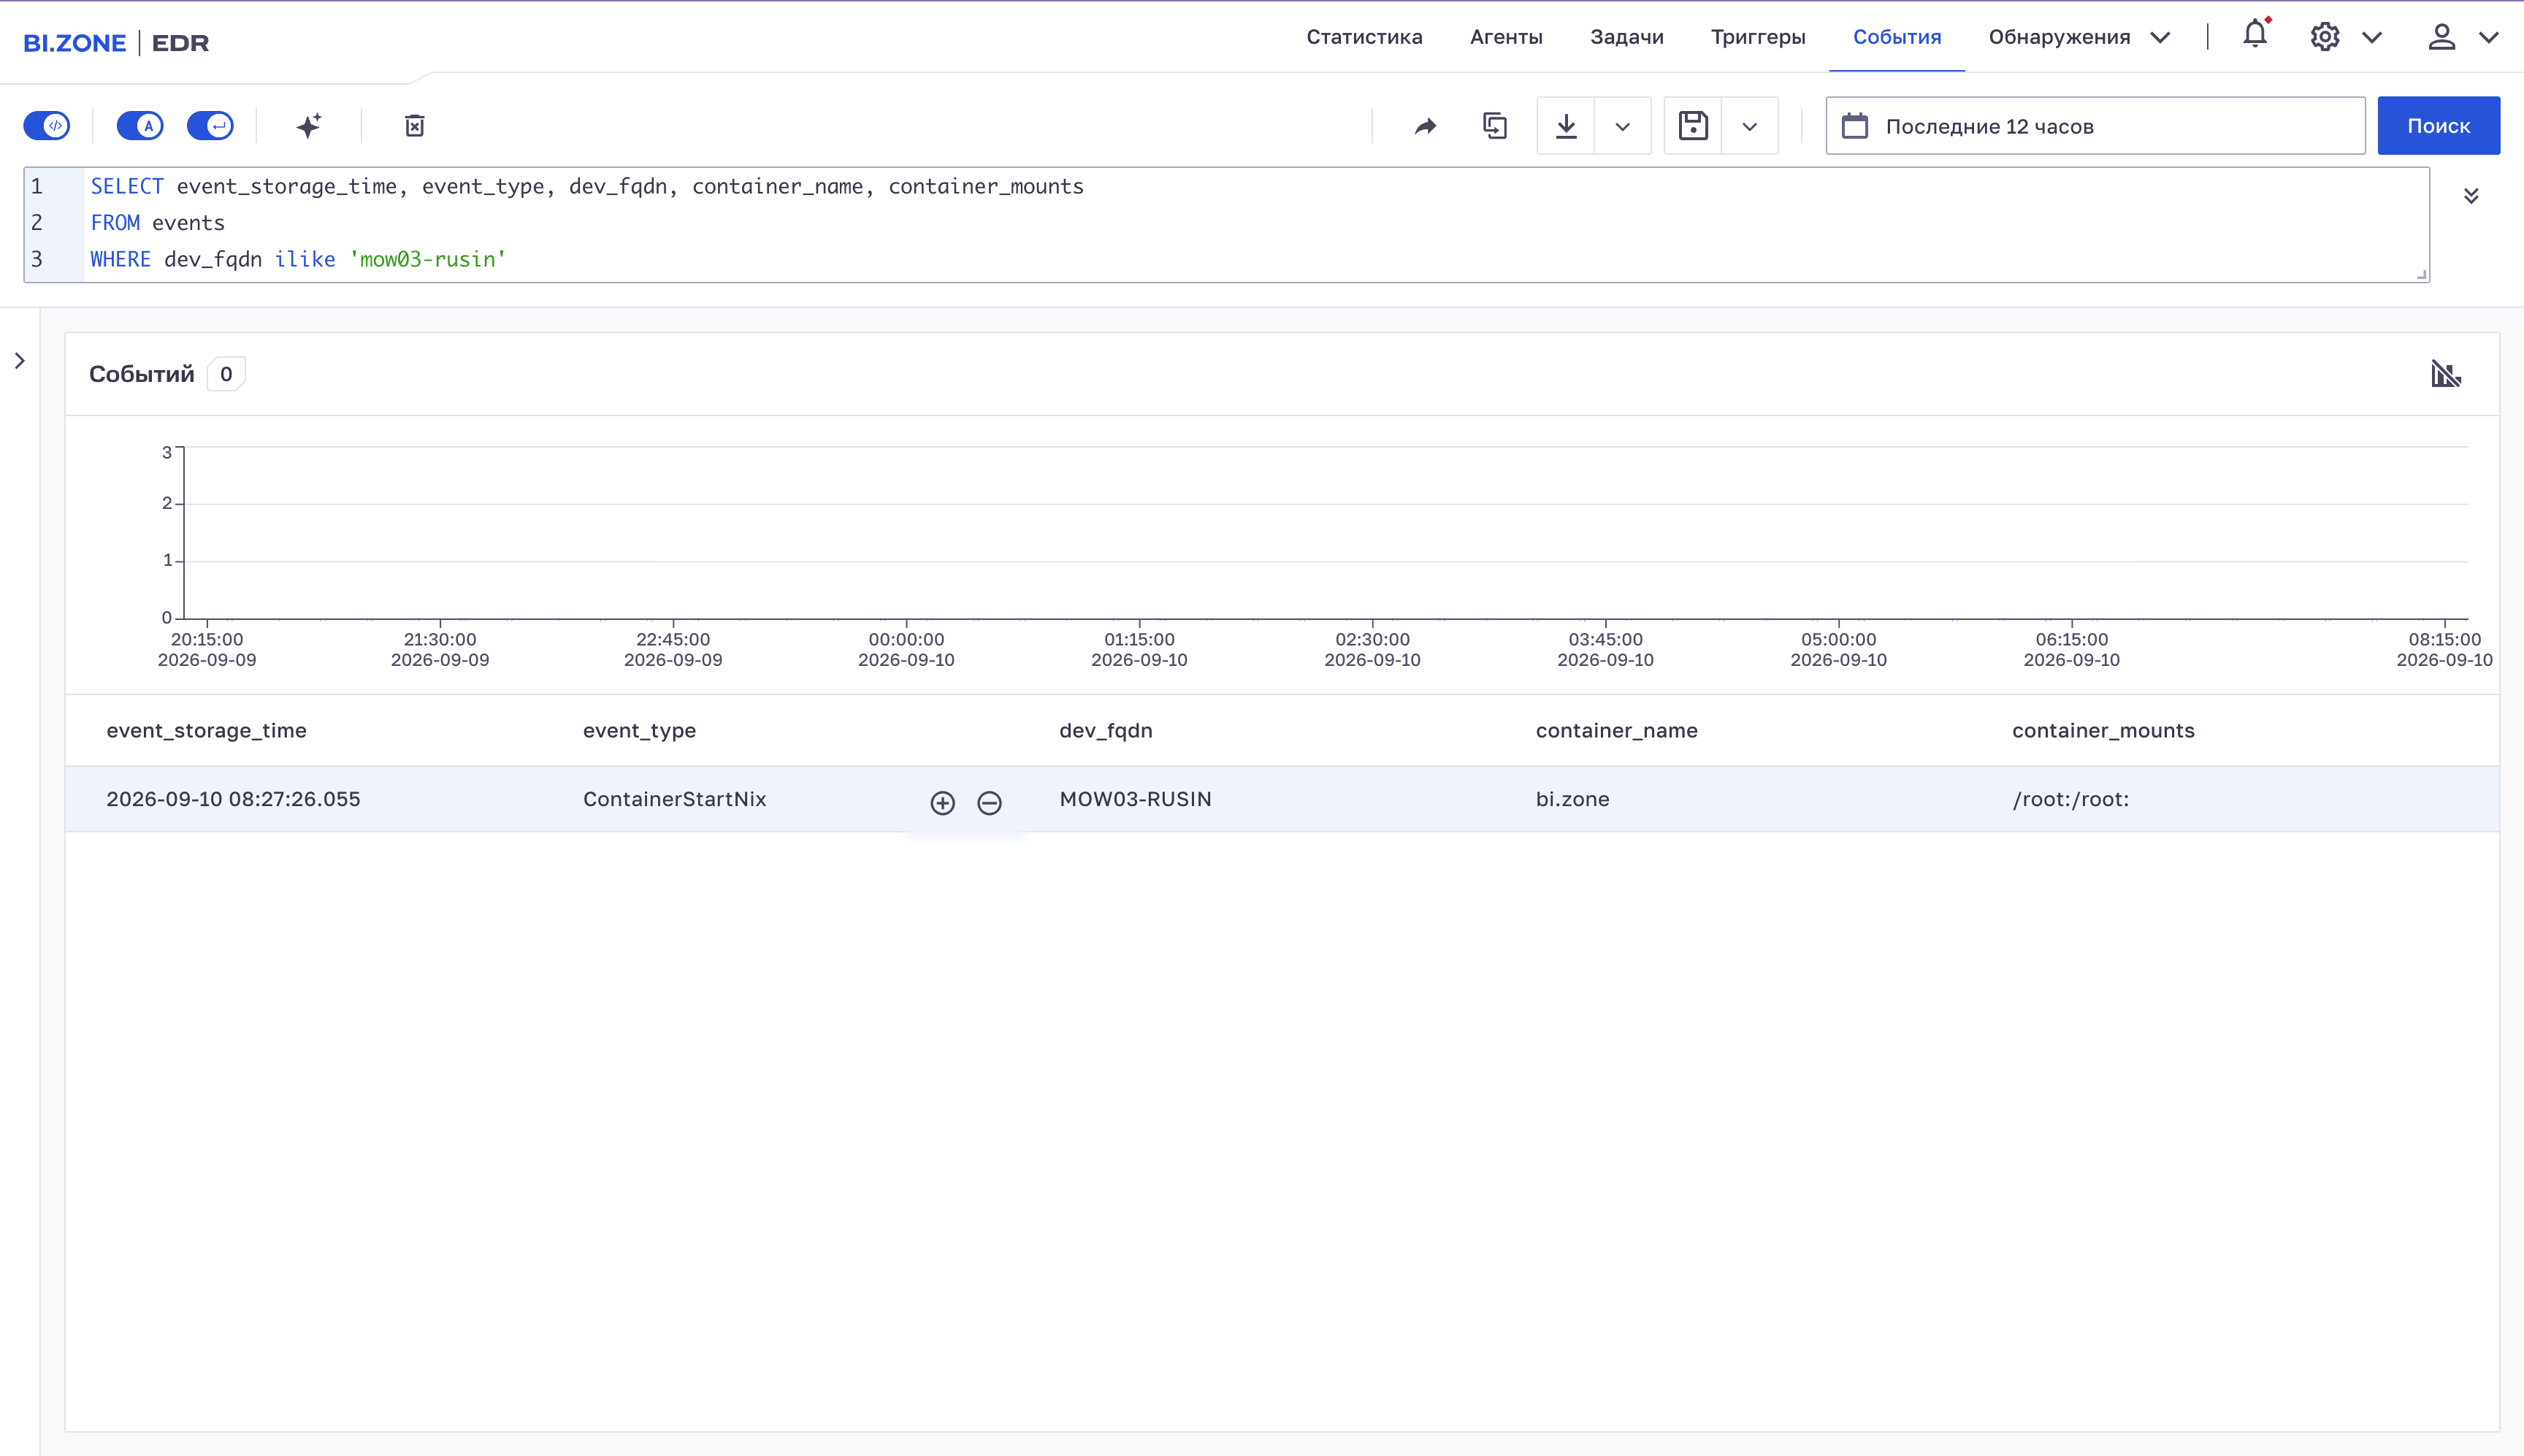
BI.ZONE EDR выявляет такие контейнеры. Правило срабатывает, когда на Unix‑узле контейнер получает монтирование корня хоста, /root, домашнего каталога пользователя, /etc или /proc. Это позволяет обнаружить опасную конфигурацию независимо от того, была ли она создана через docker run, Docker Compose или средствами автоматизации.
Срабатывание не всегда означает инцидент: подобные монтирования могут быть нужны сервисному агенту. Однако для каждого случая необходимо проверить назначение контейнера, владельца, режим доступа к тому и обоснованность исключения.
Небезопасные параметры демона Docker и компонентов хоста
Запуск демона Docker без root‑прав
Демон Docker традиционно запускается с правами root, поскольку управляет контейнерами, сетями, томами и ресурсами хоста. По возможности стоит использовать rootless‑режим Docker: в нем демон и контейнеры работают от имени непривилегированного пользователя хоста. Это снижает последствия компрометации Docker API или самого демона: пользователь root внутри контейнера не получает прав root на Linux‑хосте.
Rootless‑режим подходит не для всех сценариев. Он имеет ограничения при работе с низкими портами, некоторыми сетевыми настройками, устройствами и привилегированными контейнерами. Поэтому перед внедрением необходимо проверить совместимость с используемыми приложениями.
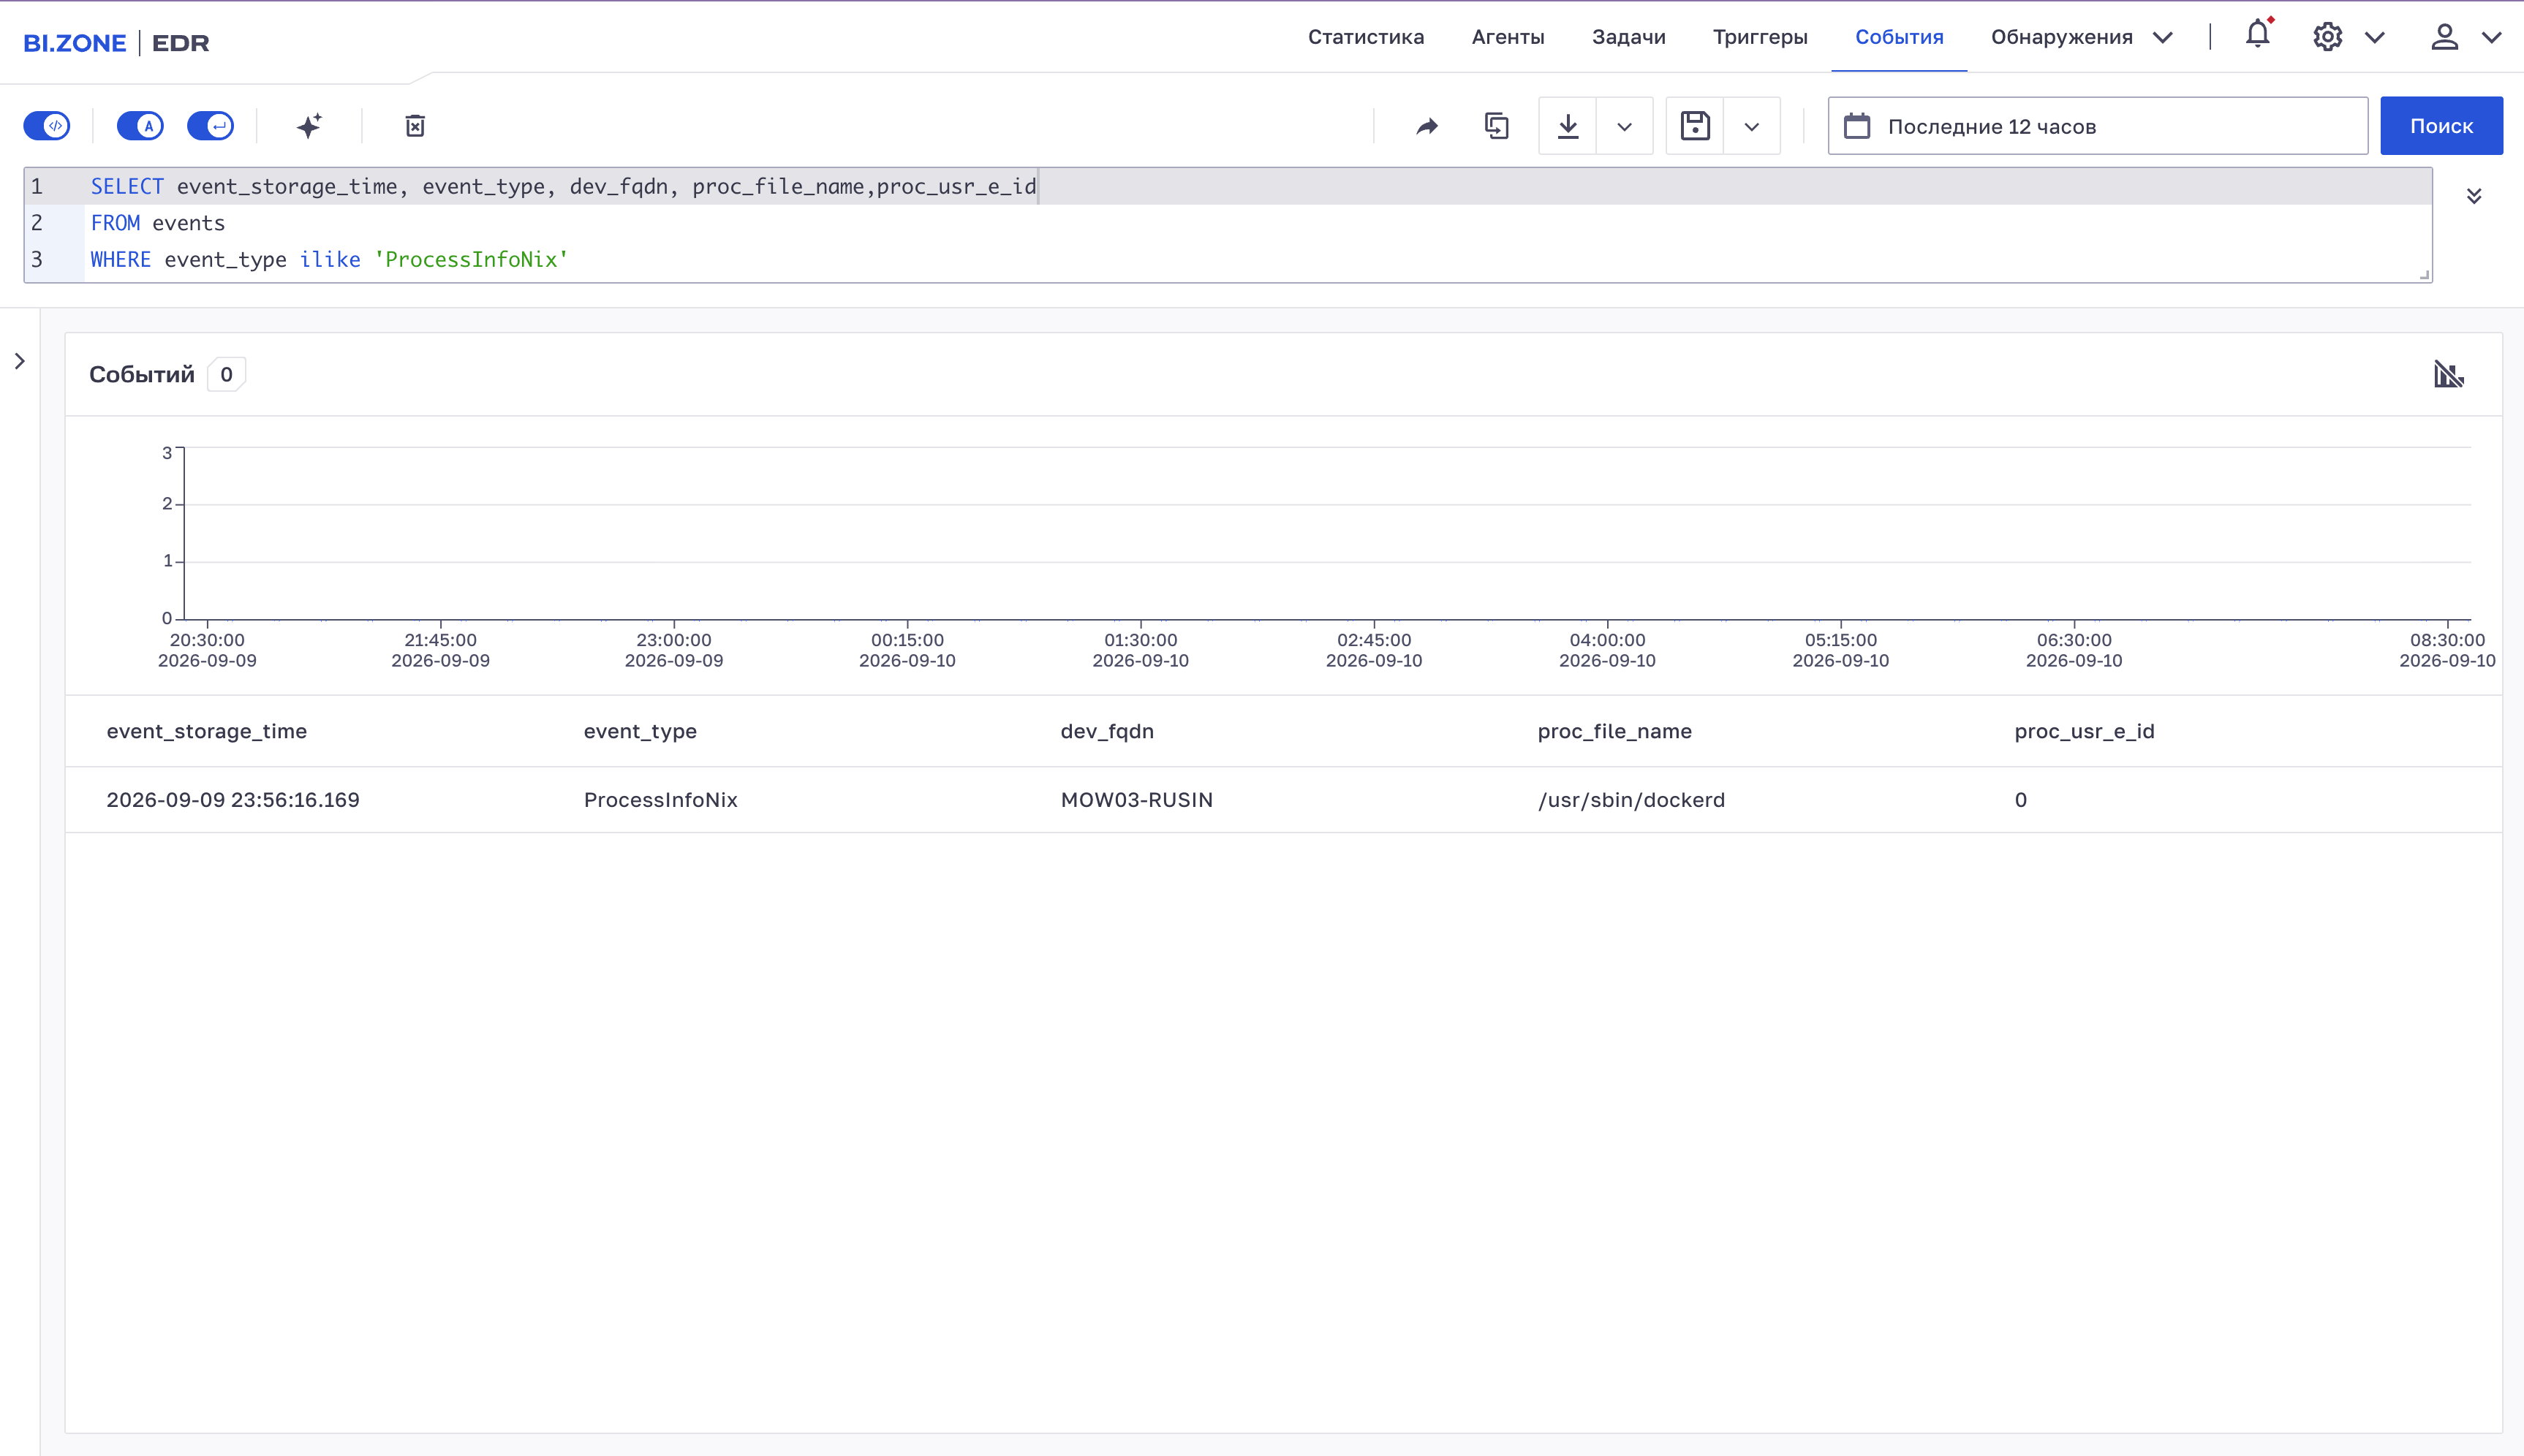
BI.ZONE EDR позволяет контролировать способ запуска демона Docker, его процессы и связанные изменения конфигурации. Однако rootless‑режим Docker не отменяет необходимости запускать само приложение внутри контейнера от имени непривилегированного пользователя.
Удаленный доступ к Docker API без TLS‑аутентификации
По умолчанию демон Docker использует локальный Unix‑сокет /var/run/docker.sock. Если для удаленного администрирования Docker API открывают по TCP, доступ к нему необходимо защищать с помощью TLS‑аутентификации клиента.
Небезопасная конфигурация — демон Docker, принимающий подключения через TCP‑порт без TLS. В таком случае любой пользователь, имеющий сетевой доступ к порту, потенциально может управлять контейнерами на хосте.
Пример безопасной конфигурации в /etc/docker/daemon.json:
{
  "hosts": ["unix:///var/run/docker.sock", "tcp://0.0.0.0:2376"],
  "tls": true,
  "tlsverify": true,
  "tlscacert": "/etc/docker/ca.pem",
  "tlscert": "/etc/docker/server-cert.pem",
  "tlskey": "/etc/docker/server-key.pem"
}Недостаточно включить TLS только на стороне клиента: демон Docker должен проверять клиентский сертификат. Если удаленный доступ к API не требуется, безопаснее вовсе не открывать TCP‑порт и использовать локальный сокет или защищенное подключение по SSH.
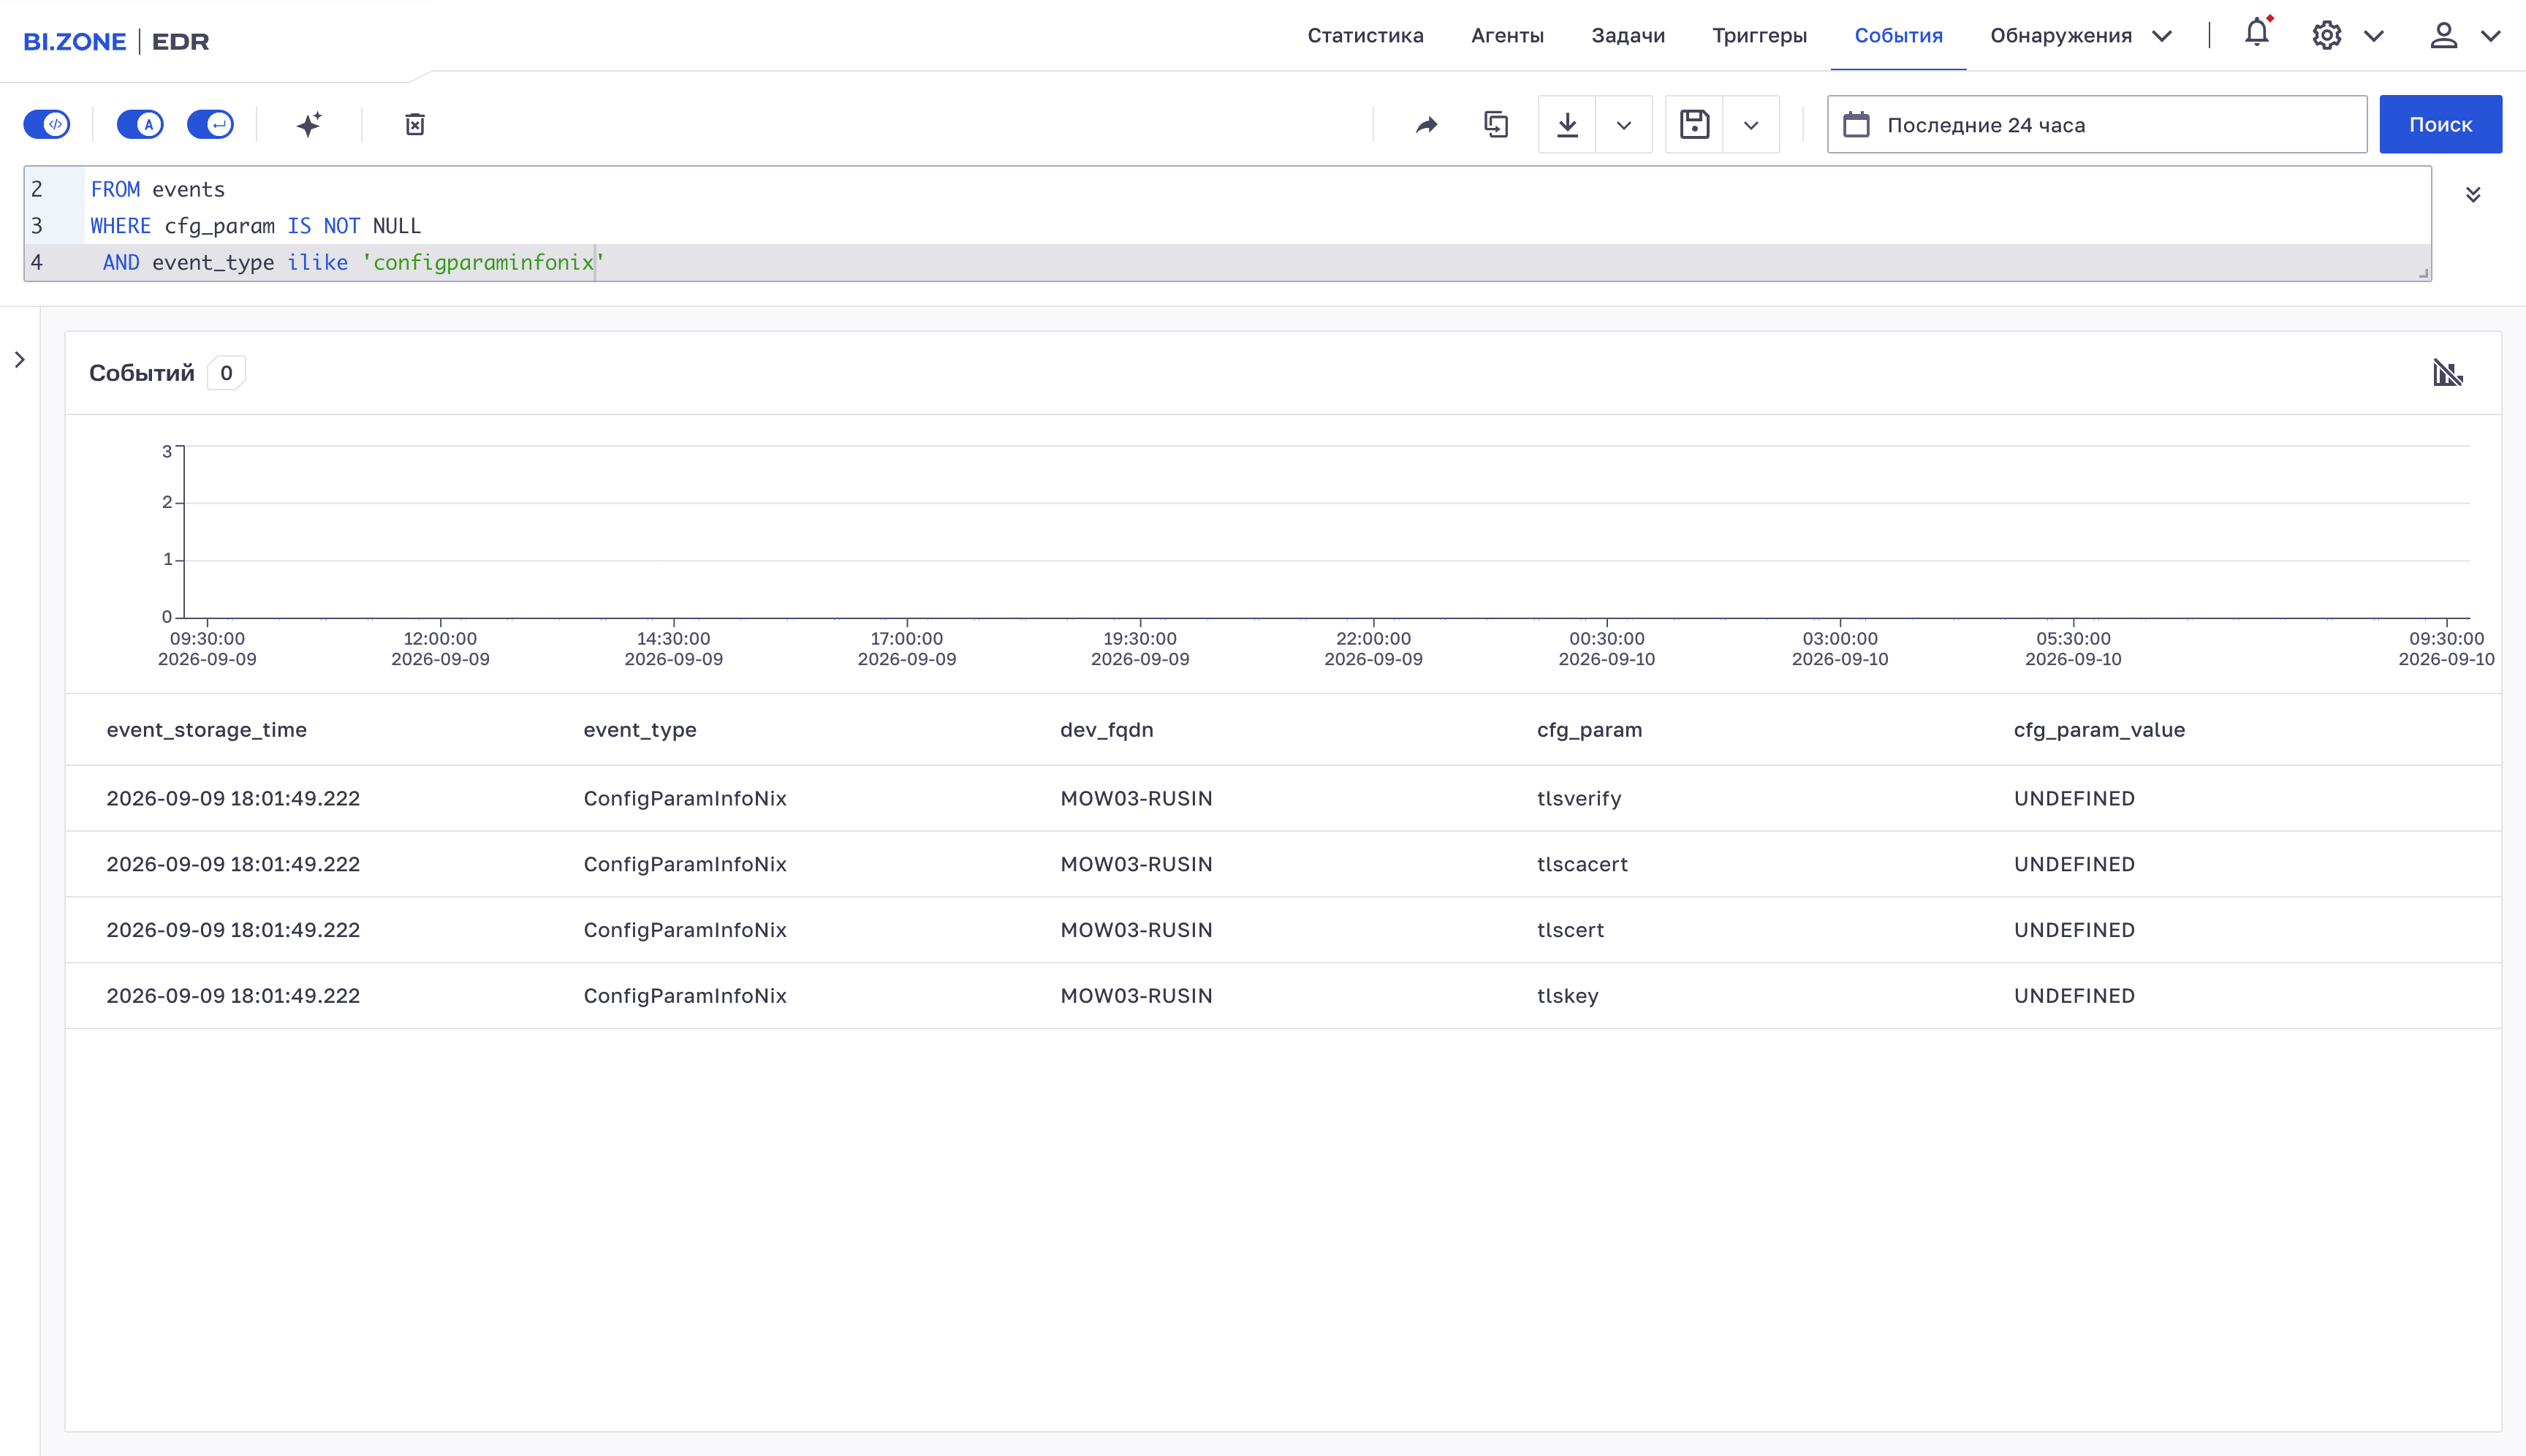
BI.ZONE EDR помогает контролировать конфигурацию демона Docker и выявлять ее изменения: появление TCP‑слушателя Docker, отключение параметра tlsverify, изменение сертификатов и ключей, а также нетипичные подключения к Docker API. Особого внимания требуют обращения к портам Docker API из пользовательских сегментов сети или от процессов, не относящихся к администрированию.
Неверный уровень логирования демона Docker
Демон Docker должен вести журналы на уровне info. Этого достаточно для регистрации ключевых событий: штатной работы сервиса, запуска и остановки контейнеров, ошибок и других действий администратора. При этом не создается избыточного объема отладочных сообщений.
Настройка задается в /etc/docker/daemon.json:
{
  "log-level": "info"
}В production‑среде не рекомендуется постоянно использовать уровень debug: он создает большой объем журналов, усложняет анализ и может повысить риск попадания технических сведений в логи. Уровни выше info, напротив, могут не дать необходимой детализации при расследовании инцидента.
После изменения конфигурации демона Docker необходимо перезапустить сервис и убедиться, что настройка применена.
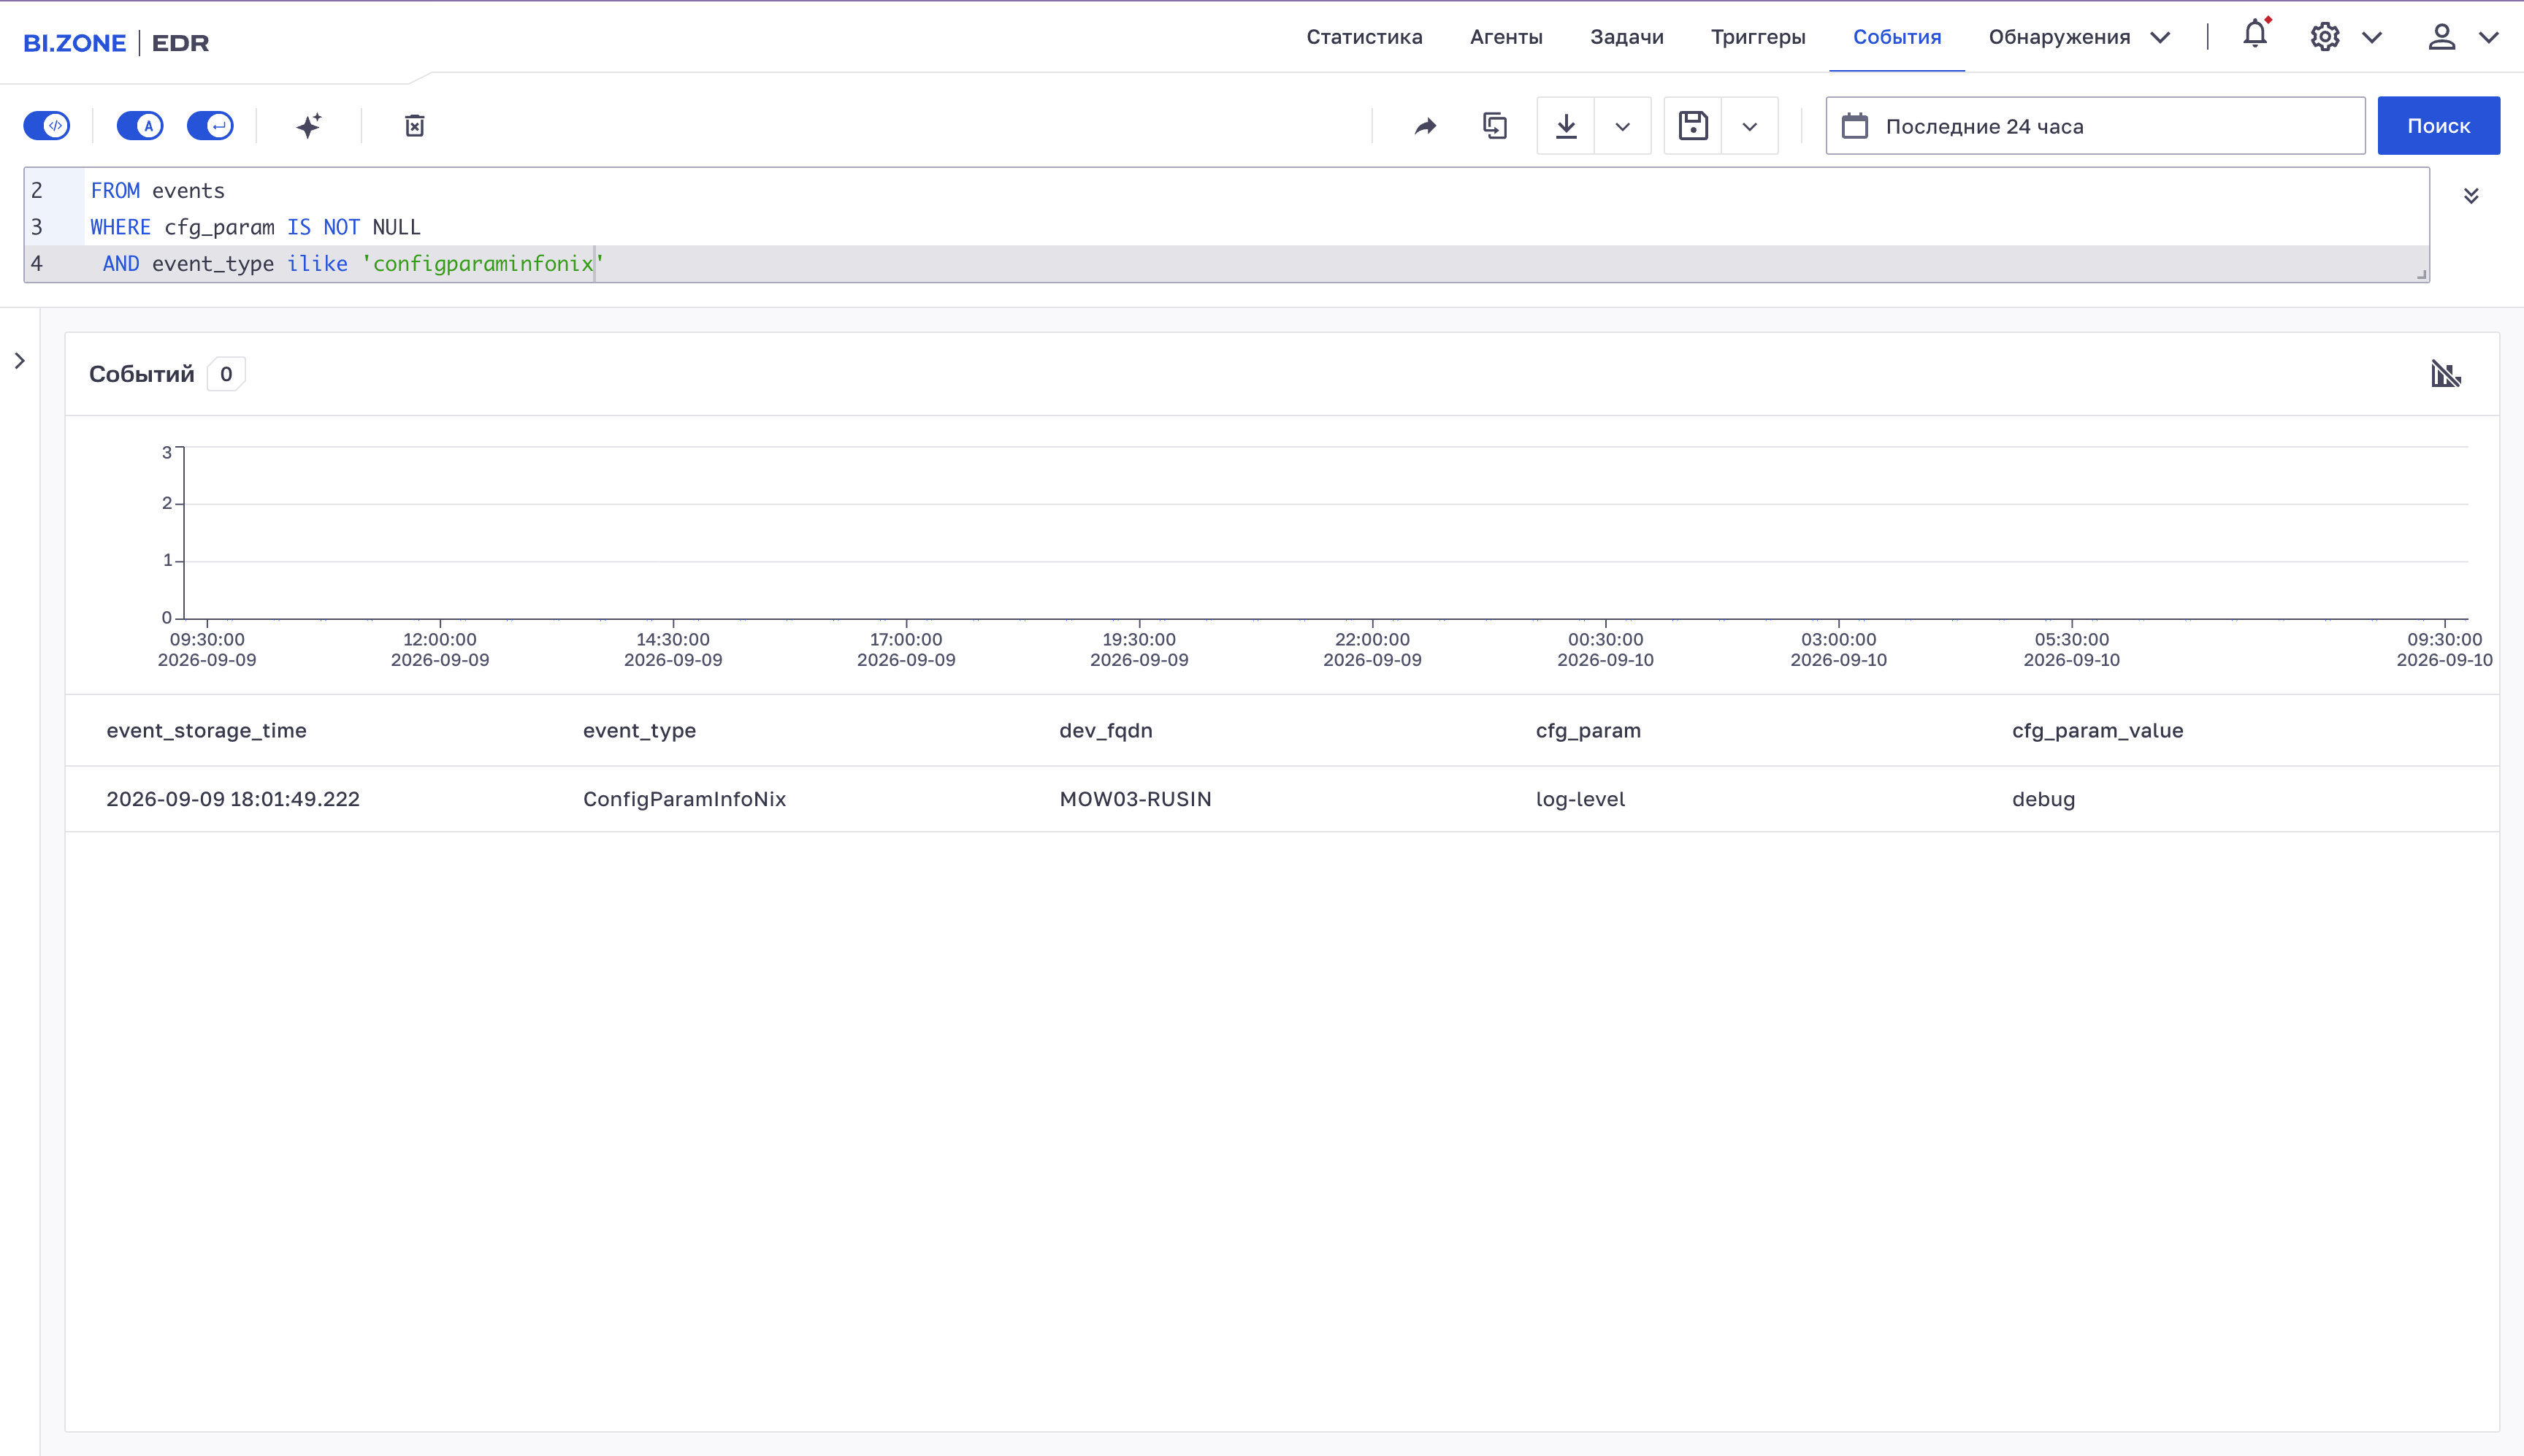
BI.ZONE EDR позволяет контролировать изменения файла /etc/docker/daemon.json и параметров запуска dockerd, а также проверять, какой уровень логирования задан в системе.
Устаревшие образы и компоненты Docker‑хоста
Безопасность Docker зависит не только от параметров запуска контейнера. В том числе она определяется несколькими компонентами: базовым образом, библиотеками приложения, Docker Engine, containerd, runc и ядром Linux. Уязвимость в любом из этих компонентов поможет обойти или существенно ослабить изоляцию контейнера.
Для снижения риска необходимо регулярно:
- пересобирать образы на актуальных базовых версиях;
- удалять из образов ненужные пакеты, интерпретаторы и административные утилиты;
- отслеживать уязвимости в Docker Engine,
containerd,runcи ядре Linux; - использовать только поддерживаемые версии Docker и компонентов хоста;
- фиксировать используемые образы по конкретному тегу, а не использовать плавающий тег
latest; - разрешать загрузку образов только из доверенных registry;
- проверять происхождение и по возможности подпись образов.
Использование latest не гарантирует получение актуальной и безопасной версии: содержимое этого тега может измениться без корректировки Dockerfile или конфигурации запуска. Digest фиксирует конкретную версию образа и делает развертывание воспроизводимым.
Заключение
Контейнеры используют общее ядро Linux‑хоста, поэтому их безопасность зависит не только от содержимого образа, но и от параметров запуска, прав процесса, точек монтирования, доступных capabilities и конфигурации демона Docker.
Харденинг Docker — непрерывный процесс. Необходимо запускать приложения с минимальными привилегиями, отказываться от --privileged и опасных монтирований, ограничивать доступ к docker.sock, регулярно пересматривать исключения и своевременно обновлять образы, Docker Engine и компоненты хоста. Проверки в CI/CD и безопасная конфигурация Docker‑хоста предотвращают появление части рисков.
EDR‑решение дополняет эти меры: помогает выявлять опасные параметры уже работающих контейнеров, контролировать активность на Linux‑узле и расследовать попытки развития атаки. Так контейнерная безопасность превращается из набора рекомендаций в управляемый процесс. Вероятность компрометации снижается, а ее последствия ограничиваются даже в случае успешной эксплуатации уязвимости в приложении.