


Механизмы защиты Linux: LSM, Mandatory Access Control, защита памяти и изоляция процессов
Введение
Классическая модель безопасности Unix строится вокруг пользователей, групп и файловых разрешений. Владелец объекта определяет, кто может читать, изменять или выполнять его. Эта модель остается фундаментом Linux, но для современных систем ее возможностей недостаточно.
Представим, что веб‑сервер работает от отдельной учетной записи и имеет право читать каталог с содержимым сайта. Если приложение будет скомпрометировано, атакующий получит полномочия его процесса. С точки зрения классической модели доступа нарушения нет: запросы выполняются от имени легитимного пользователя и не выходят за рамки назначенных ему прав.
Проблема в том, что традиционные разрешения ориентируются на владельца объекта и идентификатор процесса, но не учитывают, для чего нужно приложение и как оно должно себя вести. Веб‑серверу действительно требуется читать файлы сайта, но вряд ли ему нужно запускать командную оболочку, обращаться к домашним каталогам пользователей или устанавливать соединения с произвольными внешними адресами.
Ограничить подобные сценарии позволяют несколько взаимодополняющих уровней защиты:
- Архитектура Linux Security Modules (LSM) — предоставляет ядру точки подключения политик безопасности.
- SELinux, AppArmor и другие механизмы обязательного контроля доступа — ограничивают действия процессов независимо от обычных файловых разрешений.
- Средства защиты памяти — усложняют превращение ошибки в управляемую эксплуатацию.
- Namespaces — разделяют представление системных ресурсов.
- cgroups — ограничивают их потребление.
- Seccomp — разрешает процессу только часть системных вызовов.
- Sandbox‑механизмы — объединяют несколько видов ограничений в единую среду выполнения.
Эти уровни не заменяют друг друга. LSM — архитектура, а не готовая политика. сgroups управляют ресурсами, но не контролируют чтение файлов. Seccomp фильтрует системные вызовы, но не определяет бизнес‑смысл операции. ASLR усложняет эксплуатацию, но не исправляет ошибку управления памятью.
Даже совместное применение этих механизмов не гарантирует, что атака будет остановлена на первом этапе. Скомпрометированный процесс может использовать разрешенные операции, штатные системные утилиты и легитимные учетные данные. Поэтому превентивные ограничения надо дополнять наблюдением за поведением системы во время выполнения.
- нормальное поведение системы;
- границы привилегий;
- ожидаемые взаимодействия процессов.
В этой статье разберем архитектуру Linux Security Modules, практическое применение SELinux, AppArmor и Landlock, механизмы защиты памяти, а также namespaces, cgroups, seccomp и другие средства изоляции. Расскажем, какие задачи они решают, где проходят границы возможностей этих инструментов и почему надежная защита требует их совместного применения.
Архитектура Linux Security Modules
LSM — это специальный фреймворк внутри ядра Linux, который позволяет добавлять в систему различные модели контроля безопасности.
Он встроен в подсистемы ядра и предоставляет единый интерфейс для подключения политик безопасности. LSM не отдельный слой, через который последовательно проходят все системные вызовы. Вместо этого разработчики ядра размещают контрольные точки (security hooks) в тех участках кода, где выполняются операции над файлами, процессами, сокетами, учетными данными и другими объектами.
Например, запрос на открытие файла начинается с системного вызова openat() или openat2(), но проверка доступа выполняется глубже — в коде VFS и файловой системы. Во время разрешения пути ядро проверяет права на проход по каталогам, доступ к inode и возможность открыть найденный объект. На разных этапах могут вызываться такие интерфейсы LSM, как:
security_inode_permission()— проверка доступа к inode.security_file_open()— проверка уже сформированного объектаstruct file.security_file_permission()— проверка операций чтения и записи.security_mmap_file()— проверка допустимости отображения файла в память.security_bprm_check()— проверка перед запуском исполняемого файла.
Таким образом, одна операция из пользовательского пространства может привести к вызову нескольких security hooks. И наоборот, один hook может использоваться в путях выполнения разных системных вызовов.
Упрощенно обработку открытия файла можно представить так:
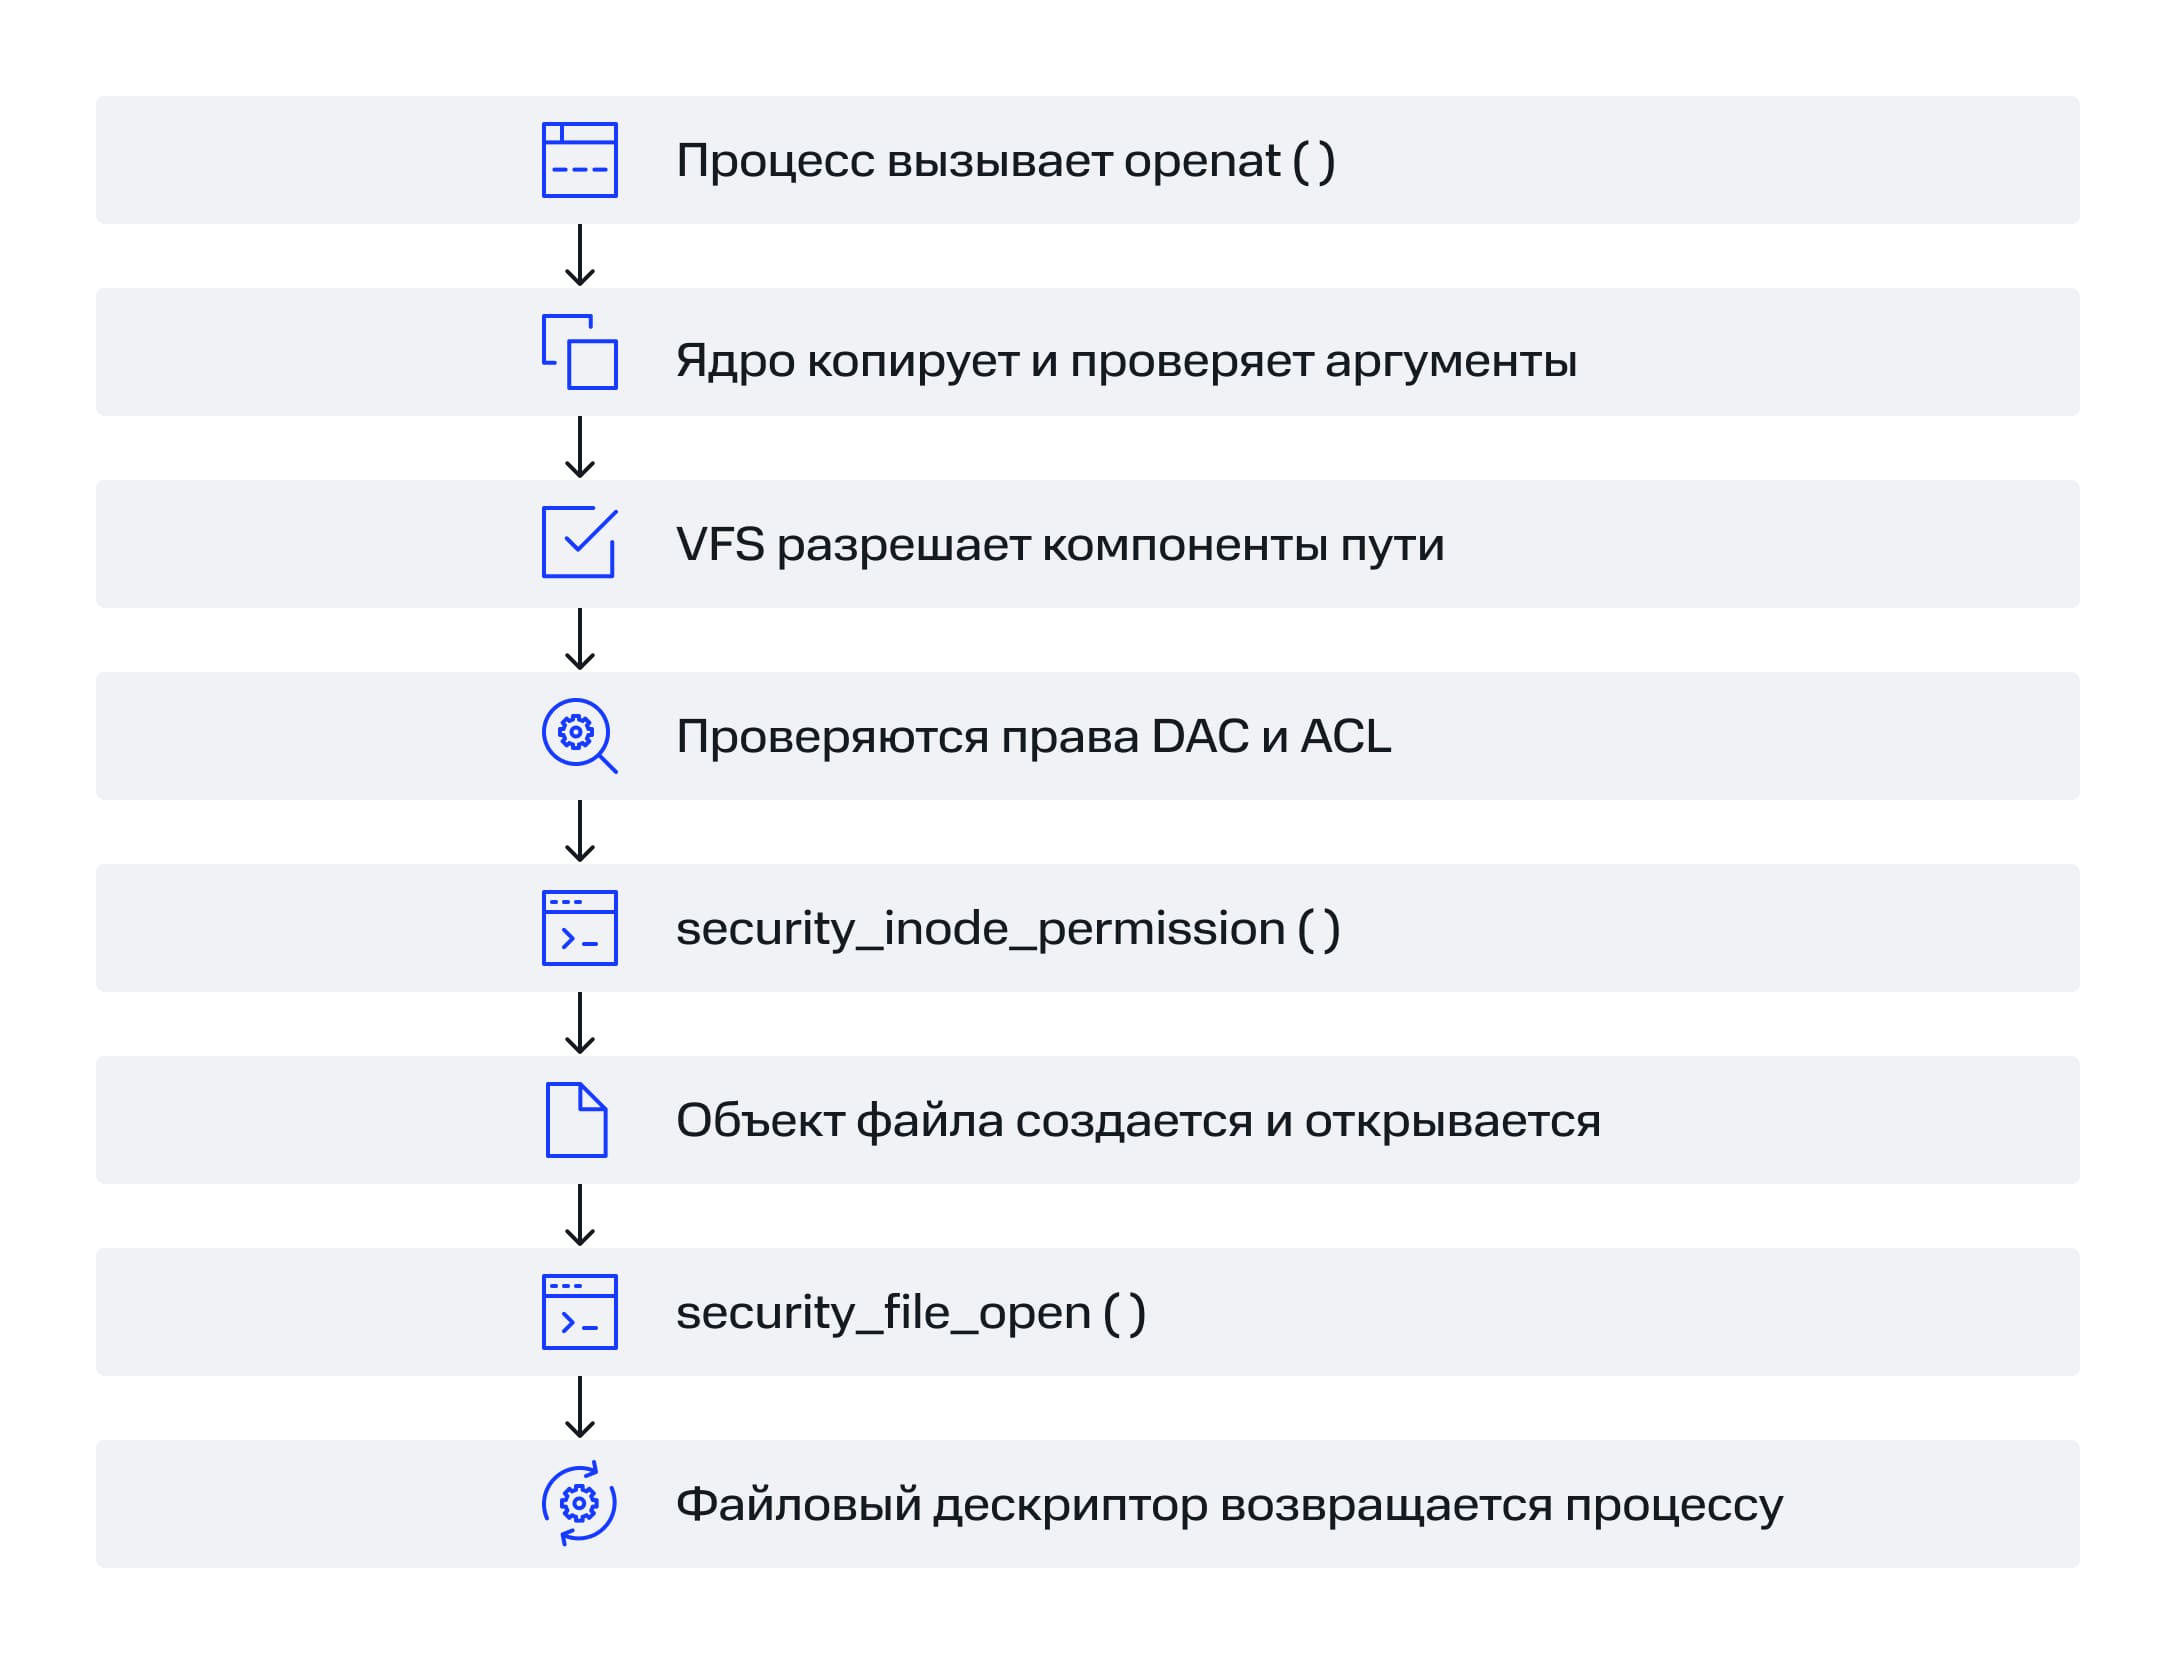
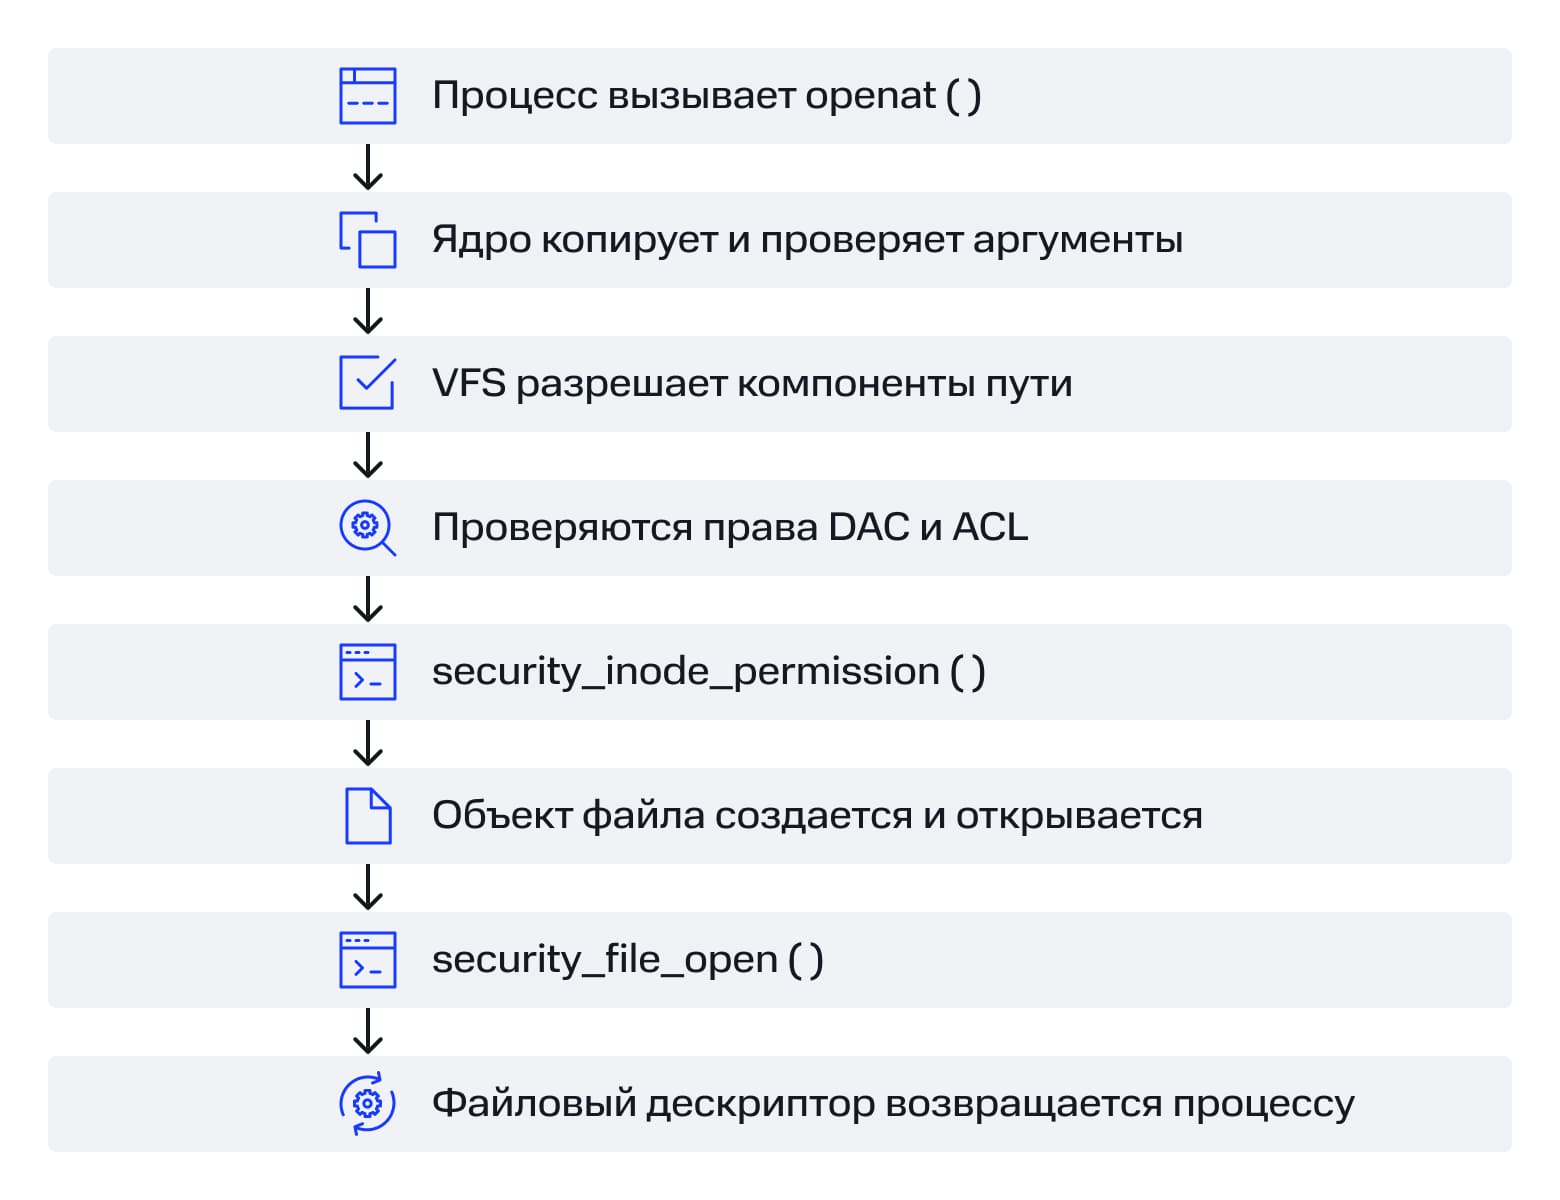
Это общая схема: точный набор и порядок проверок зависят от операции, файловой системы и версии ядра. LSM не заменяет штатную логику VFS, POSIX‑права или capabilities, а дополняет их собственными решениями.
Вызов обработчиков LSM
Большинство контрольных точек представлено функциями семейства security_*(). Эти функции образуют внутренний интерфейс между подсистемами ядра и зарегистрированными модулями безопасности.
Упрощенная реализация такой функции выглядит следующим образом:
int security_inode_permission(struct inode *inode, int mask)
{
    return call_int_hook(inode_permission, inode, mask);
}Функция не содержит политики доступа. Ее задача — передать объект и параметры операции обработчикам, зарегистрированным для hook inode_permission.
Сам модуль объявляет интересующие его точки подключения с помощью LSM_HOOK_INIT():
static struct security_hook_list example_hooks[] __ro_after_init = {
    LSM_HOOK_INIT(inode_permission, example_inode_permission),
    LSM_HOOK_INIT(file_open, example_file_open),
};Во время инициализации список передается инфраструктуре LSM:
security_add_hooks(
    example_hooks,
    ARRAY_SIZE(example_hooks),
    &example_lsmid
);Регистрация самого LSM выполняется через DEFINE_LSM(). В описании указывают идентификатор модуля, функцию инициализации и при необходимости размеры дополнительных данных, которые модуль будет связывать с объектами ядра.
Важно, что классические LSM, как правило, собираются вместе с ядром и активируются во время загрузки. Это не обычные загружаемые модули ядра, которые можно произвольно подключить после запуска системы. Набор и порядок активных LSM зависят от конфигурации сборки.
Принятие решения
Обработчик получает указатели на объекты ядра и сведения о запрошенной операции. Например, inode_permission получает struct inode и маску, содержащую признаки MAY_READ, MAY_WRITE, MAY_EXEC или MAY_APPEND.
Далее модуль сопоставляет субъект, объект и операцию со своей политикой:
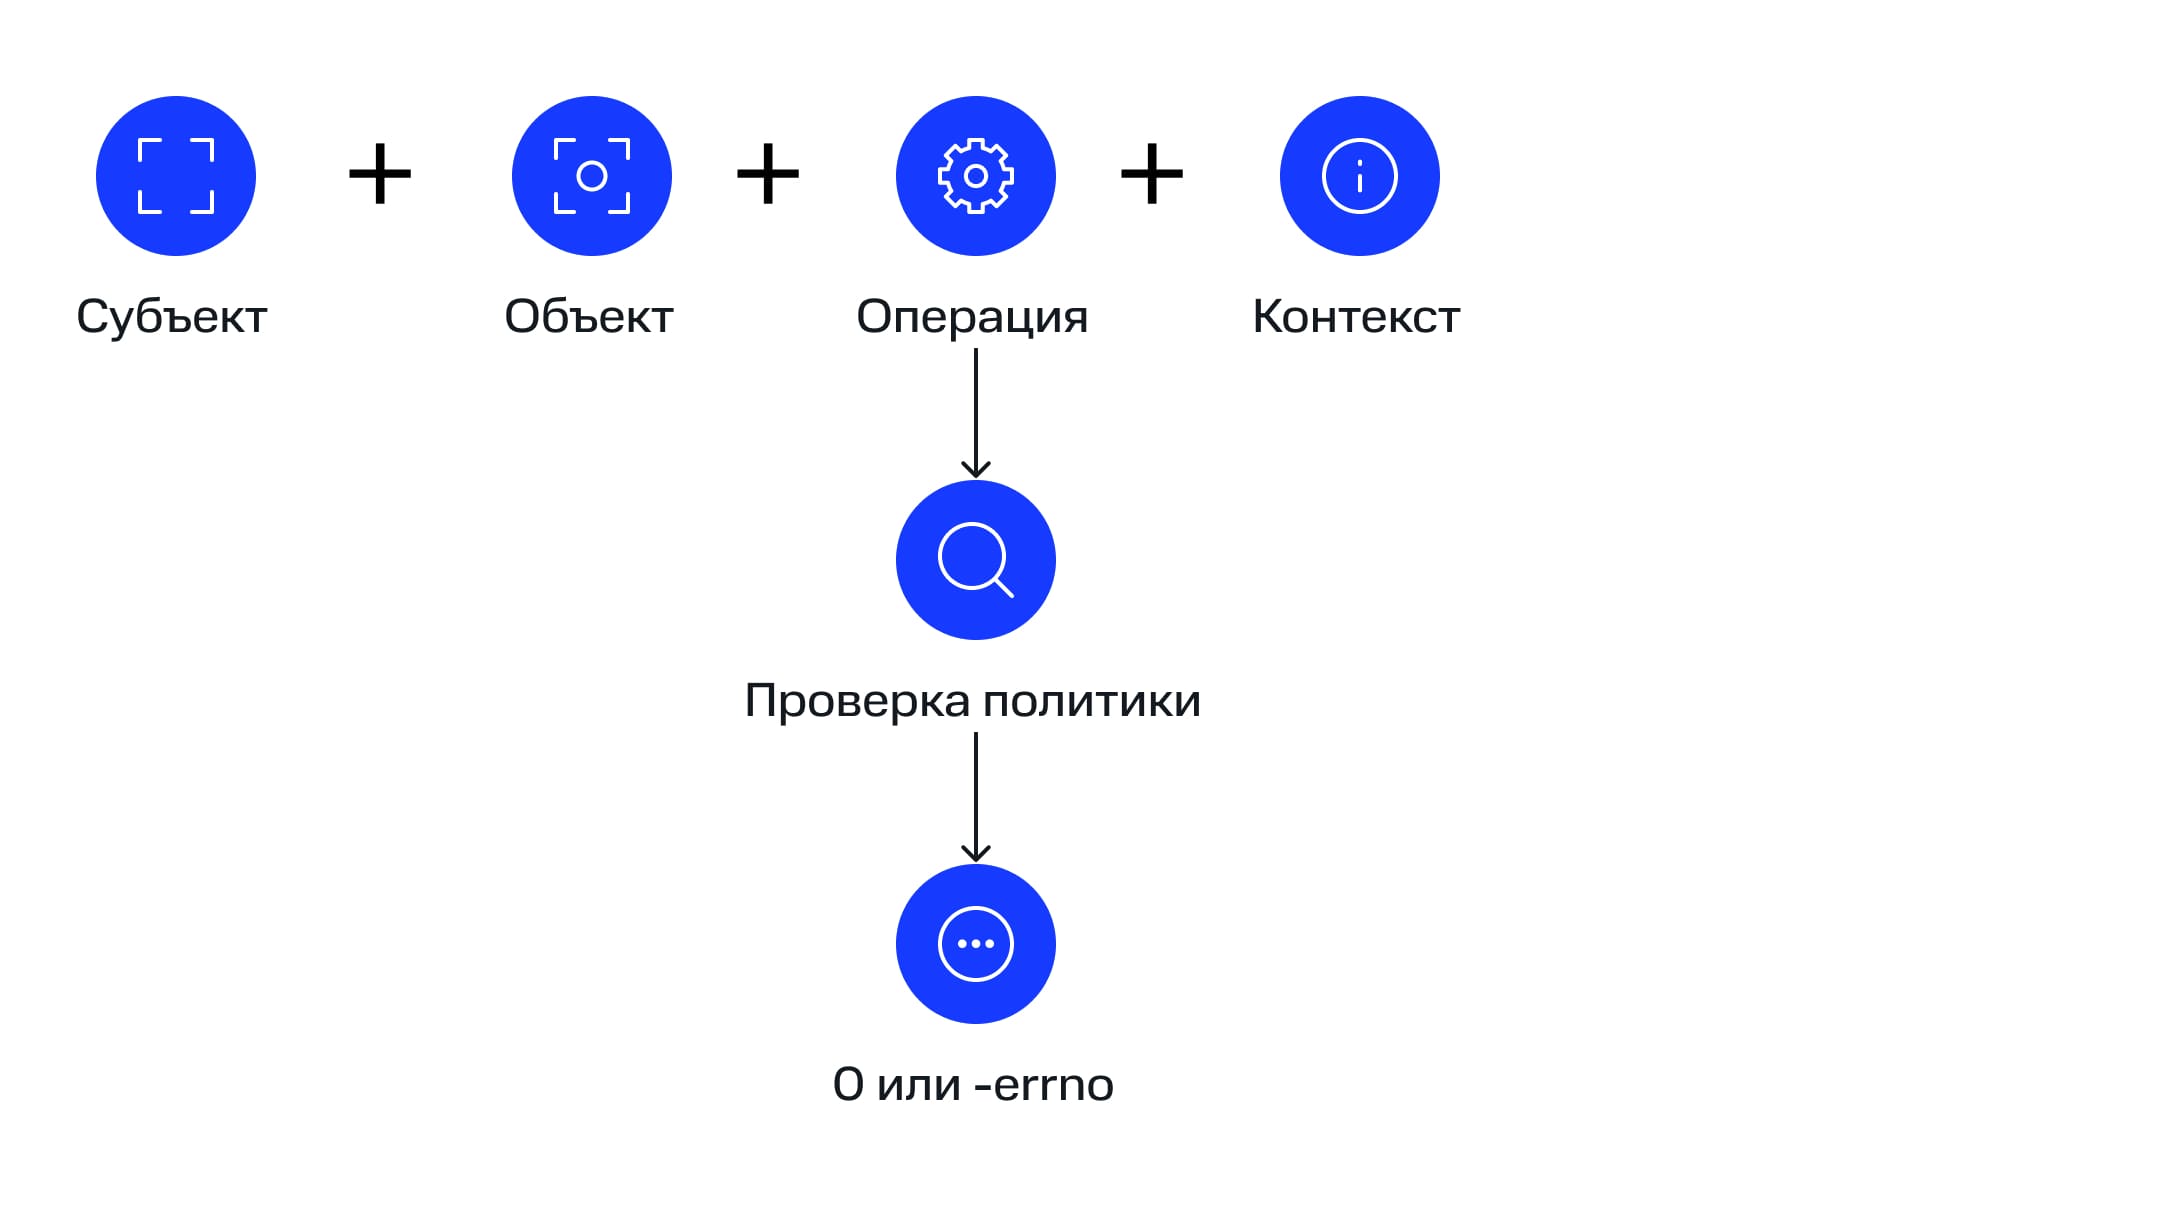
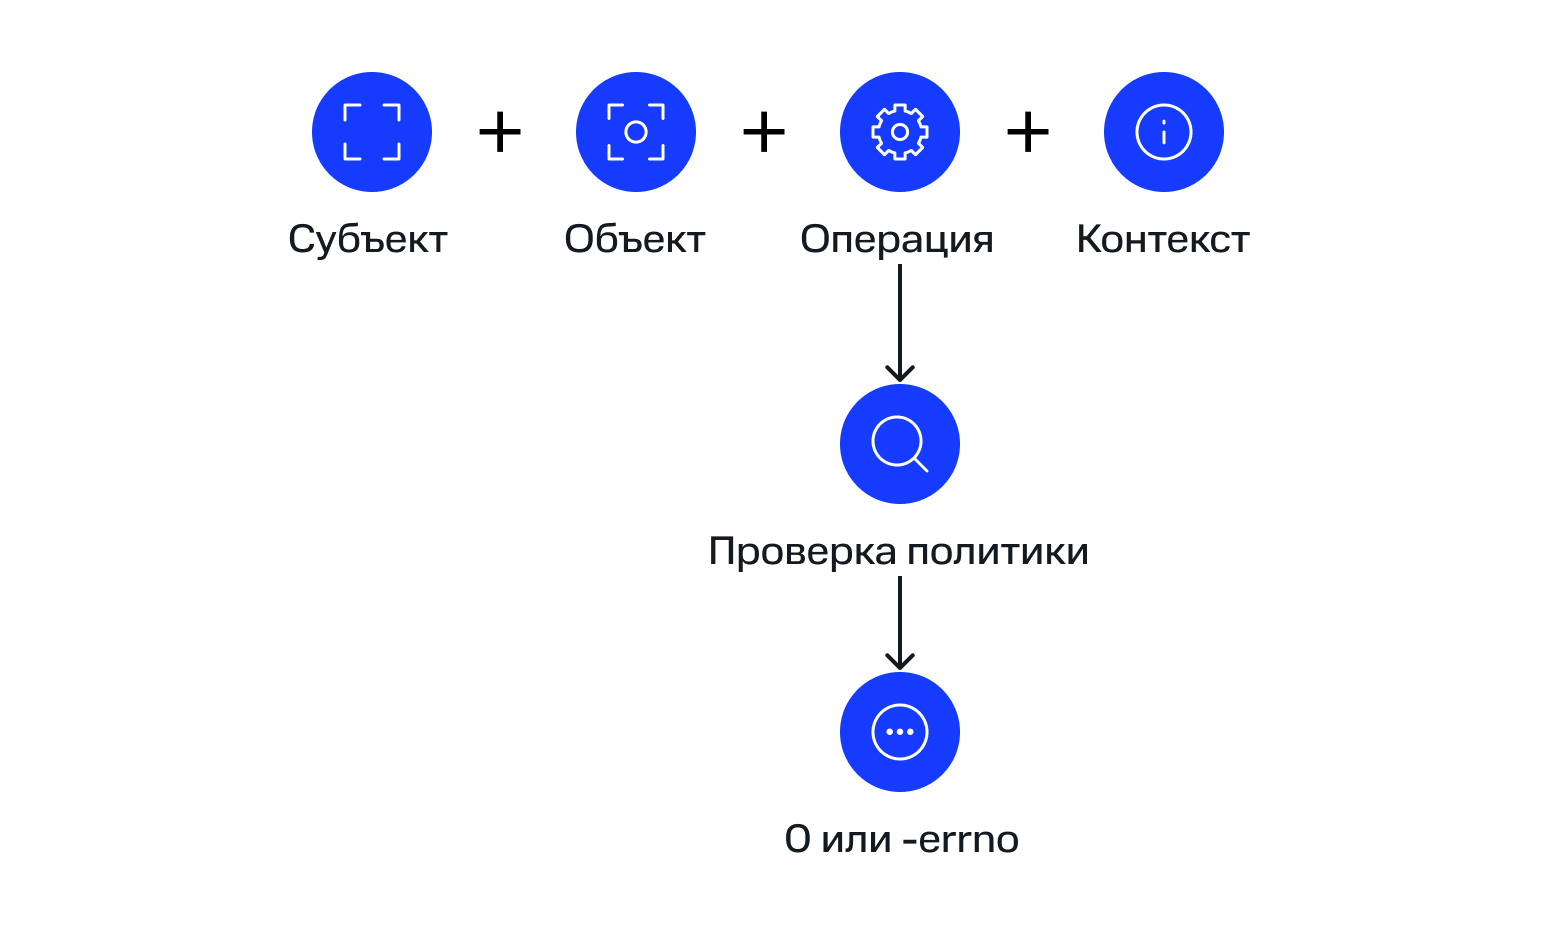
Ноль обычно означает разрешение продолжить операцию. Отрицательный код ошибки, например -EACCES или -EPERM, приводит к отказу. Точная обработка результата определяется конкретным hook: не все точки подключения являются разрешительными, часть из них предназначена для уведомления, инициализации или изменения состояния объекта.
Если для одной точки зарегистрировано несколько LSM, инфраструктура вызывает их обработчики в установленном порядке. Для типичной разрешительной проверки операция продолжается только в том случае, если ни один из задействованных модулей не вернул запрещающий результат. Подробнее о совместной работе модулей расскажем ниже.
Security blobs
Для принятия решения модулю часто недостаточно UID, GID и стандартных полей объекта. SELinux, например, должен хранить идентификатор контекста безопасности, а другие LSM могут использовать собственные метки, флаги и внутреннее состояние.
Для этого служат security blobs — дополнительные области памяти, связанные со структурами ядра. Модуль указывает, сколько памяти ему требуется для каждого поддерживаемого типа объекта, с помощью struct lsm_blob_sizes.
Дополнительные данные могут выделяться:
- для
struct cred— учетных данных процесса; struct task_struct— отдельной задачи, то есть процесса или потока выполнения;struct inode— объекта файловой системы;struct file— открытого файла;struct super_block— смонтированной файловой системы;struct sock— сокета;- объектов IPC;
- ключей ядра;
- BPF‑программ и BPF maps;
- других поддерживаемых ядром объектов.
При одновременной работе нескольких LSM ядро формирует общий blob и резервирует внутри него отдельный участок для каждого модуля:
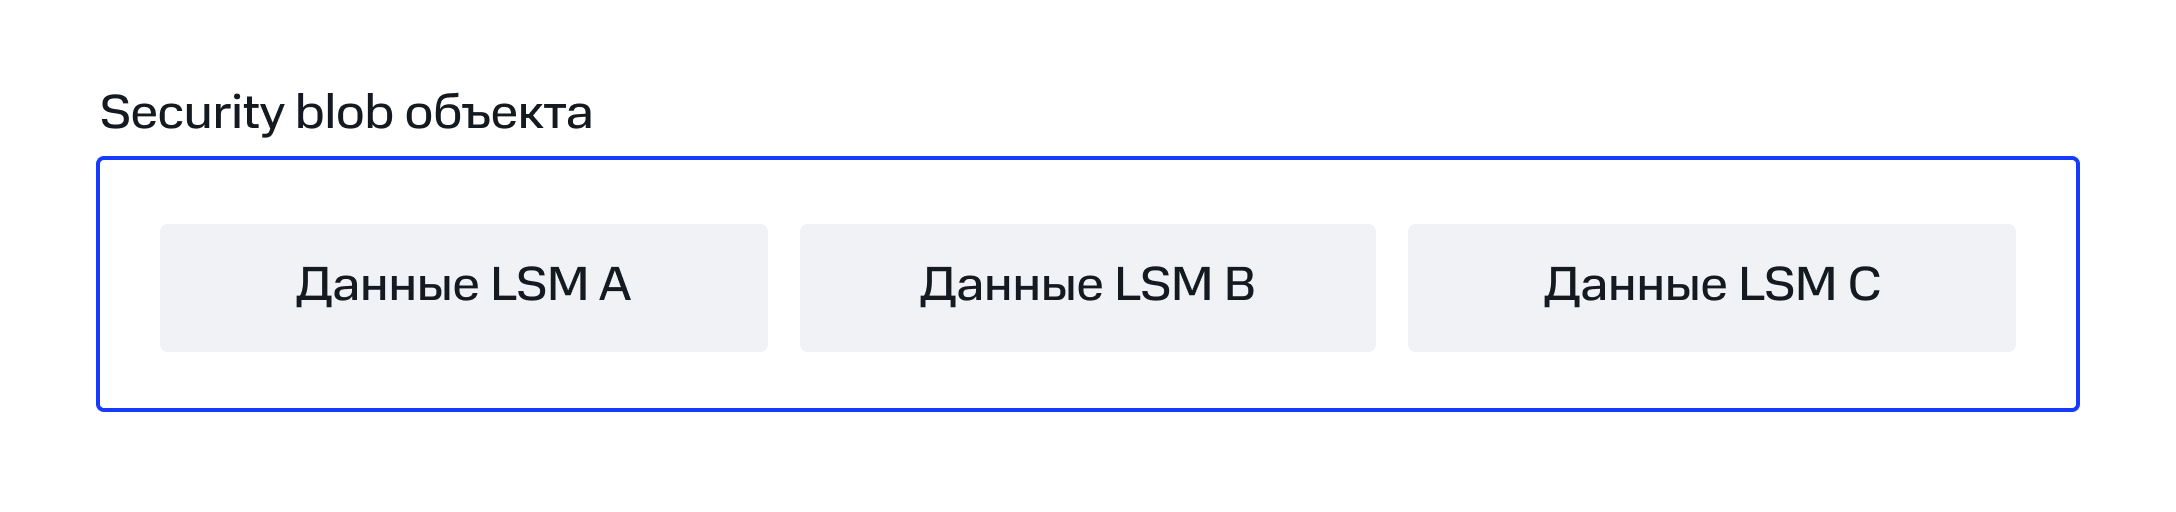
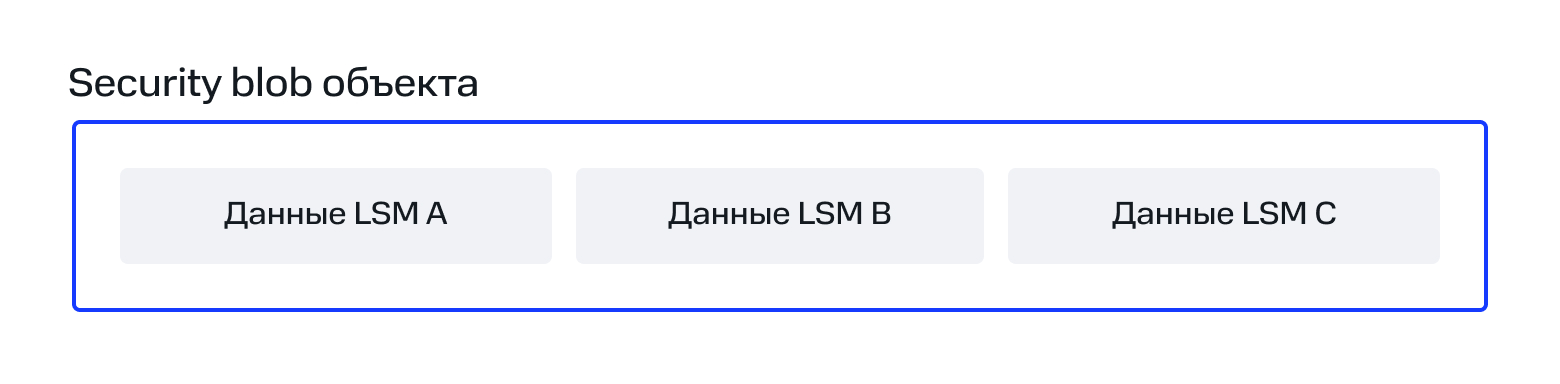
На этапе загрузки инфраструктура рассчитывает размеры и смещения этих участков. Благодаря этому несколько модулей могут хранить собственное состояние в одном объекте, не интерпретируя и не перезаписывая данные друг друга.
Security blob существует только в памяти ядра и не обязательно имеет прямое соответствие данным на диске. Например, постоянная метка SELinux может храниться в расширенном атрибуте security.selinux, а после загрузки inode преобразовываться во внутренний идентификатор и сохраняться в его security blob.
Инициализация и жизненный цикл данных
LSM участвует не только в проверке доступа. Для объектов предусмотрены hooks, вызываемые при их создании, копировании и уничтожении. Они позволяют модулю:
- выделить или инициализировать состояние безопасности;
- наследовать атрибуты от другого объекта;
- назначить метку новому файлу;
- изменить контекст процесса во время
execve(); - освободить связанные ресурсы при удалении объекта.
Например, при создании inode модуль может определить его будущую метку безопасности и подготовить расширенный атрибут до завершения файловой транзакции. Это позволяет избежать промежутка, в котором новый объект уже существует, но еще не получил необходимый контекст безопасности.
Проверка активных модулей
Список активных LSM можно получить через securityfs:
cat /sys/kernel/security/lsm
Пример результата:

Наличие модуля в списке означает, что он зарегистрирован в инфраструктуре LSM. Однако это еще не подтверждает, что его политика включена, работает в принудительном режиме и охватывает необходимые объекты. Например, активный SELinux находится в режиме permissive, а AppArmor — имеет профили только для части процессов.
Поэтому /sys/kernel/security/lsm показывает состав защитного стека, но не его фактическую эффективность. Для полной проверки нужно дополнительно анализировать режим каждого модуля, загруженные политики и события отказа.
Совместная работа нескольких модулей безопасности
Ранние реализации LSM подразумевали, что система должна выбрать один основной модуль: SELinux или AppArmor. Современная архитектура позволяет одновременно регистрировать несколько модулей.
На практике могут совместно работать:
- capabilities;
- SELinux;
- AppArmor;
- Yama;
- Lockdown;
- Landlock;
- BPF LSM;
- модули контроля целостности.
Для каждого hook ядро хранит список зарегистрированных обработчиков. Они вызываются в порядке, определяемом конфигурацией ядра и параметрами загрузки.
Для обычной проверки доступа действует общий принцип: если применимый защитный механизм запрещает операцию, разрешение другого механизма не должно отменять этот отказ.
Например:
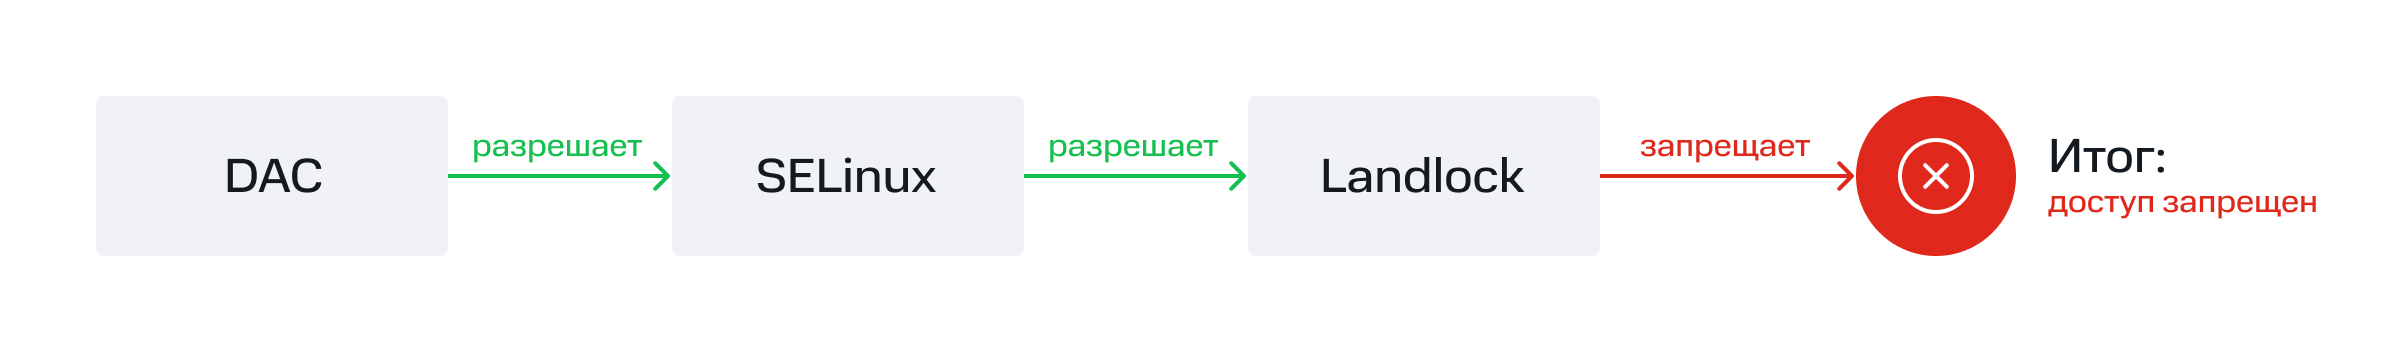
Совместная работа модулей повышает глубину защиты, но усложняет диагностику. Администратор должен определить, какой механизм стал источником отказа. Для этого используют журналы ядра, auditd и специализированные средства анализа политик.
Mandatory Access Control
Mandatory Access Control (MAC) — обязательный контроль доступа, при котором правила задаются централизованной политикой безопасности и не могут быть произвольно изменены владельцем файла или обычным пользователем. В классической модели Discretionary Access Control (DAC) доступ определяется владельцем объекта, группой, правами read, write, execute и ACL. Владелец файла может изменять эти разрешения и передавать доступ другим пользователям. MAC добавляет независимый уровень проверки.
SELinux
SELinux реализует обязательный контроль доступа с помощью политик и меток безопасности. Он работает как модуль LSM и дополняет стандартную модель Linux, основанную на UID, GID, файловых разрешениях и capabilities.
Процессы и системные объекты получают SELinux‑контекст. Обычно он записывается в следующем формате:
user:role:type:level
Например:
system_u:system_r:httpd_t:s0
В большинстве серверных конфигураций основную роль играет поле type. Тип процесса принято называть доменом: веб‑сервер может работать в домене httpd_t, а файлы сайта иметь тип httpd_sys_content_t.
SELinux‑политика сопоставляет:
- домен процесса;
- тип целевого объекта;
- класс объекта, например файл, каталог, сокет или процесс;
- запрошенную операцию.
Упрощенное правило может выглядеть так:
allow httpd_t httpd_sys_content_t:file { open read getattr };Оно разрешает процессу в домене httpd_t открывать и читать файлы типа httpd_sys_content_t, а также получать их атрибуты. Если подходящего разрешающего правила нет, доступ блокируется.
При этом SELinux не заменяет обычные проверки доступа. Сначала ядро применяет файловые разрешения и ACL, а затем проверяет SELinux‑политику. Для успешного выполнения операции ее должны разрешить оба механизма. Если DAC уже запретил доступ, проверка SELinux может вообще не выполняться.
Такой подход ограничивает последствия компрометации приложения. Даже если атакующий получит возможность выполнять команды от имени веб‑сервера, процесс сохранит домен httpd_t и связанные с ним ограничения. Он сможет обращаться только к тем объектам и операциям, которые явно предусмотрены политикой.
При включенном SELinux используются два основных режима:
- enforcing — политика применяется, запрещенные операции блокируются и регистрируются;
- permissive — отказы регистрируются, но операции не блокируются.
Состояние disabled означает, что SELinux отключен и его политика не применяется.
Главная сложность SELinux заключается, прежде всего, не в синтаксисе, а в том, чтобы поддерживать точную модель взаимодействия приложений. Чрезмерно строгая политика нарушает работу системы, а необоснованно широкие разрешения лишают изоляцию смысла. Поэтому за основу обычно берут политики, поставляемые дистрибутивом, а локальные изменения добавляют только для конкретных приложений и нестандартных конфигураций.
AppArmor
AppArmor также реализует обязательный контроль доступа, но строит политику вокруг приложений и доступных им ресурсов. Основная единица — профиль, который загружается в ядро и применяется к процессу при запуске соответствующей программы.
Профиль может определять:
- доступные файлы и каталоги;
- разрешенные способы запуска других программ;
- Linux capabilities;
- сетевые операции;
- взаимодействие через D‑Bus и IPC;
- отправку сигналов и использование
ptrace; - операции монтирования и другие привилегированные действия.
Простейший профиль может выглядеть так:
/usr/local/bin/example {
    /etc/example/**        r,
    /srv/example/**        r,
    /var/log/example/**    rw,

    network inet stream,
    capability net_bind_service,
}Он разрешает программе читать конфигурацию и рабочие данные, записывать журналы, создавать сетевые соединения и использовать capability CAP_NET_BIND_SERVICE. Остальные операции, для которых нет подходящих правил, будут запрещены.
Профиль обычно связывается с путем к исполняемому файлу. При запуске других программ AppArmor может сохранить текущие ограничения, перейти в другой профиль или запретить выполнение. Это позволяет отдельно контролировать основное приложение и запускаемые им вспомогательные процессы. Процессы, для которых профиль не определен или не загружен, остаются в состоянии unconfined. На них действуют обычные механизмы Linux, а дополнительные ограничения AppArmor не применяются.
AppArmor поддерживает два основных режима:
- enforce — запрещенные профильные операции блокируются и регистрируются;
- complain — нарушения регистрируются, но обычно не блокируют работу приложения.
Файловые правила AppArmor во многом основаны на путях. Благодаря этому профиль сравнительно легко сопоставить со структурой приложения: видно, какие каталоги оно читает, куда записывает данные и какие программы запускает. Но такая модель чувствительна к изменениям окружения.
При сопровождении профиля нужно учитывать:
- перенос файлов и изменение структуры каталогов;
- символические и жесткие ссылки;
- bind mounts и пространства имен монтирования;
- временные и динамически создаваемые файлы;
- новые пути, появляющиеся после обновления приложения.
AppArmor не ограничивается файловыми путями: современные профили могут контролировать сеть, capabilities, D‑Bus, сигналы, ptrace, IPC и другие интерфейсы ядра. Тем не менее именно понятная связь правил с конкретным приложением и его файловым окружением — главная особенность этого подхода.
Landlock
Landlock решает более узкую задачу, чем SELinux и AppArmor. Он позволяет приложению ограничить собственный доступ к ресурсам без административных привилегий и без изменения общесистемной политики безопасности.
Приложение формирует набор правил — ruleset, добавляет в него разрешенные ресурсы, а затем применяет ограничения к своему контексту. Для этого используют три основных системных вызова:
landlock_create_ruleset()— создает набор правил.landlock_add_rule()— добавляет разрешение для определенного объекта.landlock_restrict_self()— применяет сформированные ограничения.
Правила Landlock работают по принципу списка разрешений. Приложение указывает, какие категории операций оно собирается контролировать, а затем явно разрешает необходимые действия. Например, процесс может предоставить себе чтение системных библиотек, доступ к конфигурации и запись только в собственный рабочий каталог:
/usr/lib/**          чтение и выполнение
/etc/example/**      только чтение
/var/lib/example/**  чтение и запись
остальная файловая система недоступна
Ограничение применяется к вызывающему потоку и наследуется создаваемыми им процессами.
Процесс не может использовать Landlock, чтобы вернуть ранее запрещенное действие или обойти ограничения SELinux, AppArmor, DAC и других механизмов. Операция будет разрешена только в том случае, если ее допускают все применимые уровни контроля.
Чтобы непривилегированное приложение не смогло получить новые полномочия через setuid‑программу или файловые capabilities, применение sandbox связывается с состоянием no_new_privs.
Также нужно учитывать следующие особенности:
- Приложение должно корректно сформировать и применить
ruleset. - Неподдерживаемые ядром права нельзя считать защищенными.
- Файлы, открытые до активации sandbox, не получают новые ограничения.
- Лишние файловые дескрипторы следует закрыть до применения политики.
- Ограничения должны активироваться до обработки недоверенных данных.
- В многопоточной программе правила нужно согласованно применить ко всем требуемым потокам.
Главное преимущество Landlock: политику можно встроить непосредственно в приложение. Разработчик лучше администратора знает, какие каталоги, порты и операции необходимы программе, и может ограничить их еще до начала основной работы.
Но самоограничение эффективно, когда оно активируется своевременно и не является единственным средством защиты. Landlock дополняет системные политики и механизмы изоляции, но не снимает с администратора ответственность за безопасность всего хоста.
Сравнение подходов и типовые ошибки
SELinux, AppArmor и Landlock используют LSM, но решают задачу по‑разному.
| Критерий | SELinux | AppArmor | Landlock |
|---|---|---|---|
Основная модель |
Метки, типы и домены |
Профили программ и правила ресурсов |
Самоограничение процесса |
Кто задает политику |
Обычно администратор или дистрибутив |
Обычно администратор или дистрибутив |
Само приложение или запускающая среда |
Масштаб |
Система целиком |
Система или отдельные приложения |
Отдельный процесс и потомки |
Сильная сторона |
Глубокая системная модель доступа |
Более наглядная привязка к приложениям |
Непривилегированный sandbox |
Основная сложность |
Проектирование и сопровождение меток и доменов |
Работа с путями и полнотой профилей |
Ограниченный охват |
Типичное применение |
Серверы и среды с формализованной политикой |
Ограничение сетевых и пользовательских приложений |
Самозащита приложения |
Выбор механизма не должен строиться на вопросе, какой из них лучше. Надо определить:
- нужна ли общесистемная политика;
- кто будет ее сопровождать;
- насколько стабильно файловое окружение;
- можно ли изменить приложение;
- какие объекты надо контролировать;
- какие механизмы поддерживает целевой дистрибутив.
В некоторых системах обоснованно используют сразу несколько механизмов, но также нужно учитывать возможные ошибки внедрения этих механизмов:
- включение механизма без проверки охвата;
- постоянный диагностический режим;
- слишком широкие разрешения;
- слепое доверие генераторам политики;
- отсутствие тестирования обновлений.
Защита памяти и противодействие эксплуатации уязвимостей
Типовые ошибки памяти в Linux
Значительная часть ядра Linux и системного программного обеспечения написана на C. Этот язык предоставляет прямой контроль над памятью, но не гарантирует автоматическую проверку границ массивов, времени жизни объектов и корректности указателей.
Типовые ошибки включают:
- запись за границами буфера (buffer overflow);
- чтение за границами объекта (out‑of‑bounds read);
- использование освобожденной памяти (use‑after‑free);
- обращение к неинициализированным данным (use of uninitialized memory);
- ошибки синхронизации (race condition).
Не каждая ошибка приводит к эксплуатации. Процесс может аварийно завершиться, а поврежденные данные не повлияют на управление программой. Но при определенных условиях ошибка позволяет атакующему изменить критические структуры, получить доступ к данным или повлиять на выполнение процесса.
Buffer overflow
Возникает, когда программа записывает данные за границами выделенного буфера. В результате могут быть повреждены соседние переменные, указатели, структуры управления памятью или данные, влияющие на ход выполнения программы.
Атакующий стремится превратить переполнение в управляемую запись. Например, подменить адрес возврата или указатель на функцию, изменить размер объекта либо повредить другую структуру так, чтобы получить выполнение кода, чтение и запись памяти или повышение привилегий. Если управлять поврежденными данными не удается, ошибка обычно приводит к аварийному завершению процесса или ядра.
Защита строится на двух уровнях. Проверка размеров, безопасная работа с памятью, средства вроде FORTIFY_SOURCE помогают обнаруживать или предотвращать саму ошибку. Stack canaries, NX, ASLR и CFI не устраняют переполнение, но затрудняют превращение повреждения памяти в рабочий эксплоит.
Все эти механизмы не универсальные. Canary, прежде всего, защищает управляющие данные стека, NX не мешает использовать уже существующий код, а рандомизация ослабляется при утечке адресов. Поэтому основная мера — устранение выхода за границы буфера.
Use‑after‑free
Появляется, когда программа продолжает использовать объект после освобождения занимаемой им памяти. Указатель формально сохраняется, но соответствующая область уже может быть выделена под другой объект.
Для эксплуатации атакующий пытается повлиять на повторное использование освобожденной памяти. Если на ее месте окажутся контролируемые данные, программа может принять их за поля старого объекта, например указатель на функцию, счетчик ссылок или размер буфера. Это способно привести к повреждению памяти, перенаправлению выполнения или получению дополнительных привилегий.
Противодействие UAF начинается с корректного управления временем жизни объектов: подсчета ссылок, синхронизации доступа и исключения обращения к объекту после его удаления. В ядре для этого применяют блокировки, reference counters, RCU и другие механизмы, соответствующие модели конкурентного доступа. UAF в ядре особенно опасен: повреждение происходит в привилегированном адресном пространстве и дает атакующему возможность воздействовать на всю систему.
Race condition
Возникает, когда результат операции зависит от порядка выполнения нескольких потоков, процессов или обработчиков событий. Уязвимость появляется, если совместное состояние изменяется без достаточной синхронизации.
Распространенный вариант — time‑of‑check to time‑of‑use. Программа сначала проверяет файл или другой объект, а затем выполняет с ним действие. Между этими этапами атакующий может заменить ссылку, изменить объект или добиться его удаления и повторного создания. В результате операция выполняется уже не над тем объектом, который прошел проверку.
Race condition могут приводить:
- к обходу проверки доступа;
- повреждению данных;
- повторному освобождению или UAF;
- выполнению операции с чужими полномочиями;
- повышению привилегий.
Чтобы компенсировать непредсказуемость, атакующий многократно повторяет операцию, выполняет параллельные запросы и создает нагрузку, увеличивающую временное окно.
ASLR и KASLR
ASLR (address space layout randomization) — это рандомизация адресного пространства процесса. Механизм изменяет расположение исполняемого кода, библиотек, стека, heap и отображенных файлов при каждом запуске программы.
KASLR (kernel address space layout randomization) применяет тот же принцип к адресному пространству ядра, изменяя расположение его кода и отдельных областей данных при загрузке системы.
Рандомизация затрудняет эксплуатацию ошибок памяти: атакующий не знает точных адресов объектов, функций и участков кода, необходимых для подмены указателей или построения цепочек выполнения.
Однако ASLR и KASLR не предотвращают повреждение памяти и не являются самостоятельной границей безопасности. Их эффективность снижают:
- утечки адресов;
- недостаточная энтропия;
- повторные попытки;
- предсказуемое размещение отдельных областей;
- уязвимости, позволяющие читать память.
Поэтому рандомизация должна сочетаться с запретом исполнения данных, защитой стека, CFI, строгими разрешениями памяти и предотвращением информационных утечек. Эти механизмы усложняют эксплуатацию, но не заменяют исправление уязвимости.
Изоляция процессов и ограничение воздействия
Namespaces
Linux namespaces изолируют представление системных ресурсов. Процессы, находящиеся в разных namespaces, могут использовать одно ядро, но видеть разные деревья процессов, сетевые интерфейсы, точки монтирования и другие объекты.
Namespace не обязательно запрещает операцию. Он создает отдельный контекст, внутри которого процесс работает с доступной ему частью ресурса. Например, изменение маршрута внутри network namespace не должно изменять таблицу маршрутизации хоста.
Linux поддерживает несколько основных типов namespaces:
- mount — изолирует точки монтирования и правила их распространения;
- PID — предоставляет отдельную нумерацию и иерархию процессов;
- network — изолирует сетевые интерфейсы, маршруты, правила фильтрации и пространство портов;
- IPC — разделяет System V IPC и POSIX message queues;
- UTS — позволяет использовать отдельные hostname и domain name;
- user — создает собственные отображения UID и GID и ограничивает область действия capabilities;
- cgroup — изменяет представление процесса о его положении в cgroup‑иерархии;
- time — позволяет задавать отдельные смещения некоторых системных часов.
Новый namespace может быть создан при запуске процесса с помощью clone() или clone3(). Системный вызов unshare() отделяет процесс от существующего контекста, а setns() позволяет присоединиться к уже созданному namespace при наличии необходимых полномочий.
Принадлежность процесса к namespaces представлена ссылками в каталоге:
/proc/<PID>/ns/
Например:
/proc/1234/ns/net
/proc/1234/ns/pid
/proc/1234/ns/mnt
По этим ссылкам можно определить, какие процессы используют один namespace. Для обзорного просмотра применяют утилиту lsns.
Namespaces лежат в основе контейнерной изоляции. Контейнер может получить собственное дерево процессов, сетевой стек и набор точек монтирования, из‑за чего среда выглядит как отдельная система.
Однако сам namespace не полноценная граница безопасности. Процессы по‑прежнему используют общее ядро, а некорректно переданные файловые дескрипторы, устройства, каталоги хоста или избыточные capabilities могут открыть доступ к ресурсам за пределами предполагаемой среды.
Поэтому namespaces применяют совместно с другими механизмами:
- cgroups ограничивают потребление ресурсов;
- capabilities сокращают привилегии процесса;
- seccomp ограничивает доступные системные вызовы;
- SELinux или AppArmor контролируют операции над объектами;
- файловые разрешения определяют обычные права доступа.
Надежная изоляция возникает не за счет одного namespace, а за счет согласованной настройки всех этих механизмов.
cgroups
cgroups (control groups) — это механизм ядра Linux для иерархической организации процессов, учета потребления ресурсов и установки ограничений.
В cgroup v2 используется единая иерархия. Каждый процесс относится к определенной группе, а создаваемые им потомки изначально наследуют ее. Ограничения применяются сверху вниз: дочерняя группа может получить только часть ресурсов, доступных ее родителю, и не может отменить родительский лимит.
Управление отдельными видами ресурсов выполняют контроллеры:
cpuраспределяет процессорное время.memoryучитывает и ограничивает использование памяти.ioуправляет интенсивностью операций с блочными устройствами.pidsограничивает количество процессов.cpusetзакрепляет выполнение за определенными CPU и NUMA‑узлами.
Настройки представлены файлами в виртуальной файловой системе cgroup:
memory.max
cpu.max
io.max
pids.max
В большинстве современных дистрибутивов cgroups управляются через systemd. Службы, пользовательские сеансы, контейнеры и временные задачи размещаются в отдельных service, scope и slice, которые соответствуют участкам cgroup‑иерархии.
Но cgroups не контролируют доступ к данным. Лимит памяти не запрещает чтение файла, а ограничение CPU не мешает вызвать опасный системный интерфейс. Кроме того, не все ресурсы ядра одинаково полно учитываются контроллерами, а ошибочные лимиты могут вызвать отказ самого приложения.
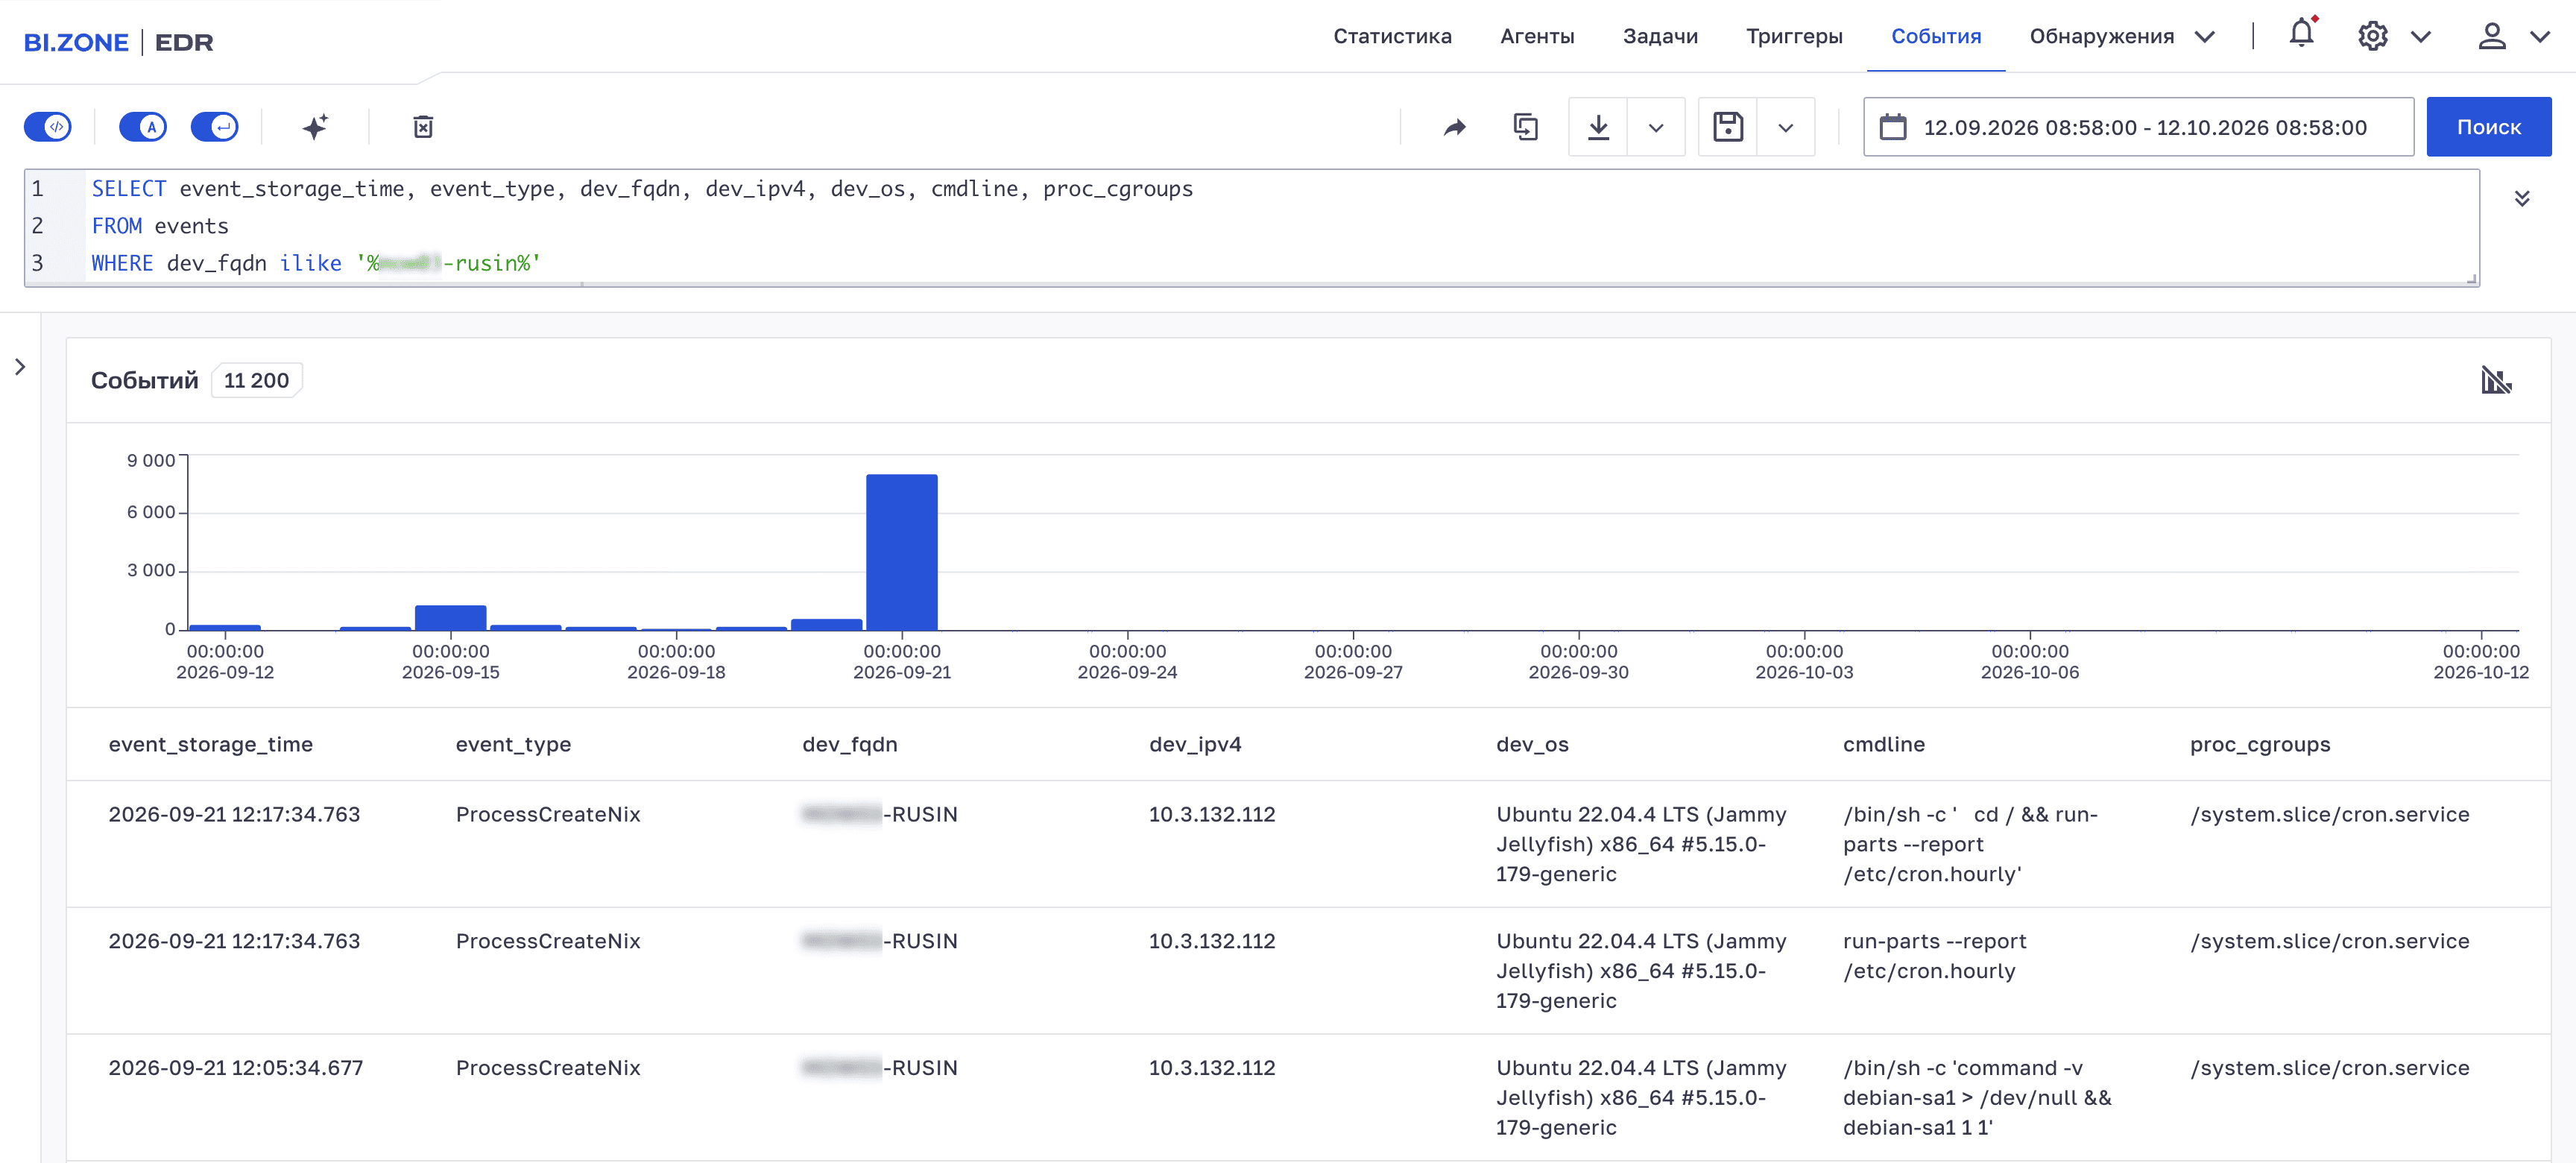
BI.ZONE EDR собирает данные о пути к директории с настройками cgroup процесса:
Seccomp
Seccomp (Secure Computing) ограничивает интерфейс системных вызовов, доступный процессу. Его основная задача — сократить поверхность ядра, которую может использовать приложение или захвативший его злоумышленник.
В режиме фильтрации процесс загружает BPF‑фильтр, который выполняется перед системным вызовом. По результатам проверки фильтр может:
- разрешить системный вызов;
- вернуть приложению заданную ошибку;
- отправить сигнал
SIGSYS; - завершить поток или весь процесс;
- записать событие в журнал;
- передать запрос пользовательскому обработчику.
Например, сервису, который только принимает сетевые запросы и читает файлы, не нужны mount(), ptrace(), bpf() или создание новых namespaces. Их блокировка не устраняет уязвимость в самом сервисе, но лишает атакующего части возможностей после компрометации.
Фильтр обычно устанавливают через seccomp() или prctl(). Непривилегированный процесс должен предварительно активировать no_new_privs, чтобы ограничения нельзя было использовать вместе с последующим получением дополнительных привилегий.
Если политика разрешает fork(), clone() и execve(), дочерние процессы наследуют установленный фильтр. Дополнительные фильтры могут усиливать ограничения, но не возвращать уже заблокированные возможности.
Заключение
Защита Linux строится не вокруг одного универсального механизма, а вокруг нескольких уровней, каждый из которых ограничивает определенную часть атаки.
LSM предоставляет ядру точки применения политик безопасности, а SELinux и AppArmor используют их для обязательного контроля доступа. Landlock переносит часть этой модели на уровень приложения и позволяет процессу сократить собственные полномочия. Средства защиты памяти не устраняют программные ошибки, но затрудняют их превращение в выполнение кода или повышение привилегий.
Namespaces, cgroups и seccomp решают другие задачи. Namespaces формируют изолированное представление ресурсов, cgroups ограничивают их потребление, а seccomp сокращает набор доступных системных вызовов.
Надежная защита появляется, когда компрометация одного уровня не дает атакующему полный контроль над системой. Уязвимое приложение может оказаться ограниченным собственным доменом, не видеть процессы хоста, не иметь доступа к административным системным вызовам и не располагать ресурсами для воздействия на соседние службы.
Для этого нужно соблюдать несколько принципов:
- предоставлять процессам только необходимые полномочия;
- скрывать или изолировать ненужные ресурсы;
- сокращать доступную поверхность ядра;
- ограничивать последствия ошибок и компрометации;
- применять независимые механизмы защиты на разных уровнях;
- регулярно проверять, что ограничения действуют.
Но предотвращение и сдерживание атаки — только часть задачи. Даже правильно настроенная политика может оказаться неполной, а легитимная учетная запись — скомпрометированной. Поэтому важно не только запрещать опасные действия, но и сохранять достаточно информации для их обнаружения и расследования. C этим поможет BI.ZONE EDR, который собирает всю необходимую телеметрию с устройств под управлением Linux.
Следующая статья нашего цикла будет посвящена контролю и наблюдаемости. Мы рассмотрим аутентификацию и управление идентификацией, PAM и NSS, Linux Audit Framework, системные журналы, контроль целостности и наблюдение с помощью eBPF. Фокус сместится от предотвращения атаки к ее выявлению: как понять, что защитную границу проверяют, пытаются обойти или уже нарушили.